Z-Image, quelle version choisir ? Quatre noms annoncés, deux à télécharger
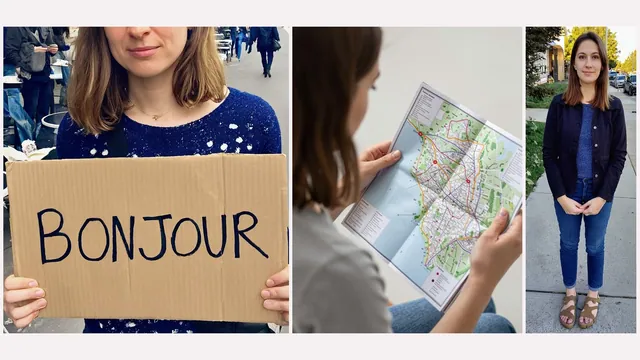
Une seule main. Je zoome sur la carte du plan « deux mains » : le Turbo la tient à deux mains, le témoin aussi, et la base n'en montre qu'une. Bon. Ce n'est pas le plus grave de cette classe. Z-Image, sur le papier, c'est quatre élèves : un Turbo, une base, une « Omni-Base » et un « Edit ». À l'appel, il y en a deux. Les deux autres sont toujours marqués « À paraître ». J'ai passé les présents sur nos six photos du banc, avec un modèle d'une autre famille comme témoin, et voici qui fait quoi, pour combien, et sous quelle licence.
Comparatif, page de famille du catalogue. Pages officielles relevées le 26/10/2026 ; nos tests du 25/10/2026 sur Runpod, une NVIDIA L40S. Page mise à jour à chaque nouveau test de la famille.
 MilkyCelle qui teste · Image, vidéo et ComfyUI
Vérifié par une 2e IA
En bref
- L'éditeur annonce quatre versions, mais seules deux ont des poids téléchargeables au 26/10/2026 : Z-Image Turbo, sorti le 26/11/2025, et Z-Image, la « base », sortie le 27/01/2026. Z-Image-Omni-Base et Z-Image-Edit restent marquées « À paraître ».
- Chez nous, sur la même carte : 7,9 s et 0,0024 $ par image pour le Turbo en 8 étapes, 34,6 s et 0,0105 $ pour la base en 25 étapes et sans prompt négatif, un réglage plus court que celui de l'éditeur, qui conseille 28 à 50 étapes et un négatif. Les deux écrivent « BONJOUR » sans faute ; face à cette base en réglage court, le Turbo réussit la nuit et les deux mains, la base gagne la scène de café.
- Tout est sous licence Apache 2.0, sans plafond de chiffre d'affaires. En bf16, les deux modèles pèsent exactement le même poids, 12,31 Go ; les versions allégées (int8, nvfp4) viennent de Comfy-Org, pas de l'éditeur.
Quelle version pour quoi
| Version | Où en est-elle | Ce qu'en dit l'éditeur | Réglage de l'éditeur | Chez nous |
|---|---|---|---|---|
| Z-Image Turbo | Poids publiés le 26/11/2025 | Version distillée, rapide, bonne en photo réaliste et en texte anglais et chinois | 8 passages du modèle, sans guidage | 7,9 s, 0,0024 $ ; nuit et deux mains réussies |
| Z-Image (base) | Poids publiés le 27/01/2026 | Non distillée, guidage complet, prompt négatif, « a good base for LoRA training » | 28 à 50 étapes, CFG 3 à 5 | 34,6 s, 0,0105 $ en 25 étapes ; une seule main sur la carte |
| Z-Image-Omni-Base | Annoncée, « To be released » | Génération et retouche, point de départ « raw » pour la communauté | 50 étapes, avec CFG | Pas de poids à tester |
| Z-Image-Edit | Annoncée, « To be released » | Retouche d'image sur instruction écrite | 50 étapes, avec CFG | Pas de poids à tester |
Une image vite : le Turbo. Entraîner un LoRA (un petit fichier d'appoint qui apprend un style ou un visage au modèle), piloter au prompt négatif : la base, que l'éditeur destine à l'affinage. Retoucher une photo : pas dans cette famille aujourd'hui, Edit n'a pas de poids. Le duel détaillé, chiffres en main, est dans Z-Image ou Z-Image Turbo ?, à paraître le 04/11.
L'appel, élève par élève
L'éditeur range ses quatre versions dans un tableau qui dit à quelle étape de l'entraînement chacune s'arrête. Omni-Base n'a que le pré-entraînement. Z-Image ajoute un affinage supervisé (« SFT »). Le Turbo ajoute encore de l'apprentissage par renforcement (« RL »). Edit a le pré-entraînement et le SFT, comme Z-Image. La famille est annoncée à « 6B » paramètres, avec une architecture « Single-Stream DiT » où le texte et l'image entrent dans le modèle comme une seule suite. Pour les deux modèles publiés, l'API de Hugging Face compte 6 154 908 736 paramètres, le même nombre.
Z-Image Turbo, le pressé. L'éditeur le présente comme « Une version distillée de Z-Image », qui fait son image en « 8 NFEs », c'est-à-dire huit passages du modèle. Le tour de magie a un nom, « Decoupled-DMD », présenté comme « l'algorithme central de distillation en quelques étapes » du modèle à 8 étapes, puis « DMDR », qui mélange cette distillation et l'apprentissage par renforcement. Le README les résume en quelques lignes et renvoie, pour le détail, à deux articles de recherche que je n'ai pas lus : je n'en dirai pas plus. Ce qui compte pour toi : pas de guidage, « La guidance devrait être à 0 pour les modèles Turbo », donc pas de prompt négatif non plus.
Z-Image, la base. « Le modèle de fondation derrière Z-Image-Turbo », dit l'éditeur. Elle est « undistilled », supporte le guidage complet (« full Classifier-Free Guidance ») et « Répond avec une haute fidélité au prompting négatif ». Sa fiche la vend pour l'exploration et le développement : plus de variété d'une graine à l'autre, et une bonne base pour les LoRA et les ControlNet. En échange, il lui faut entre 28 et 50 étapes.
Z-Image-Omni-Base, l'annoncée n° 1. « capable à la fois de tâches de génération et d'édition », et pensée comme le point de départ « le plus « brut » » pour l'affinage par la communauté. Pas de poids au 26/10/2026 : le tableau de l'éditeur dit « À paraître », et le compte Hugging Face Tongyi-MAI ne contient que deux modèles Z-Image, Z-Image-Turbo et Z-Image ; ses trois autres modèles ne sont pas de cette famille.
Z-Image-Edit, l'annoncée n° 2. « Une variante affinée sur Z-Image spécifiquement pour les tâches d'édition d'images ». Même statut : « À paraître » dans le README, aucun dépôt chez Tongyi-MAI, ni sur Hugging Face ni sur GitHub. Le blog de l'éditeur, lui, dit le contraire : voir l'encadré plus bas.
Autour de la famille, d'autres comptes. Le compte Hugging Face « alibaba-pai », qui n'est pas celui de l'éditeur, publie des ControlNet « Fun Union » pour le Turbo et pour la base, qui guident l'image par des contours, une profondeur ou une pose. Il publie aussi un LoRA qui fait tourner la base en 2, 4 ou 8 étapes, « pas pour remplacer Z-Image-Turbo », précise sa page. Pas testé.
Qui publie, et sous quelle licence
L'éditeur. Les dépôts sont au nom de « Tongyi-MAI », sur Hugging Face et sur GitHub. Le blog officiel signe « Z-Image Team, Tongyi MAI, Alibaba Group ».
La licence : Apache 2.0, pour tout ce qui existe. Les deux fiches Hugging Face la déclarent dans leur en-tête (« license: apache-2.0 »), mais leurs dépôts ne contiennent pas de fichier de licence. Le texte complet est sur le GitHub de l'éditeur, et c'est mot pour mot celui de la fondation Apache. En deux phrases : tu peux utiliser, modifier et redistribuer, gratuitement, dans le monde entier, y compris pour vendre quelque chose, sans seuil de chiffre d'affaires (« perpetual, worldwide, non-exclusive, no-charge, royalty-free »). Si tu redistribues, tu joins la licence, tu gardes les mentions d'origine et tu signales les fichiers que tu as modifiés ; et la licence ne donne aucun droit sur les noms et marques de l'éditeur. Le détail, clause par clause, est dans la fiche Z-Image. Les dépôts Comfy-Org et alibaba-pai déclarent eux aussi « apache-2.0 ».
Les fichiers : officiels, repackagés, allégés
L'éditeur publie au format Diffusers, en plusieurs morceaux. Le compte Comfy-Org reprend les mêmes modèles en fichiers uniques, « Fichiers de modèle réempaquetés pour ComfyUI », et ajoute des versions allégées.
| Ce qu'on télécharge | Turbo | Base |
|---|---|---|
| Dépôt de l'éditeur, modèle d'images | 24,62 Go, en F32 | 12,31 Go, en BF16 |
| Dépôt de l'éditeur, tous les poids (avec encodeur et décodeur) | 32,83 Go | 20,52 Go |
| Comfy-Org, bf16 | 12,31 Go | 12,31 Go |
| Comfy-Org, int8 | 6,20 Go | 6,20 Go |
| Comfy-Org, nvfp4 | 4,51 Go | n'existe pas |
| Encodeur de texte qwen_3_4b, plein / fp8 / fp4 | 8,04 / 5,63 / 3,48 Go, le même pour les deux | |
| Décodeur d'image (ae) | 0,34 Go, « the Flux 1 VAE » selon les exemples de ComfyUI |
Tailles en gigaoctets (milliards d'octets), notre calcul d'après les octets publiés par Hugging Face le 26/10/2026.
- Pas de version allégée chez l'éditeur. Les seuls fichiers int8, nvfp4, fp8 et fp4 sont ceux de Comfy-Org. Leurs pages ne disent ni ce que ces formats changent à l'image, ni quelle carte il faut pour le nvfp4. Le modèle de workflow Comfy-Org pour le Turbo en int8 charge l'encodeur en fp8.
- Ce que ça fait sur ton disque, notre calcul : 20,69 Go pour un seul des deux modèles en bf16 avec son encodeur et son décodeur, 33,00 Go pour les deux, puisqu'ils partagent encodeur et décodeur ; 12,17 Go en int8 avec l'encodeur fp8 ; 8,32 Go pour le Turbo en nvfp4 avec l'encodeur fp4. On n'a fait tourner que le bf16.
- La mémoire. L'éditeur écrit que le Turbo « fits comfortably within 16G VRAM consumer devices » ; rien de propre à la base, et son blog parle de « moins de 16 Go de VRAM » sans dire pour quelle version. Chez nous, le journal de ComfyUI prépare exactement la même charge pour les deux modèles d'images, 11 738 Mo, plus 7 671 Mo pour l'encodeur. Ce n'est pas un pic mesuré : on ne l'a pas mesuré.
- Un dernier fichier mystère : le dépôt Comfy-Org du Turbo contient un « z_image_turbo_distill_patch_lora_bf16 » de 0,16 Go, dont la page n'explique pas le rôle.
Comment on a testé
Le banc commun du catalogue : six photos du quotidien écrites en anglais, la même femme « à la fin de la vingtaine avec des cheveux bruns jusqu'aux épaules », graine 2210, 1152 × 1536, un tirage par prompt, aucun LoRA, le 25/10/2026 sur un pod Runpod (lien parrainé) avec une NVIDIA L40S louée 1,09 $/h et ComfyUI 0.42.0. Les réglages sont ceux des modèles de workflow Comfy-Org : 8 étapes et CFG 1 pour le Turbo, 25 étapes et CFG 4 pour la base, sans prompt négatif. Pour la base, c'est sous la fourchette de l'éditeur, qui conseille 28 à 50 étapes et un prompt négatif « Strongly recommended ». Garde-le en tête en regardant ses images et chaque point qu'elle perd plus bas : c'est la base en réglage court qui perd, pas la base telle que l'éditeur la règle.
Le témoin, c'est Krea 2 Turbo, d'une autre famille, passé le même jour sur le même pod avec les mêmes prompts : 8 étapes et CFG 1, comme le Turbo de Z-Image, mais en fichiers fp8. Il est là pour situer, pas pour gagner (sa fiche).
La galerie
Z-Image : les six photos du banc, version par version
Banc du 25/10/2026 sur Runpod, une NVIDIA L40S à 1,09 $/h, ComfyUI 0.42.0, graine 2210, 1152 × 1536, un tirage par prompt, réglages des modèles Comfy-Org, aucun LoRA. Temps par image, de l'envoi à l'image rendue (la première image de chaque modèle comprend le chargement) ; prix = notre calcul (durée × prix horaire de la carte). Plusieurs images sont recadrées (tenue, façades, voitures, mot inventé sur une carte), deux téléphones ont l'objectif légèrement flouté et une image est écartée : c'est dit sous chaque image.
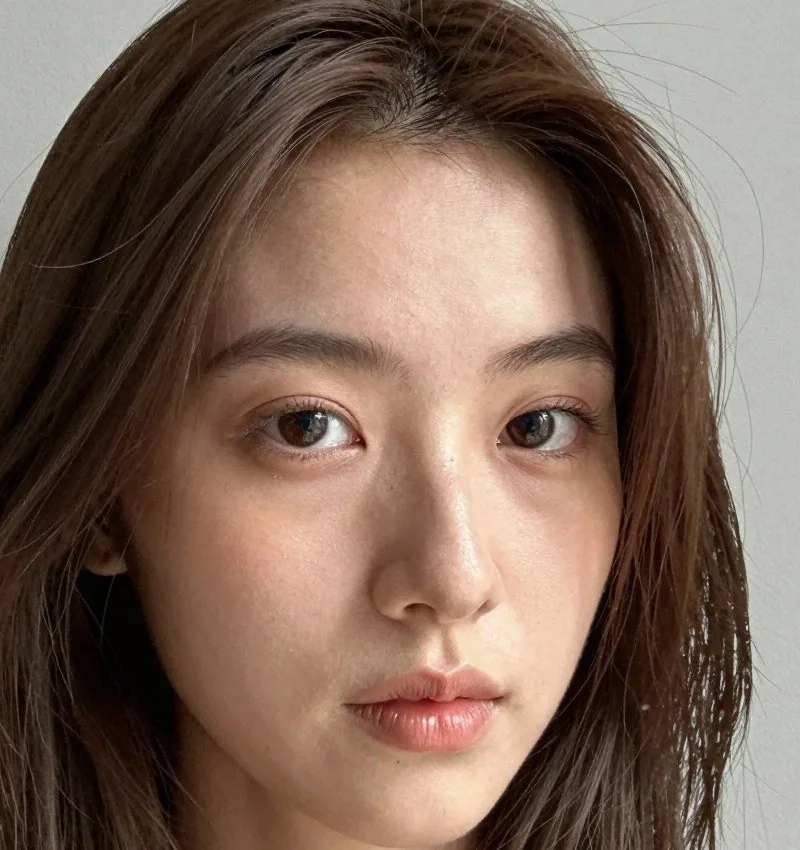
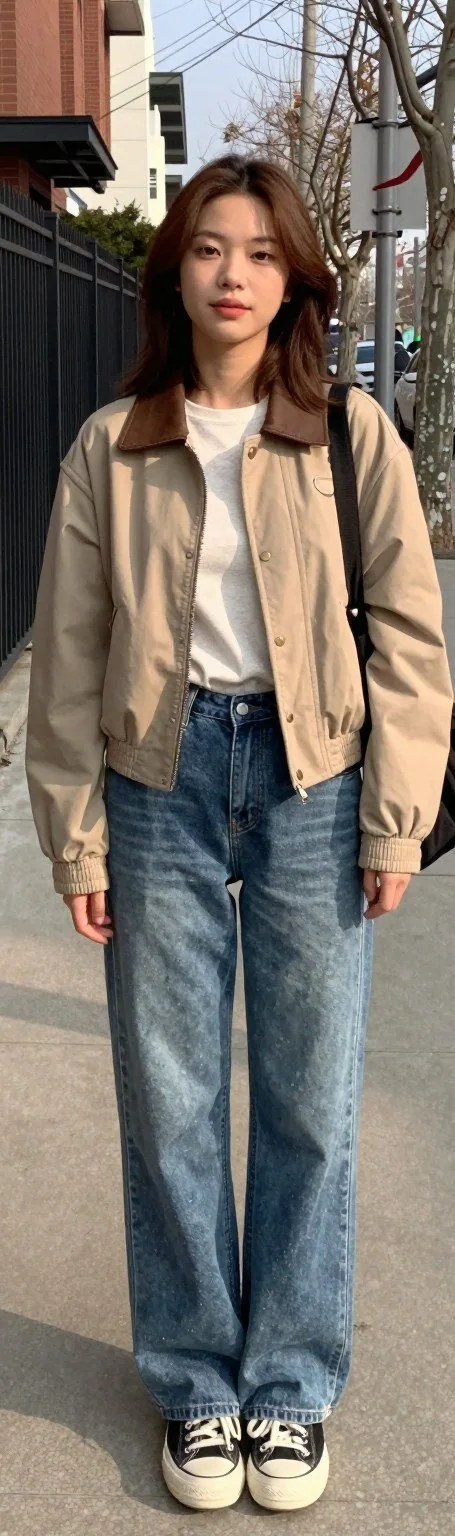
Z-Image Turbo bf16 · 8 étapes, CFG 1, sans négatif · 7,9 s et 0,0024 $ par image
Portrait
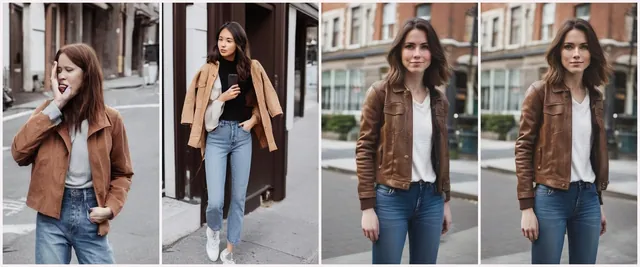
Visage net, peau lisse et lèvres brillantes, mais aucun vêtement visible.
En pied
De la tête aux baskets, comme demandé.
Deux personnages
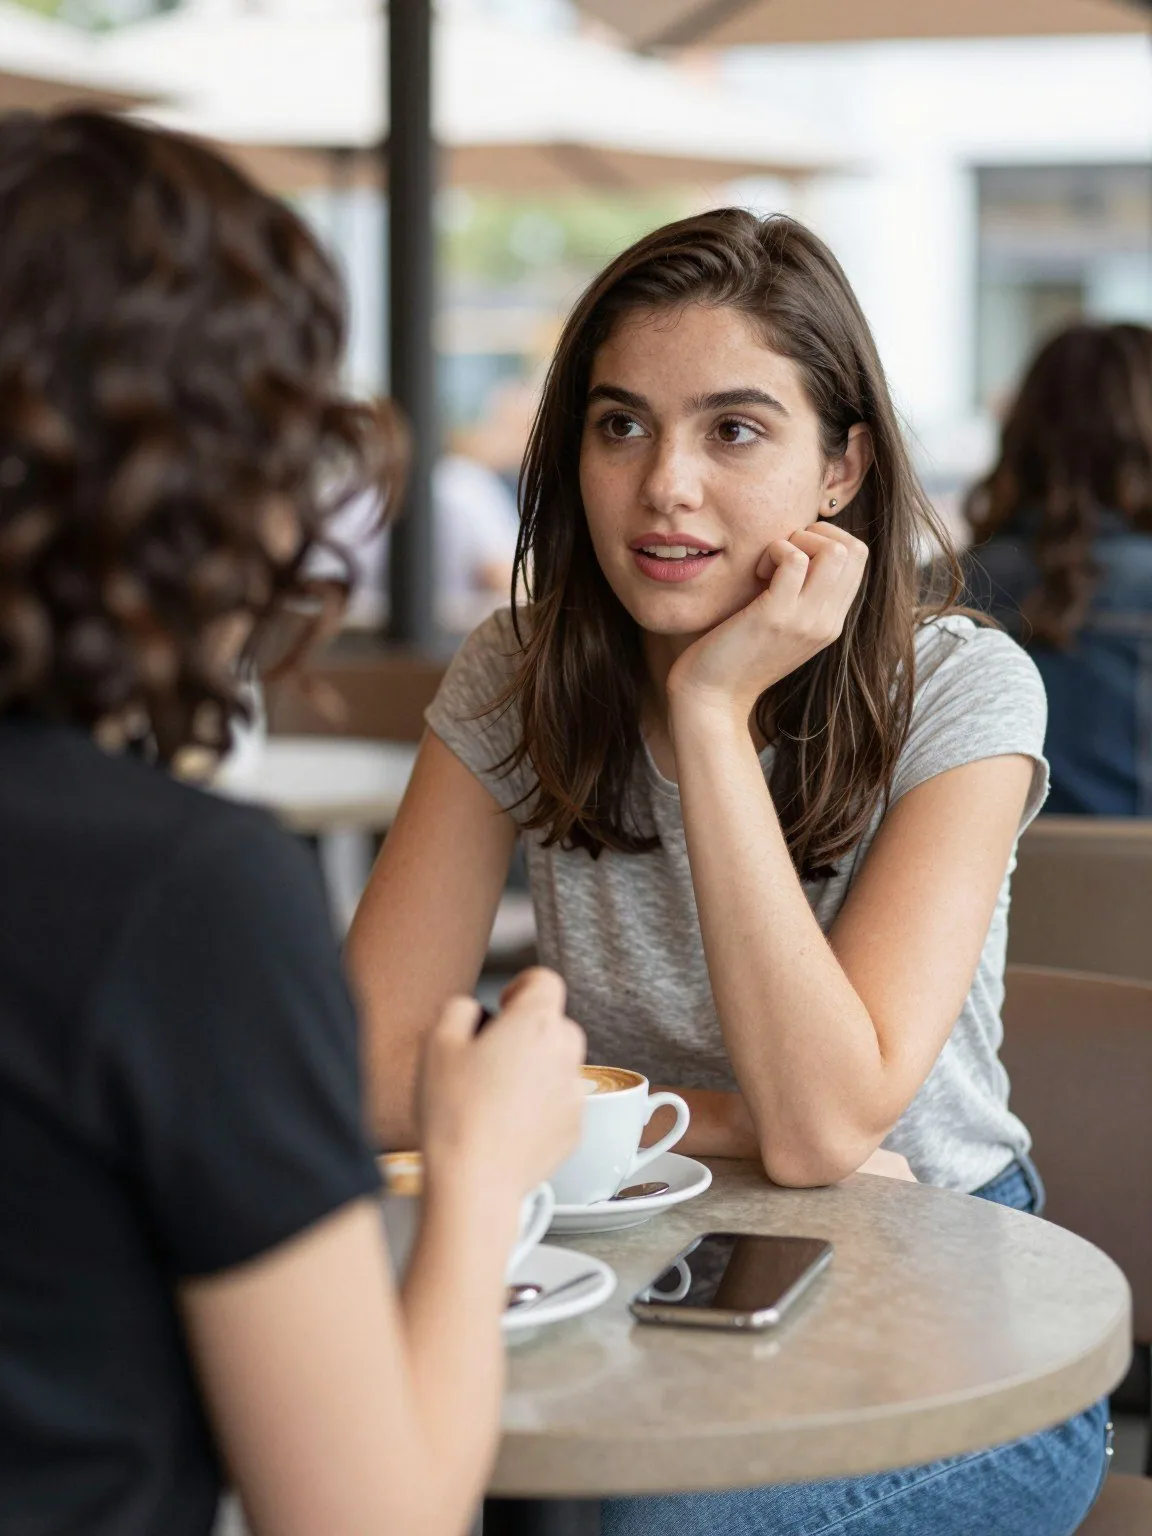
Deux personnes et deux tasses ; l'amie a des boucles mi-longues, pas courtes.
Mains et objet
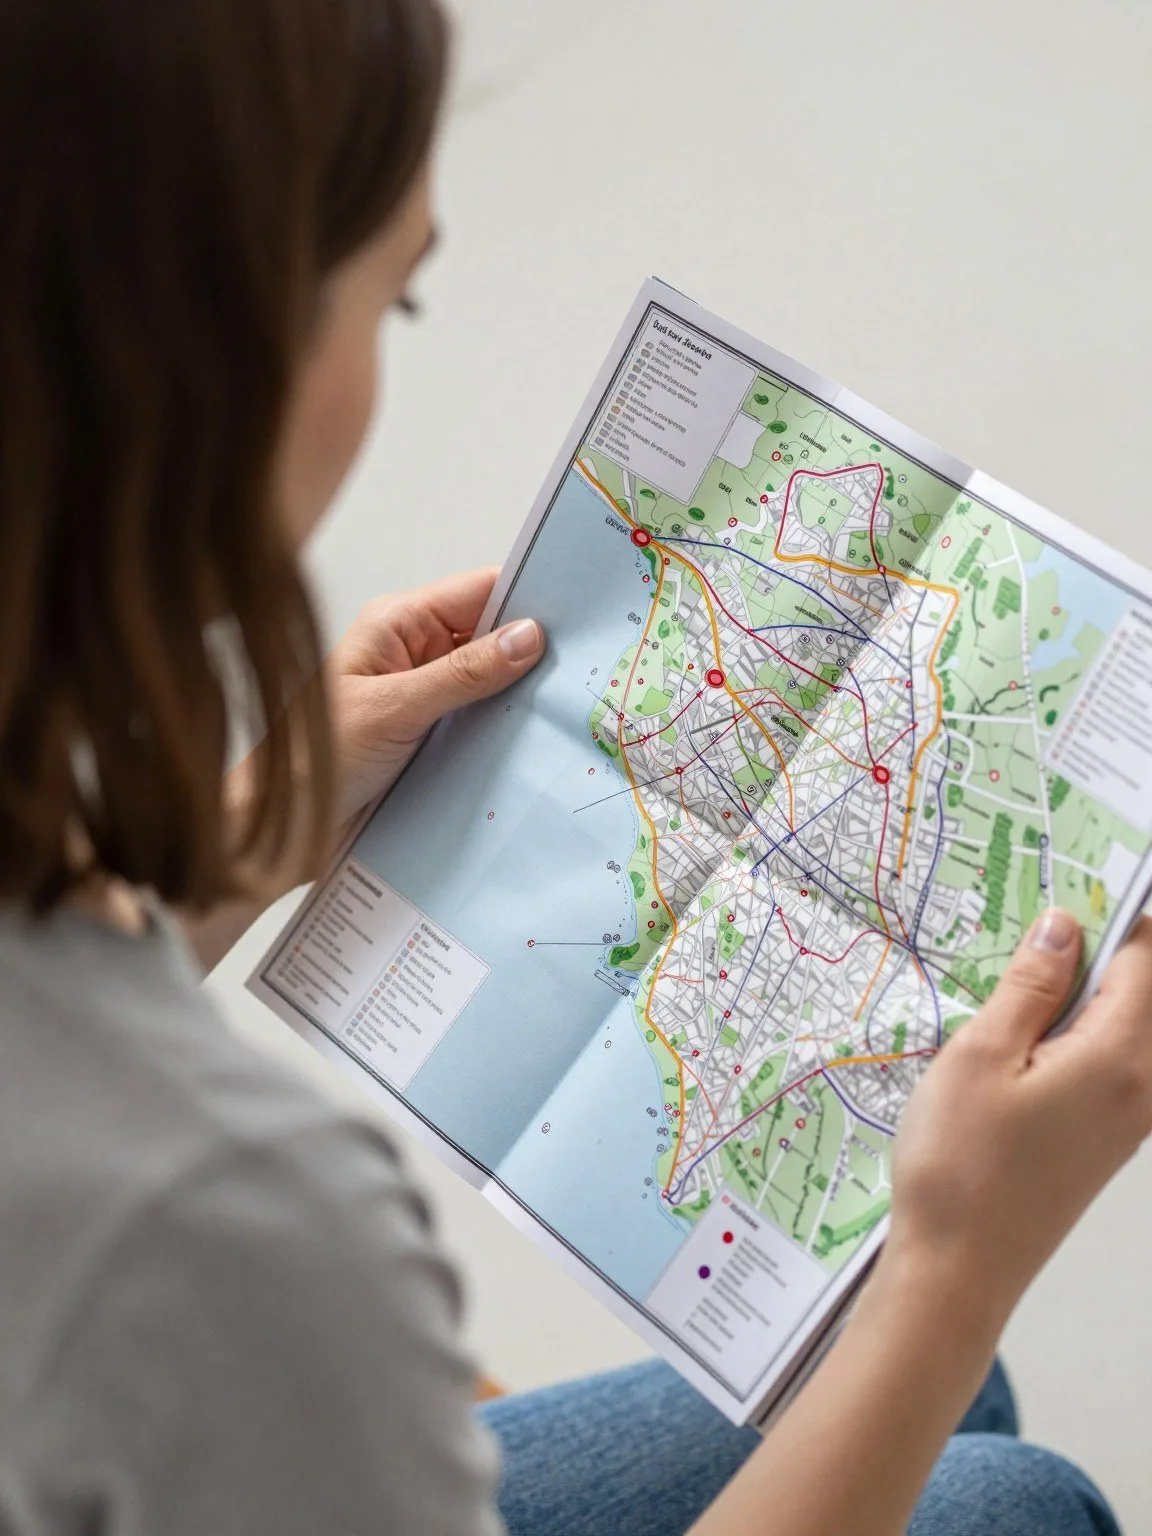
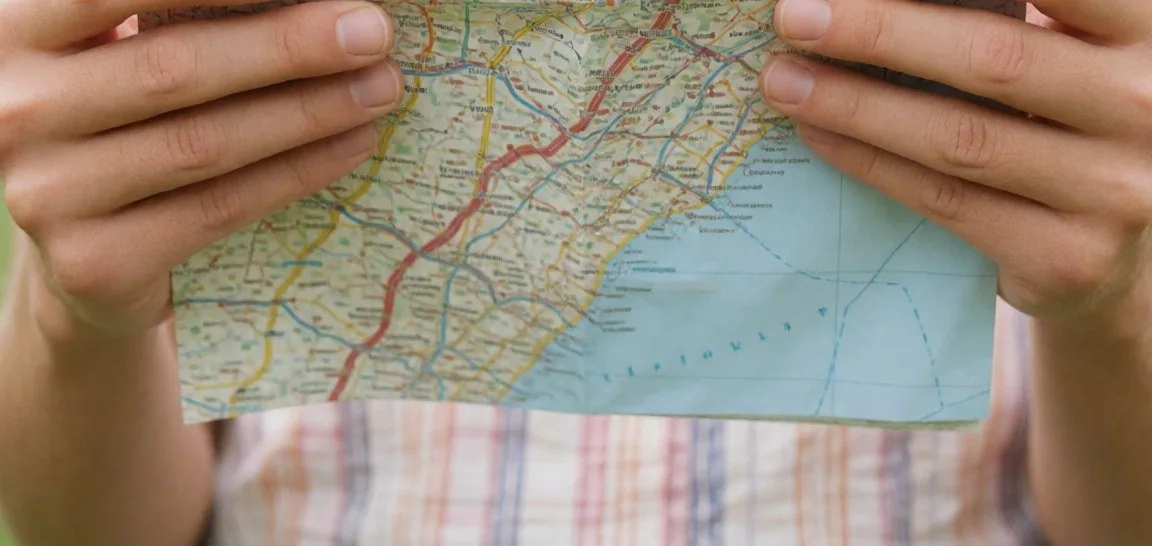
Les deux mains sur un plan de ville, cadrage par-dessus l'épaule.
Nuit
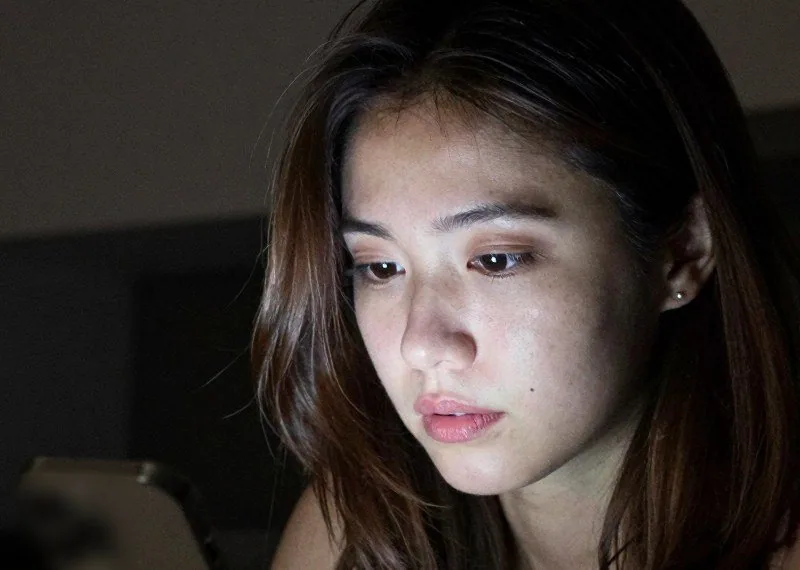
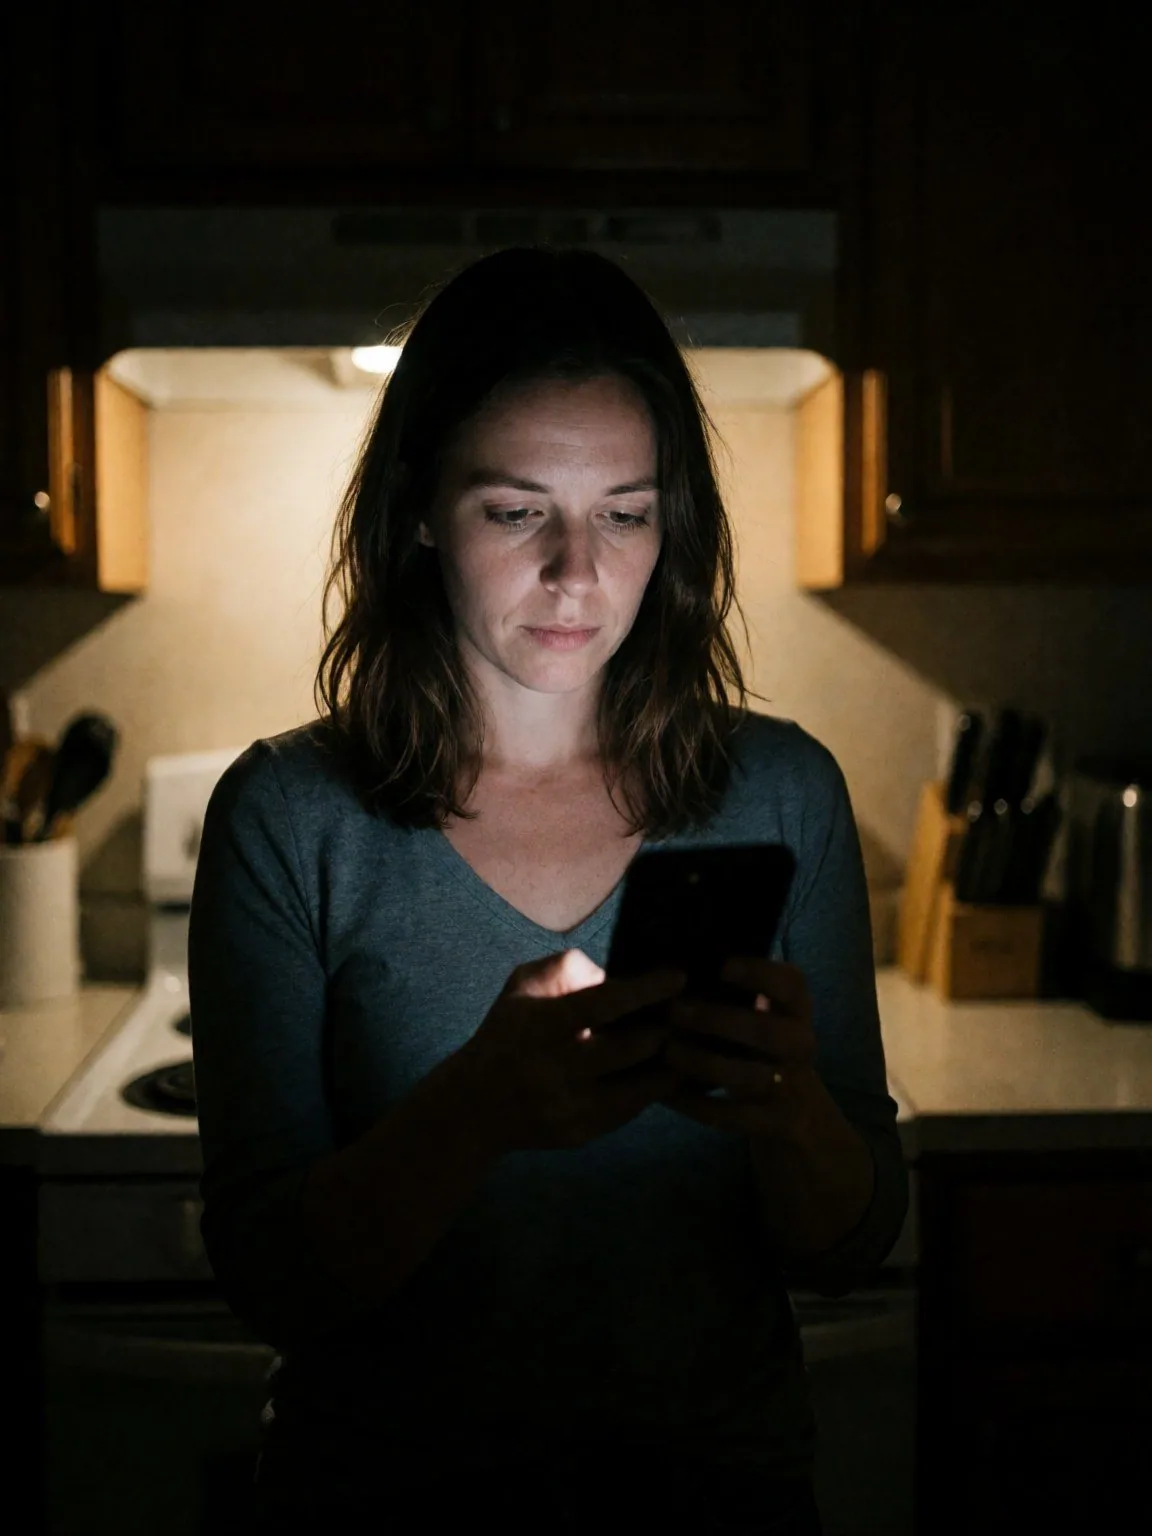
Le visage est vraiment éclairé par l'écran : réussi.
Texte dans l'image
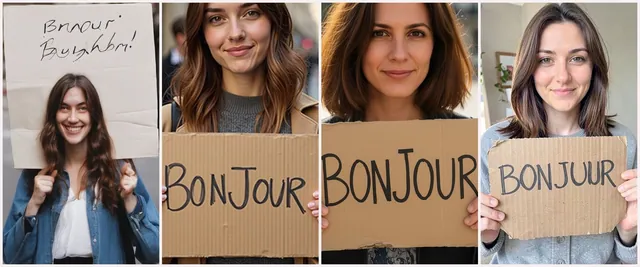
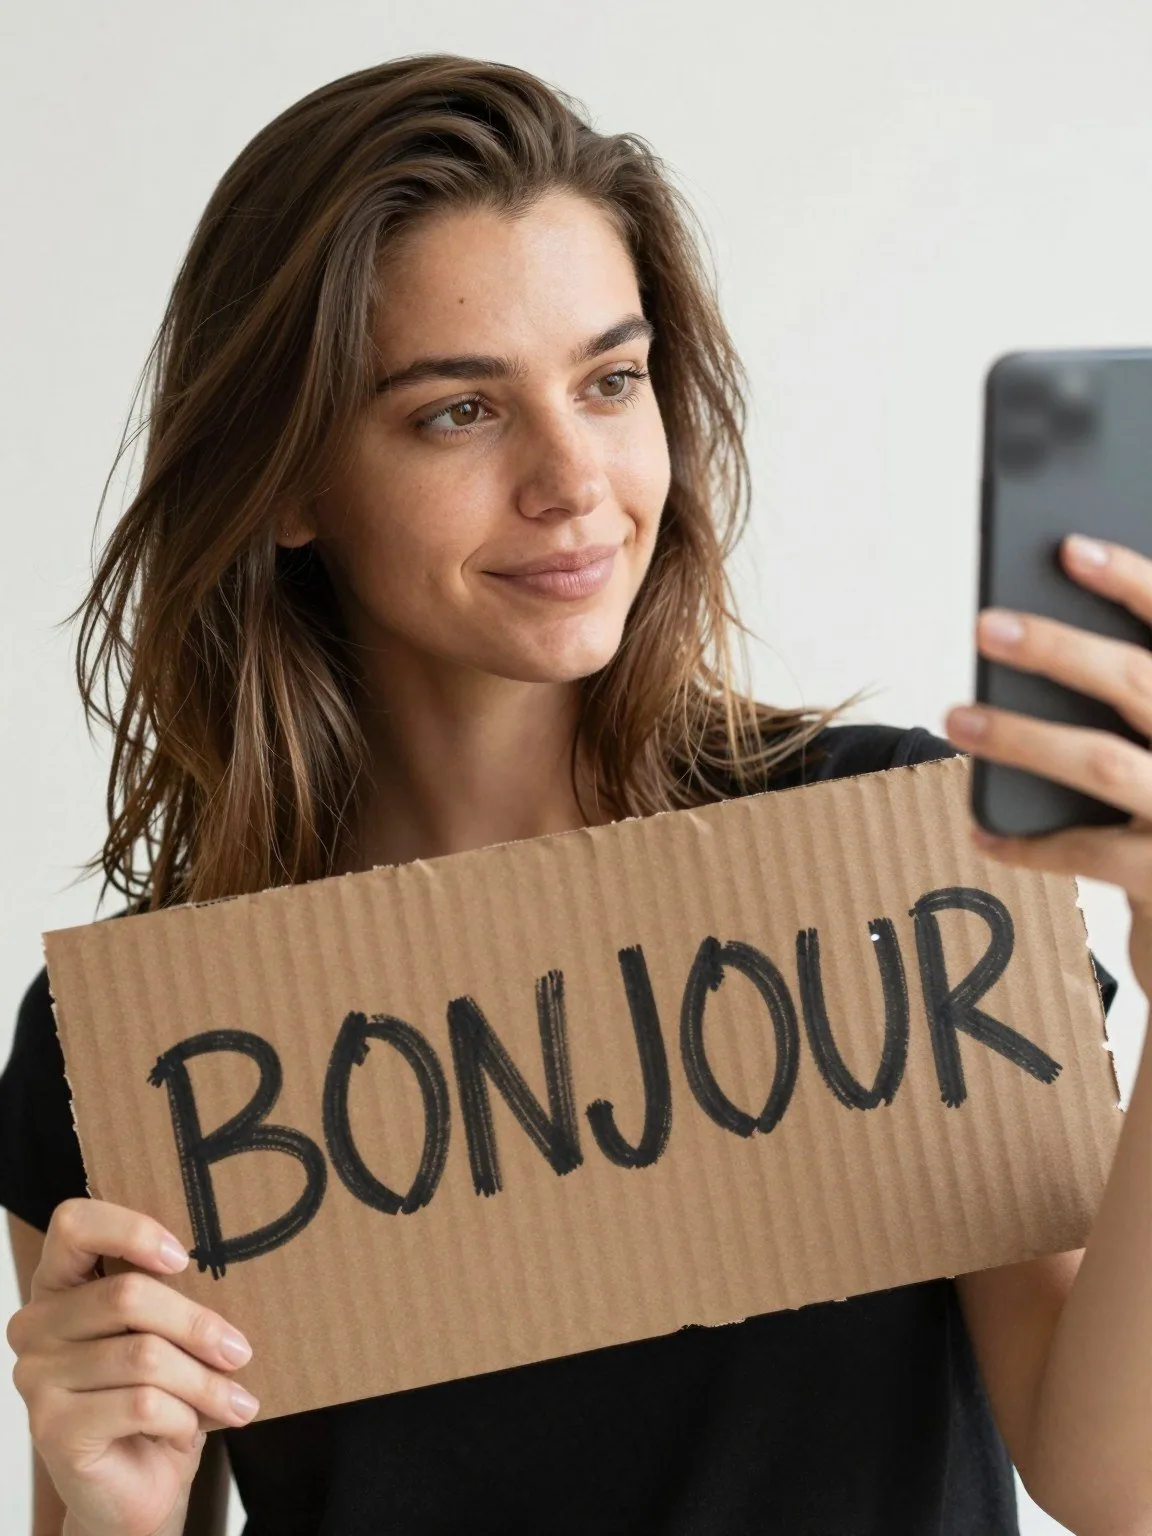
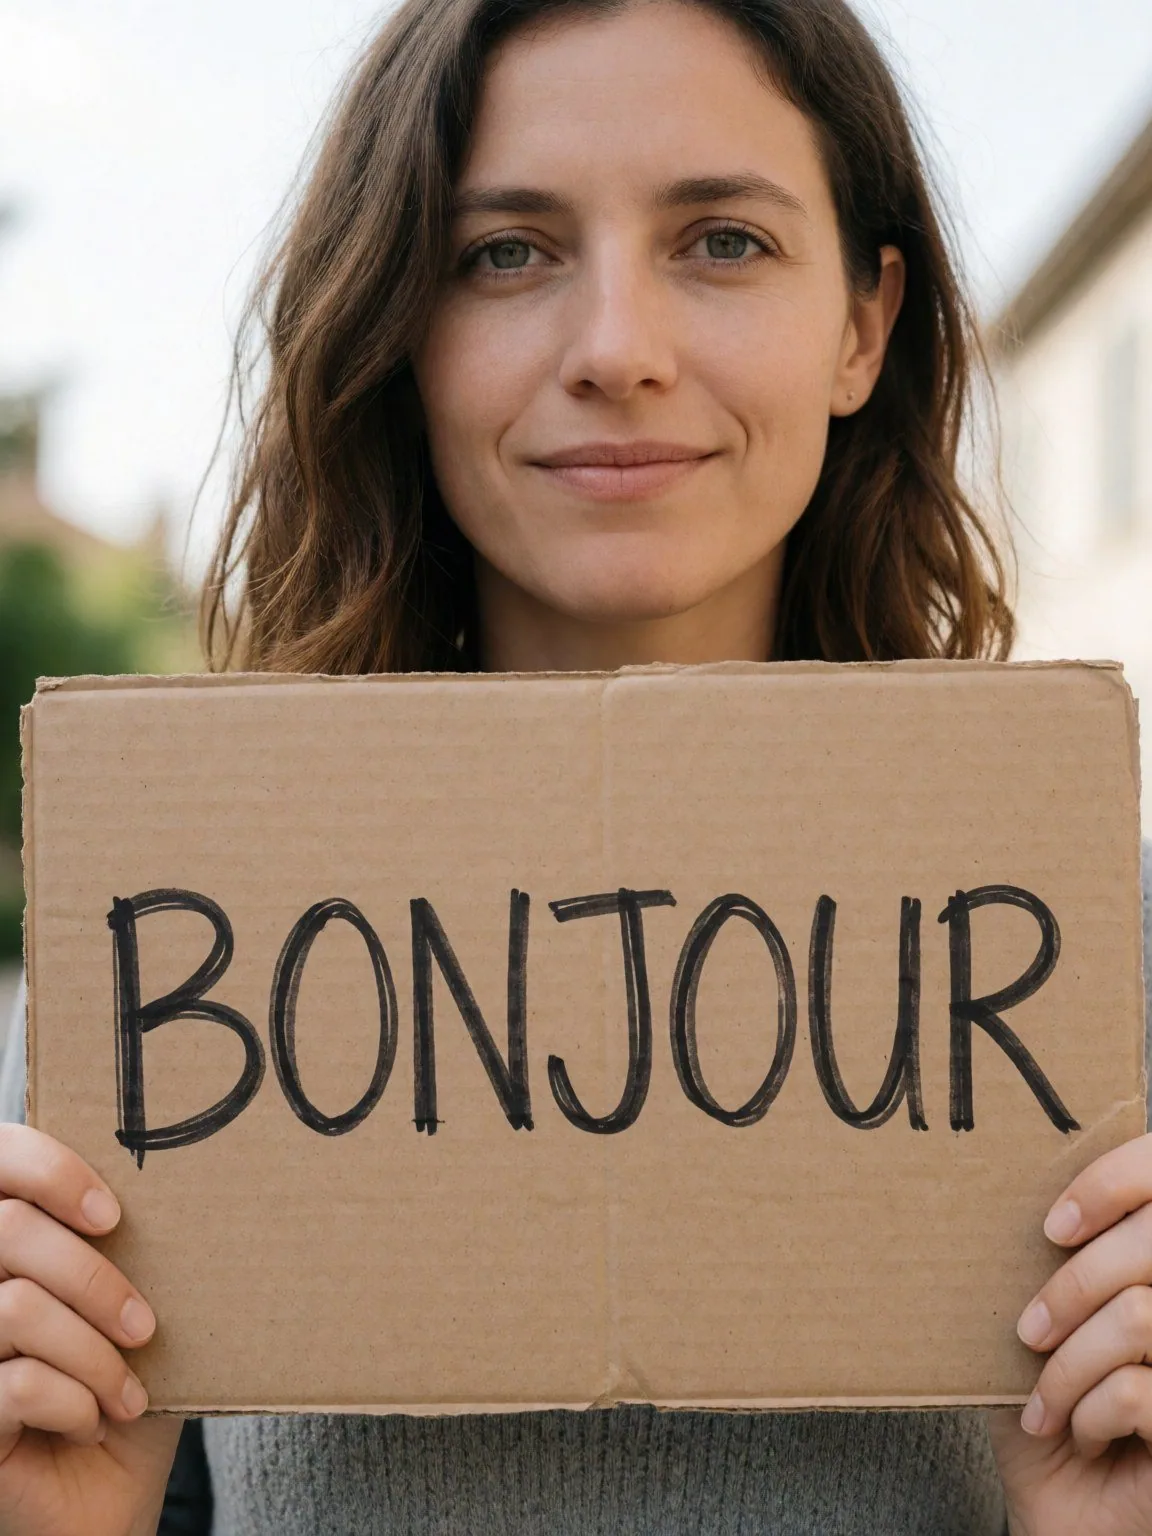
« BONJOUR » juste, plus un smartphone que personne n'a demandé.
Z-Image (base) bf16 · 25 étapes, CFG 4, négatif vide · 34,6 s et 0,0105 $ par image
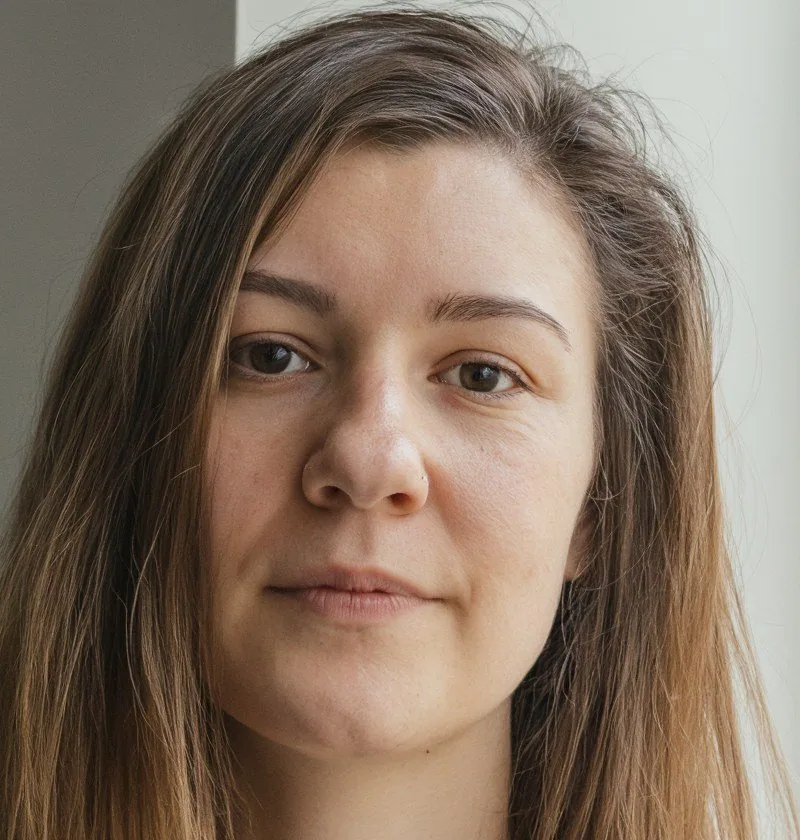
Portrait
Peau de vraie photo, visage ordinaire, et pas plus de vêtement que le Turbo.
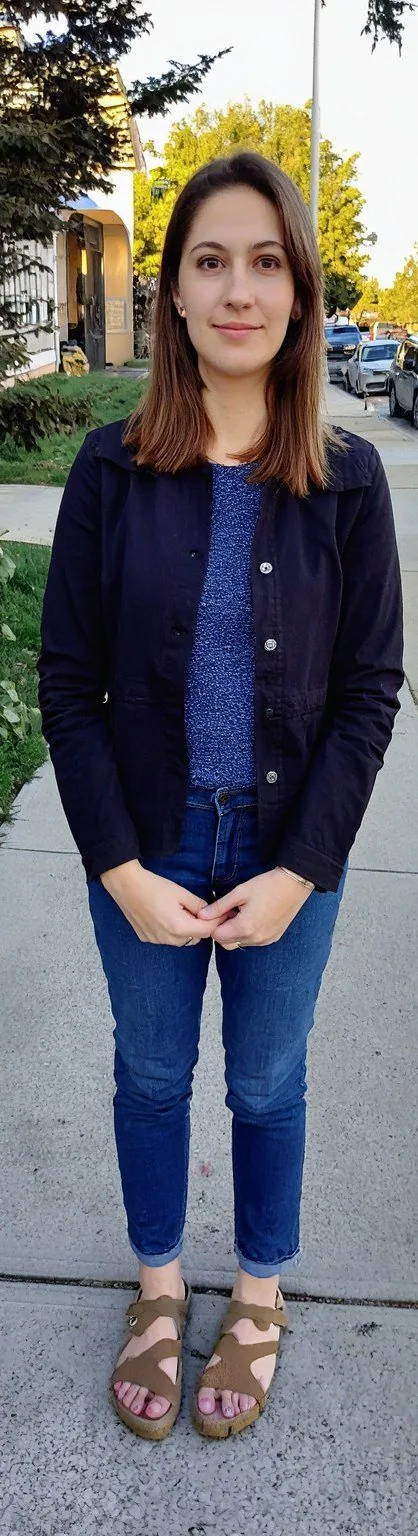
En pied
En pied, sandales comprises.
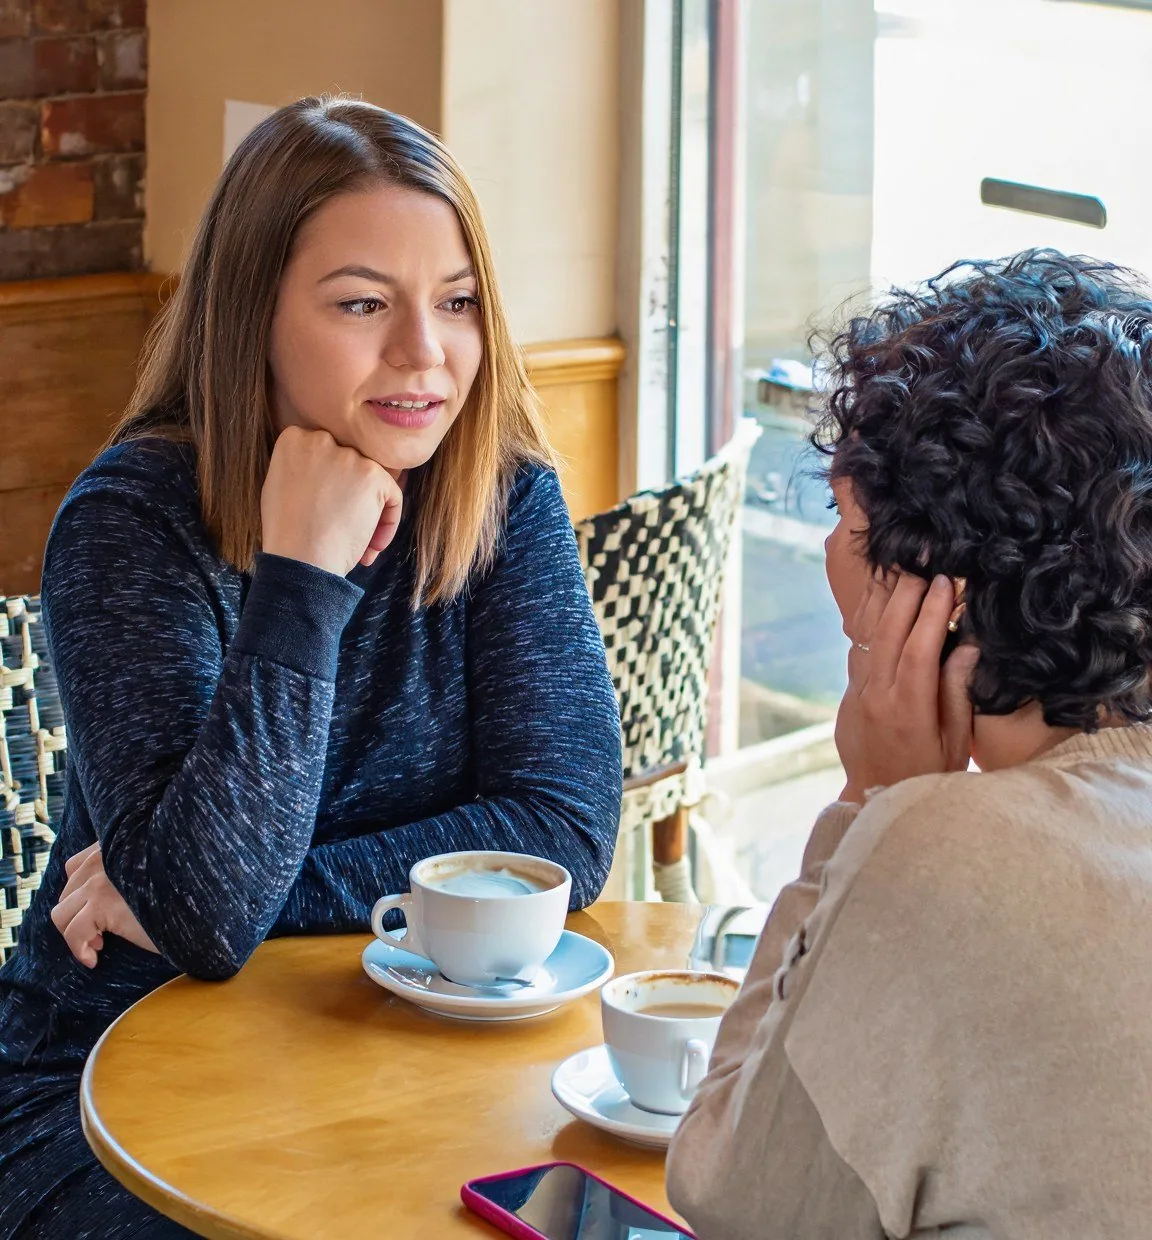
Deux personnages
La meilleure des trois : amie aux cheveux courts et bouclés, deux tasses.
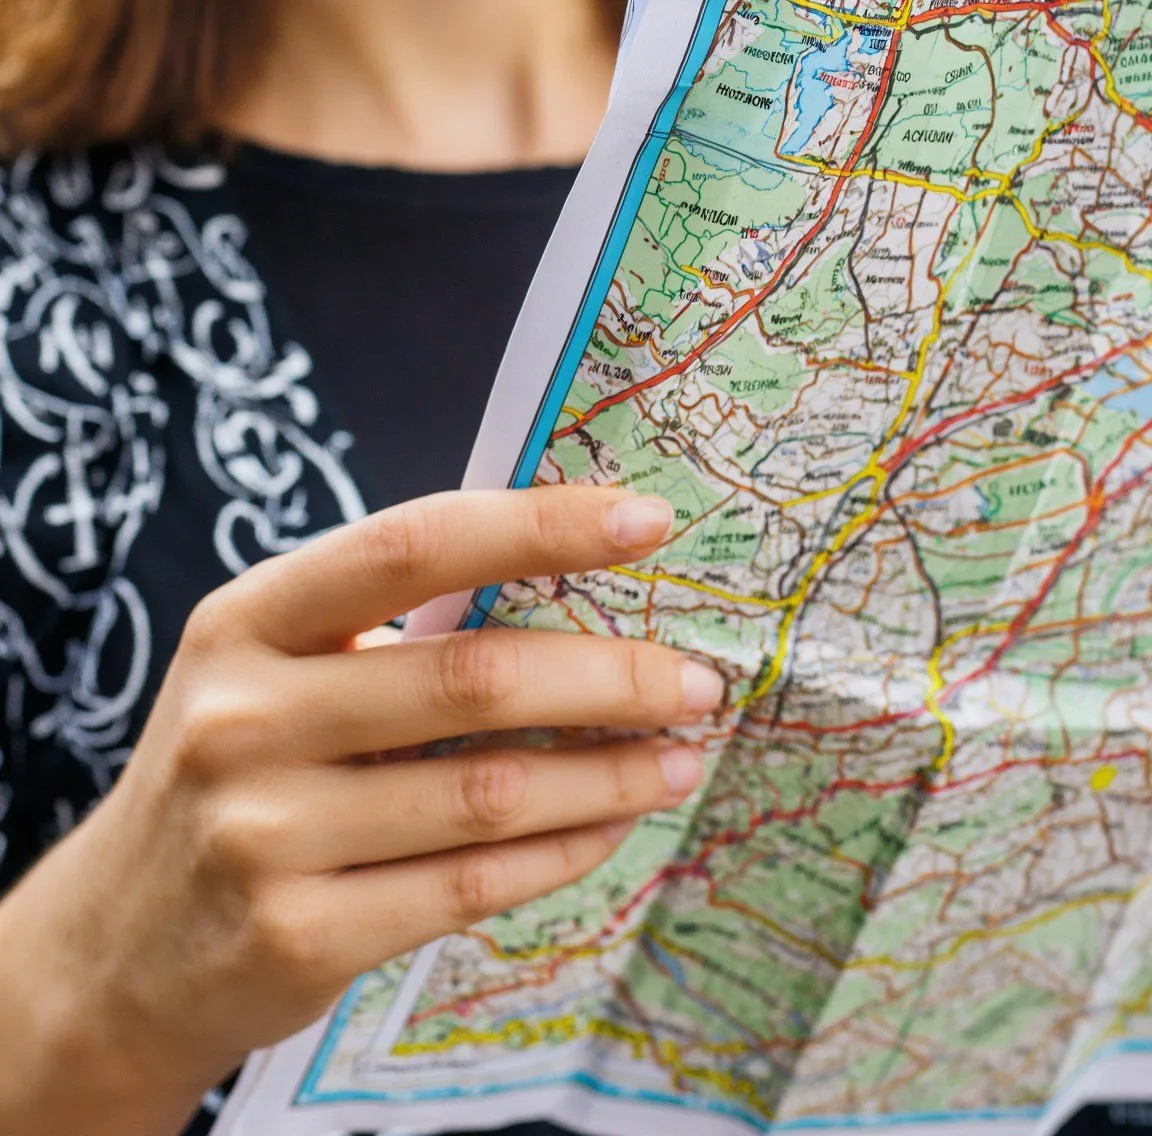
Mains et objet
Raté : une seule main tient la carte.
Nuit
Image écartée à notre relecture (tenue). Elle regardait l'objectif, téléphone en bas du cadre.
Texte dans l'image
« BONJOUR » juste, rien d'autre sur le carton.
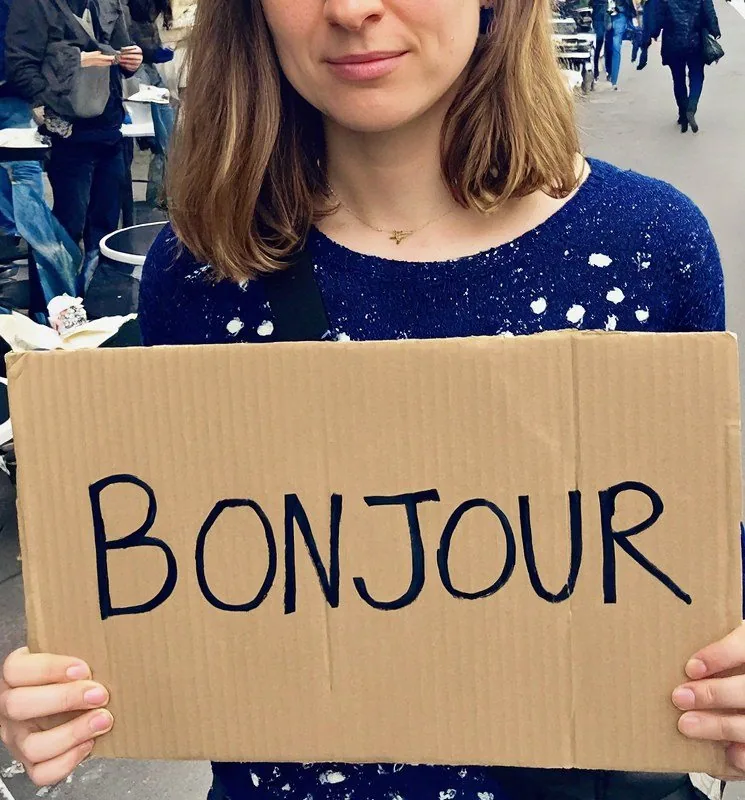
Repère : Krea 2 Turbo autre famille · fp8 · 8 étapes, CFG 1 · 11,6 s et 0,0035 $ par image
Portrait
Le seul portrait habillé des trois onglets.
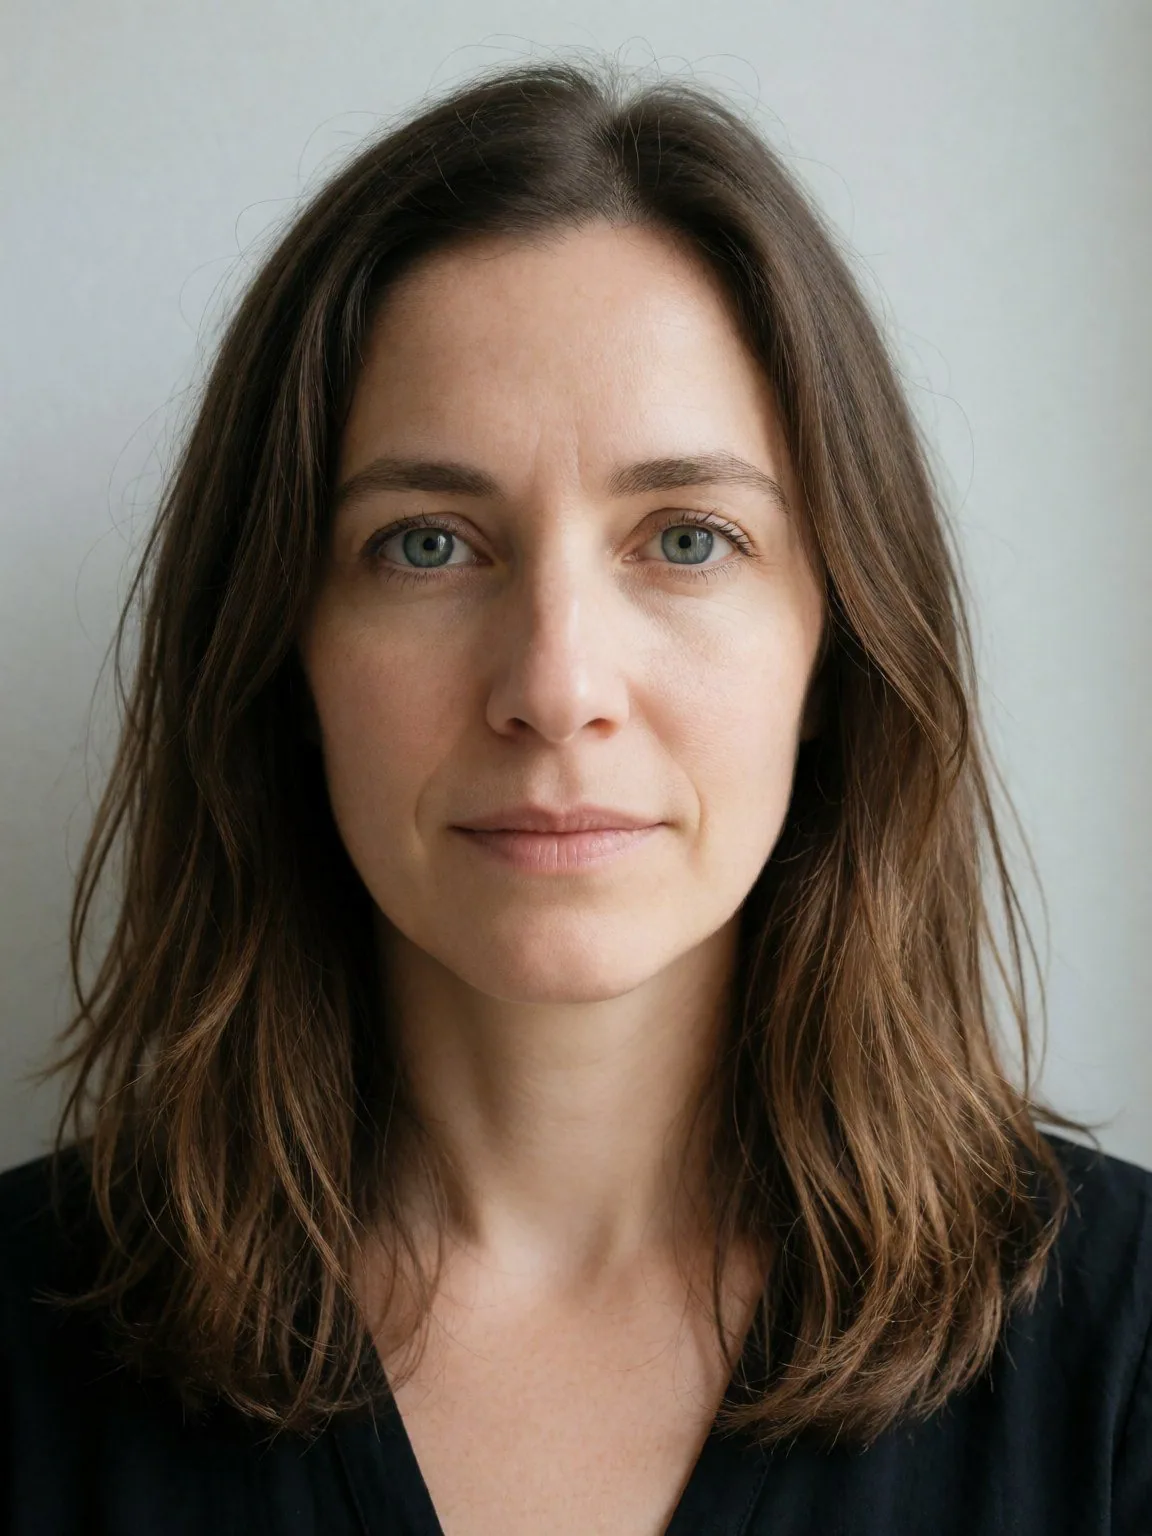
En pied
En pied, mocassins compris.
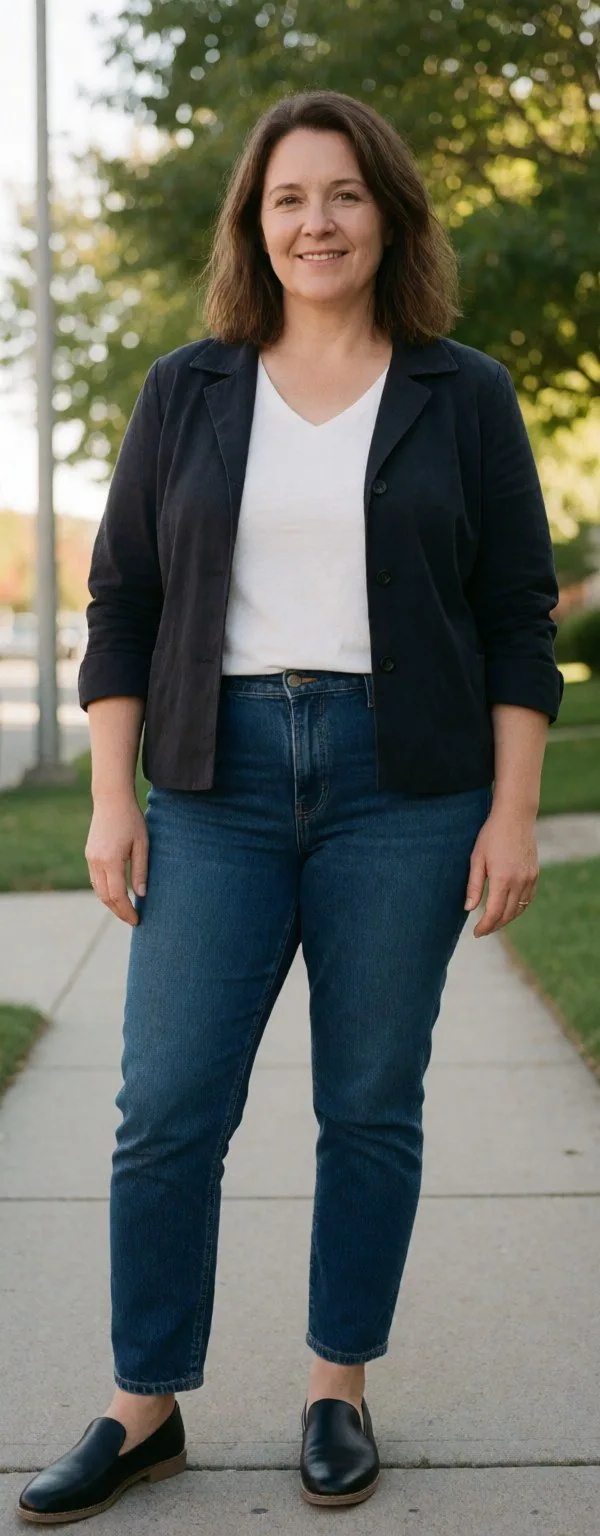
Deux personnages
Deux personnes, amie aux cheveux courts et bouclés, deux tasses.
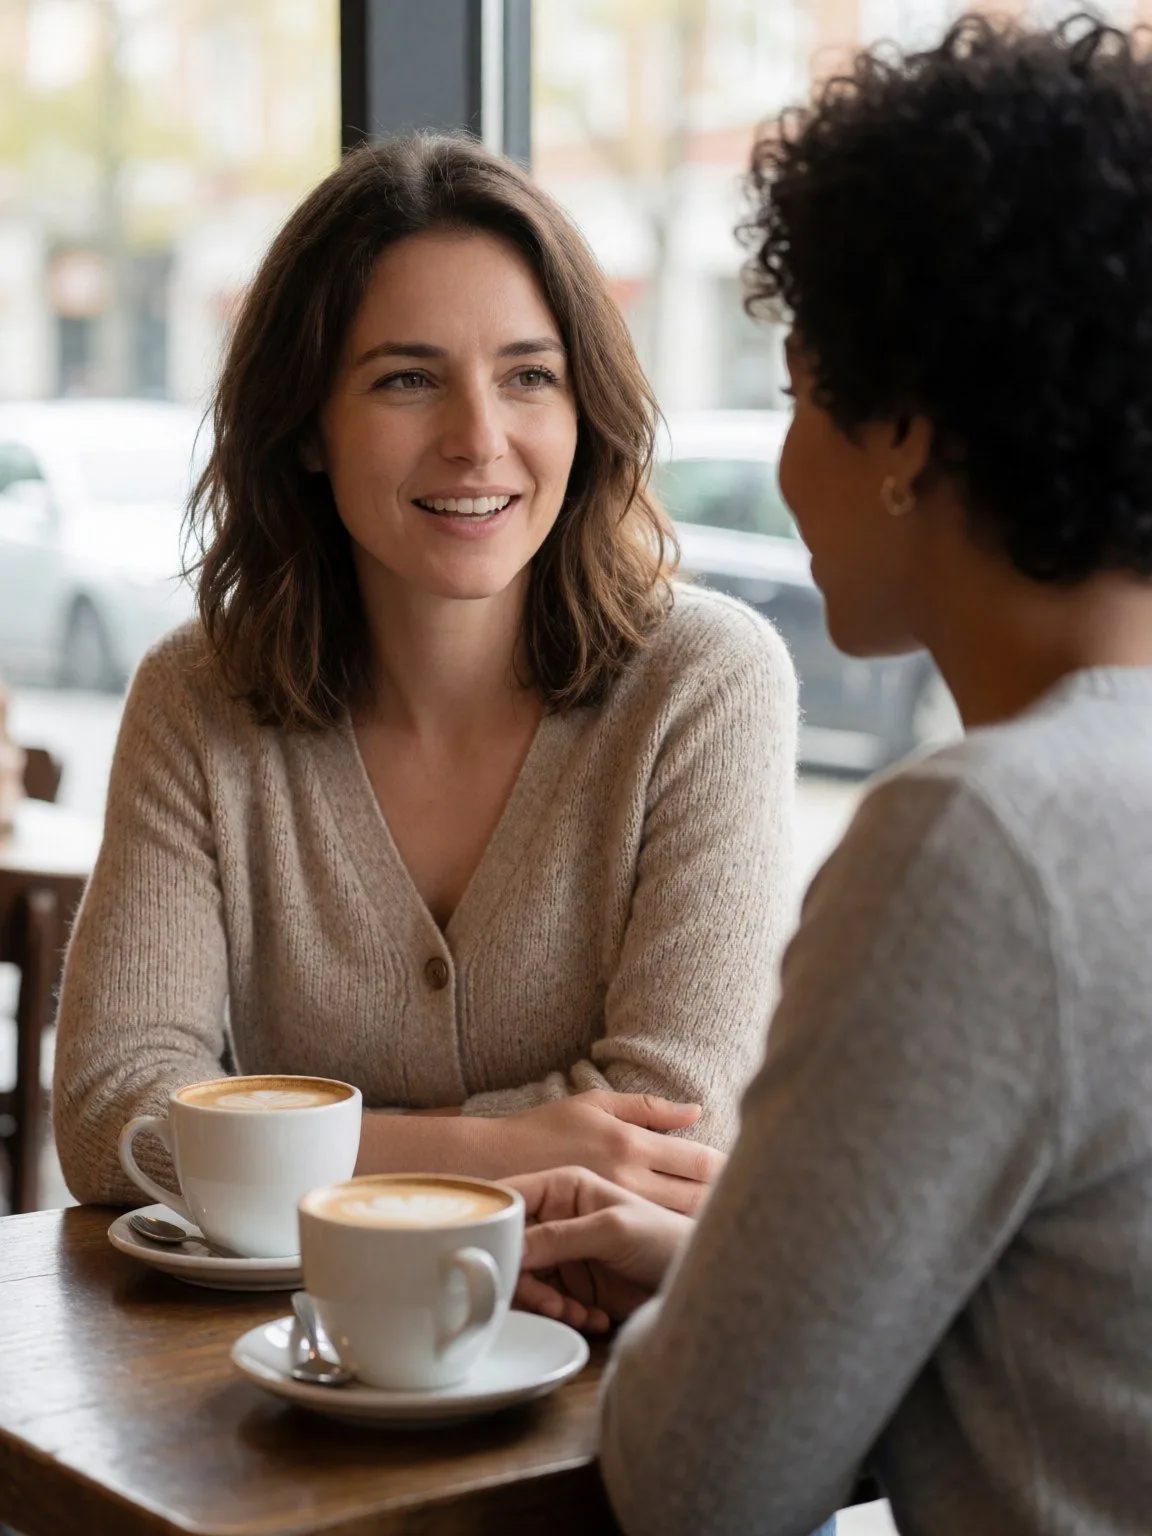
Mains et objet
Les deux mains, mais une carte couverte de noms inventés : on n'en montre que le bas.
Nuit
Visage éclairé par l'écran, mais une lampe allumée derrière : pas tout à fait la consigne.
Texte dans l'image
« BONJOUR » juste, rien d'autre.
Une image n'est pas montrée : la base de nuit, pour la tenue. Dix autres sont recadrées, pour des épaules nues, un débardeur, une robe courte, des façades, des voitures, ou des noms inventés sur deux cartes, dont un, sur celle de la base, pouvait se lire comme un nom de lieu réel ; deux téléphones ont l'objectif légèrement flouté parce que leur bloc photo évoquait une marque. Chaque cas est dit sous l'image.
Photo par photo : qui a fait quoi
Le portrait. Les deux Z-Image ont rendu des épaules nues, sans le moindre vêtement visible, alors que le prompt ne disait rien de la tenue. Le témoin, lui, a mis un haut noir. Conseil pratique : avec Z-Image, décris les vêtements. À l'œil, le Turbo lisse la peau et fait briller les lèvres, la base garde une peau de photo de téléphone.
Le plan en pied. Sans-faute partout : de la tête aux chaussures chez le Turbo, la base et le témoin.
Deux personnes au café. La base fait la scène demandée : une amie aux cheveux courts, foncés, bouclés, deux tasses. Le Turbo met deux personnes et deux tasses, mais l'amie a des boucles mi-longues. Le témoin fait aussi juste. Point pour la base.
Les deux mains sur une carte. Le Turbo et le témoin tiennent la carte à deux mains ; la base n'en montre qu'une. Point pour le Turbo. Et toutes les cartes inventent des noms : relis-les avant de publier.
La nuit, visage éclairé par le téléphone. Le Turbo réussit : le visage est éclairé par l'écran. La base fait regarder l'objectif, téléphone en bas du cadre, et son image est écartée. Le témoin éclaire le visage, mais laisse une lampe allumée derrière.
Le texte. « BONJOUR » juste chez les trois, rien d'autre sur le carton. Le Turbo ajoute un smartphone dans l'autre main, comme s'il avait lu « phone photo » au pied de la lettre. Le texte chinois, vanté par l'éditeur pour le Turbo : pas testé.
Les visages. Sans origine précisée dans le prompt, le Turbo a donné des traits est-asiatiques à trois photos sur six (portrait, en pied, nuit), la base à aucune. C'est un constat sur un tirage par prompt, pas une mesure de biais. Rien à voir avec la colonne « Diversity » de l'éditeur, qui parle d'autre chose : la variété d'une graine à l'autre (« composition, identité faciale et éclairage »). Il y classe le Turbo « Low » et la base plus haut ; avec une seule graine, je ne peux pas le vérifier.
La vitesse et le prix. Une fois le modèle chargé, le Turbo rend une image en 7,9 s, la base en 34,6 s, soit 4,4 fois plus. Le témoin, au même nombre d'étapes que le Turbo, prend 11,6 s. En dollars, notre calcul au prix horaire de la carte : 0,0024 $, 0,0105 $ et 0,0035 $ l'image. Tout le banc Z-Image, douze images, revient à 0,087 $ au même calcul, hors installation et téléchargements. Si tu génères 1 000 images, une après l'autre : 2,40 $ et 2 h 12 avec le Turbo, 10,50 $ et 9 h 37 avec la base.
Pour aller plus loin
- La fiche Z-Image : réglages détaillés, licence clause par clause, nos LoRA sur le Turbo.
- Z-Image ou Z-Image Turbo : lequel télécharger ?, le duel chiffré, à paraître le 04/11.
- Qwen-Image : toutes les variantes, l'autre grande famille d'images ouverte du catalogue, à paraître le 05/11.
- Z-Image ou Qwen-Image ?, le duel entre les deux familles, à paraître le 06/11.
L'avis de Milky
Si tu ne retiens qu'une chose : dans la famille Z-Image, le choix se fait aujourd'hui entre deux fichiers de 12,31 Go qui pèsent pareil et ne vont pas à la même vitesse. Le Turbo, c'est mon choix par défaut : 7,9 s, et il a tenu la nuit et les deux mains. La base, je la garde pour ce que l'éditeur lui promet, l'entraînement et le contrôle par prompt négatif, et je lui dois une revanche dans ses vrais réglages. Omni-Base et Edit, je les noterai quand ils seront dans la classe. Et la prochaine fois que deux modèles oublient d'habiller la dame du portrait alors que le témoin y arrive, je confisque les poids. Ne me mets pas en colère. Fin de l'appel : deux présents, deux absents, et un carnet de notes qui attend la suite.
Ce qu'on ne sait pas encore
- Quand Omni-Base et Edit auront des poids, et sous quelle licence.
- Ce que vaut la base en 50 étapes avec un prompt négatif, et si elle rattrape le Turbo sur les mains et la nuit.
- Ce que les fichiers allégés de Comfy-Org changent à l'image, et la mémoire vraiment prise par chaque version.
- Si les traits du visage et les épaules nues du portrait reviennent sur d'autres graines.
Les mots à retenir
- Distillé : un modèle à qui on a appris à faire en peu d'étapes ce que l'original fait en beaucoup ; le Turbo fait son image en 8 passages.
- Guidage (CFG) : à quel point le modèle colle au prompt ; le Turbo s'en passe, la base l'utilise, entre 3 et 5.
- Prompt négatif : ce que tu ne veux pas voir sur l'image ; la base en tient compte, pas le Turbo.
- SFT et RL : deux étapes d'entraînement après le pré-entraînement, l'affinage supervisé et l'apprentissage par renforcement ; le tableau de l'éditeur dit qui a eu quoi.
- Quantifié (int8, fp8, nvfp4…) : un fichier où les nombres du modèle sont rangés avec moins de chiffres, donc plus léger ; ici, ce sont des versions Comfy-Org.
Tous nos mots expliqués : le glossaire →
Passages sources
Afficher les 23 sources
| Réf. | Citation (langue originale) | URL |
|---|---|---|
| S1↑1↑2↑3↑4↑5↑6+17 | "license: apache-2.0" ; "Z-Image is a powerful and highly efficient image generation model family with 6B parameters. Currently there are four variants:" ; "Z-Image-Turbo – A distilled version of Z-Image that matches or exceeds leading competitors with only 8 NFEs (Number of Function Evaluations). It offers ⚡️sub-second inference latency⚡️ on enterprise-grade H800 GPUs and fits comfortably within 16G VRAM consumer devices. It excels in photorealistic image generation, bilingual text rendering (English & Chinese), and robust instruction adherence." ; "Z-Image – The foundation model behind Z-Image-Turbo." ; "Z-Image-Omni-Base – The versatile foundation model capable of both generation and editing tasks. … providing the most "raw" and diverse starting point for the open-source community." ; "Z-Image-Edit – A variant fine-tuned on Z-Image specifically for image editing tasks." ; tableau : "Z-Image-Omni-Base | ✅ | ❌ | ❌ | 50 | ✅ | Gen. / Editing | Medium | High | Easy | To be released" ; "Z-Image | … | High | Medium | Easy" ; "Z-Image-Turbo | ✅ | ✅ | ✅ | 8 | ❌ | Gen. | Very High | Low | N/A" ; "Z-Image-Edit | … | To be released" ; "guidance_scale=0.0, # Guidance should be 0 for the Turbo models" | https://huggingface.co/Tongyi-MAI/Z-Image-Turbo |
| S2↑1↑2↑3↑4 | API, 26/10/2026 : "id":"Tongyi-MAI/Z-Image-Turbo" ; "gated":false ; "parameters":{"F32":6154908736} ; transformer : 9973693184 + 9973714824 + 4672282880 octets ; pas de fichier LICENSE | https://huggingface.co/api/models/Tongyi-MAI/Z-Image-Turbo |
| S3↑1↑2↑3↑4↑5↑6+11 | "license: apache-2.0" ; "Z-Image is a full-capacity, undistilled transformer" ; "It supports full Classifier-Free Guidance (CFG)" ; "Z-Image delivers significantly higher variability in composition, facial identity, and lighting across different seeds" ; "Its non-distilled nature makes it a good base for LoRA training, structural conditioning (ControlNet) and semantic conditioning." ; "Robust Negative Control: Responds with high fidelity to negative prompting" ; "Steps | 28~50 | 8" ; "Fintunablity | ✅ | ❌" ; "Negative Prompting | ✅ | ❌" ; "Diversity | High | Low" ; "Guidance scale: 3.0 – 5.0" ; "Inference steps: 28 – 50" | https://huggingface.co/Tongyi-MAI/Z-Image |
| S4↑1↑2↑3 | API, 26/10/2026 : "id":"Tongyi-MAI/Z-Image" ; "gated":false ; "parameters":{"BF16":6154908736} ; transformer : 9973727144 + 2336146728 octets ; pas de fichier LICENSE | https://huggingface.co/api/models/Tongyi-MAI/Z-Image |
| S5↑1↑2↑3↑4↑5↑6+14 | "[2026-01-27] 🔥 Z-Image is released!" ; "[2025-11-26] 🔥 Z-Image-Turbo is released!" ; tableau "Model | Pre-Training | SFT | RL | Step | CFG | Task | Visual Quality | Diversity | Fine-Tunability" ; "Z-Image-Omni-Base | ✅ | ❌ | ❌ | 50 | ✅" ; "Z-Image | ✅ | ✅ | ❌ | 50 | ✅ | Gen. | High | Medium | Easy" ; "Z-Image-Turbo | ✅ | ✅ | ✅ | 8 | ❌ | Gen. | Very High | Low | N/A" ; "Z-Image-Edit | ✅ | ✅ | ❌ | 50 | ✅ | Editing | High | Medium | Easy | To be released" ; "We adopt a Scalable Single-Stream DiT (S3-DiT) architecture. In this setup, text, visual semantic tokens, and image VAE tokens are concatenated at the sequence level to serve as a unified input stream" ; "Negative prompts: Strongly recommended for better control" ; "Decoupled-DMD is the core few-step distillation algorithm that empowers the 8-step Z-Image model." ; "Reinforcement Learning (RL) and Distribution Matching Distillation (DMD) can be synergistically integrated" ; deux badges « arXiv » (2511.22677, 2511.13649) en tête de ces deux sections | https://github.com/Tongyi-MAI/Z-Image |
| S6↑1↑2↑3↑4 | "Apache License Version 2.0, January 2004" ; "a perpetual, worldwide, non-exclusive, no-charge, royalty-free, irrevocable copyright license to reproduce, prepare Derivative Works of, publicly display, publicly perform, sublicense, and distribute" ; 3 "patent license to make, have made, use, offer to sell, sell, import, and otherwise transfer the Work" ; 4 "(a) You must give any other recipients of the Work or Derivative Works a copy of this License" ; "(b) You must cause any modified files to carry prominent notices stating that You changed the files" ; "This License does not grant permission to use the trade names, trademarks, service marks, or product names of the Licensor" | https://github.com/Tongyi-MAI/Z-Image/blob/main/LICENSE |
| S7↑1↑2↑3 | "Z-Image Team, Tongyi MAI, Alibaba Group" ; "We are publicly releasing two specialized models on Z-Image: Z-Image-Turbo for generation and Z-Image-Edit for editing. The model code, weights, and an online demo are now publicly available" ; "It can run smoothly on consumer-grade graphics cards with less than 16GB of VRAM" | https://tongyi-mai.github.io/Z-Image-blog/ |
| S8↑1↑2↑3↑4↑5↑6+1 | API, modèles du compte, 26/10/2026 : "Tongyi-MAI/Z-Image-Turbo", "Tongyi-MAI/Z-Image", "Tongyi-MAI/MAI-Gym-9B", "Tongyi-MAI/MAI-UI-2B", "Tongyi-MAI/MAI-UI-8B" ; recherche « z-image » dans le compte : 2 résultats | https://huggingface.co/api/models?author=Tongyi-MAI |
| S9↑1↑2 | API GitHub, dépôts de l'organisation, 26/10/2026 : "Z-Image", "Z-Image-blog", puis des dépôts d'agents (MAI-UI, MAI-Gym…) ; aucun dépôt Edit ou Omni | https://github.com/Tongyi-MAI |
| S10↑1↑2↑3↑4↑5↑6+6 | "Repackaged model files for ComfyUI." ; "Original model repository: https://huggingface.co/Tongyi-MAI/Z-Image-Turbo" ; "license: apache-2.0" ; z_image_turbo_bf16 12309866400 ; z_image_turbo_int8_convrot 6201001296 ; z_image_turbo_nvfp4 4509509600 ; z_image_turbo_distill_patch_lora_bf16 158826336 ; qwen_3_4b 8044982048 ; qwen_3_4b_fp8_mixed 5631994051 ; qwen_3_4b_fp4_mixed 3479416193 ; ae 335304388 octets ; "Z-Image-Turbo Fun Union ControlNet" | https://huggingface.co/Comfy-Org/z_image_turbo |
| S11↑1↑2↑3↑4↑5↑6+3 | "Repackaged model files for ComfyUI." ; "Original model repository: https://huggingface.co/Tongyi-MAI/Z-Image" ; "license: apache-2.0" ; z_image_bf16 12309866400 ; z_image_int8_convrot 6201001296 ; qwen_3_4b, fp8_mixed, fp4_mixed ; ae (aucun fichier nvfp4) | https://huggingface.co/Comfy-Org/z_image |
| S12↑1↑2 | Modèles de workflow Comfy-Org, 26/10/2026 : Turbo, KSampler [… 8, 1, "res_multistep", "simple" …], ConditioningZeroOut ; base, KSampler [… 25, 4, "res_multistep", "simple" …], négatif "" ; Turbo int8 : UNETLoader "z_image_turbo_int8_convrot.safetensors", CLIPLoader "qwen_3_4b_fp8_mixed.safetensors" | https://github.com/Comfy-Org/workflow_templates |
| S13↑ | "VAE: ae.safetensors the Flux 1 VAE if you don’t have it already" | https://comfyanonymous.github.io/ComfyUI_examples/z_image/ |
| S14↑1↑2↑3 | Comptes alibaba-pai, 26/10/2026 : "alibaba-pai/Z-Image-Turbo-Fun-Controlnet-Union", "…-Union-2.1", "alibaba-pai/Z-Image-Fun-Controlnet-Union-2.1", "alibaba-pai/Z-Image-Fun-Lora-Distill" ; "license: apache-2.0" ; "Supports multiple control conditions (Canny, Depth, Pose, MLSD, Hed, Scribble, and Gray)." ; "It requires only 2 steps instead of 8." ; "It requires only 4 steps instead of 8 steps." ; "It does not use any Z-Image-Turbo related weights and is trained from scratch." ; "The purpose of this model is to provide fast generation compatibility for Z-Image derivative models, not to replace Z-Image-Turbo." | https://huggingface.co/alibaba-pai |
| R1↑1↑2↑3 | Pod Runpod, NVIDIA L40S, 1,09 $/h, « Total VRAM 45460 MB », ComfyUI 0.42.0, 25/10/2026 ; les trois configurations sur le même pod ; journal : « Lumina2 … 11738MB Staged » et « ZImageTEModel_ … 7671MB Staged » pour la base comme pour le Turbo ; pic non mesuré | — (test maison) |
| R2↑1↑2↑3↑4↑5 | Turbo 8 étapes, CFG 1, négatif à zéro ; base 25 étapes, CFG 4, négatif vide ; res_multistep, simple, shift 3 ; Krea 2 Turbo 8 étapes, CFG 1, euler, fp8 ; 6 prompts du banc, graine 2210, 1152 × 1536, un tirage, sans LoRA | — (test maison) |
| R3↑1↑2↑3↑4↑5↑6+3 | Médianes hors première image, 1,09 $/h : Turbo 7,9 s, 0,0024 $ ; base 34,6 s, 0,0105 $ ; Krea 2 Turbo 11,6 s, 0,0035 $ ; rapport 4,4 ; 12 images Z-Image : 0,0872 $ au même calcul (durée × prix horaire, hors installation et téléchargements ; pas une facture) | — (test maison) |
| R4↑1↑2↑3↑4↑5↑6+13 | Relecture des 17 images en pleine taille : portraits sans vêtement visible chez les deux Z-Image, habillé chez Krea 2 Turbo ; base b4 une seule main ; Turbo b3 amie aux boucles mi-longues ; Turbo b5 visage éclairé par l'écran ; Turbo b6 smartphone en plus ; « BONJOUR » juste chez les trois ; traits est-asiatiques chez le Turbo en b1, b2, b5 | — (test maison) |
| R5↑1↑2↑3↑4↑5 | 1 image écartée (base b5), 10 recadrées (base b6 : cadre descendu sous les yeux à la vérification du 26/10, rue commerçante du fond hors cadre), 2 téléphones floutés | — (test maison) |
| R6↑1↑2↑3↑4↑5↑6 | Tailles calculées : 20,69 Go (un modèle bf16 + encodeur + décodeur), 33,00 Go (les deux), 12,17 Go (int8 + fp8), 8,32 Go (Turbo nvfp4 + fp4) ; dépôts de l'éditeur : 32,83 Go (Turbo) et 20,52 Go (base), modèle d'images 24,62 Go et 12,31 Go | — (calcul maison) |
| R7↑1↑2↑3↑4↑5↑6 | Pas testé : base en 28 à 50 étapes avec négatif, fichiers allégés, format Diffusers, plusieurs graines, pic de mémoire, carte de 16 Go, texte chinois, améliorateur de prompt, ControlNet et LoRA d'alibaba-pai, Omni-Base et Edit | — (test maison) |
| R8↑1↑2 | Pas de fichier LICENSE dans les dépôts Hugging Face de l'éditeur ; LICENSE GitHub identique au texte d'apache.org (diff du 26/10/2026) | — (relevé maison) |
| R9↑ | Calculs maison (26/10/2026) : 1 000 × 0,0024 $ = 2,40 $ ; 1 000 × 7,9 s = 2 h 12 ; 1 000 × 0,0105 $ = 10,50 $ ; 1 000 × 34,6 s = 9 h 37 | — (calcul maison) |
Je ne crois pas une démo. Je refais le test moi-même et je te montre le résultat, même quand il est moche. Et ne me mets pas en colère, tu ne vas pas aimer la suite.