Wan 2.2 : du cinéma, promet Wan-AI. Du cinéma muet, à six centimes le plan
Note de fin de journée, minuit moins le quart, les yeux qui piquent. Bon. Dernier banc du jour : Wan 2.2, l'habitué de nos bancs vidéo (cinq tournages entre le 22 et le 26/10, du croissant jamais volé au refrain chanté), remis sur notre mini banc en mode rapide, face à LTX 2.5 et MiniMax H3. Wan-AI lui promet une esthétique de cinéma et, sur son propre banc, des performances supérieures aux grands modèles fermés. Sur mes quatre plans : des mains propres, une tête qui part à droite quand je dis à gauche, et pas un son. Du cinéma, oui. Muet.
Fiche modèle. Pages officielles relevées le 26/10/2026 ; nos tests du 26/10/2026 sur Runpod, et nos tournages du 22 au 24/10/2026. Fiche mise à jour le 11/11/2026.
 MilkyCelle qui teste · Image, vidéo et ComfyUI
Vérifié par une 2e IA
En bref
- Une famille de modèles vidéo à poids ouverts de Wan-AI ; on a testé le modèle image → vidéo A14B, deux « experts » d'environ 14 milliards de paramètres. Sur nos 4 plans : la carte dépliée en entier (jamais retournée), le geste de la tasse juste ; la tête tournée du mauvais côté, la nuit à moitié, et aucun son.
- Chez nous, en mode rapide (4 étapes) sur une RTX PRO 6000 louée 2,49 $/h : environ 86 s et 0,059 $ le plan de 5 s, soit 0,012 $ la seconde (médianes, notre calcul : durée × prix horaire). Trois fois le prix de LTX 2.5 (0,019 $), moins de la moitié de MiniMax H3 (0,135 $). Si tu fais 100 plans : 5,94 $ et 2 h 23 de calcul, contre 1,92 $ et 46 min chez LTX 2.5, 13,49 $ et 5 h 25 chez MiniMax H3 (notre calcul).
- Licence Apache 2.0, sans seuil de chiffre d'affaires. Limite principale : le mode rapide n'est pas la recette de l'éditeur (40 étapes), qu'on n'a jamais mesurée.
| Carte d'identité | |
|---|---|
| Nom, version testée | Wan2.2-I2V-A14B, fichiers fp8 réempaquetés pour ComfyUI, avec l'accélérateur lightx2v en 4 étapes |
| Éditeur | Wan-AI (compte Hugging Face et GitHub Wan-Video) |
| Sortie | « Jul 28, 2025 » pour les poids et le code de Wan2.2 |
| Type | Image → vidéo ; deux experts d'« environ 14B » chacun, « 27B de paramètres, mais seulement 14B de paramètres actifs par étape » ; 480p et 720p |
| Ouvert ou fermé | Poids téléchargeables sans compte (« gated » : false) |
| Prix officiel | Aucun prix par vidéo dans les pages lues : en local, on paie la carte |
| Où on l'a fait tourner | Runpod (lien parrainé), ComfyUI 0.42.0, NVIDIA RTX PRO 6000 Blackwell |
Et Wan 3.0 ? Il n'est pas ouvert : le 26/10, aucun dépôt Wan 3 chez Wan-AI, et on ne l'a jamais utilisé que par API. Le duel où il passe, c'est Wan 3.0 ou FLUX 3 Max ?.
Ce qu'il sait faire
La promesse. Deux experts, ce que Wan-AI appelle « Mixture-of-Experts » (un mélange d'experts : au lieu d'un seul gros modèle qui fait tout, deux modèles spécialisés se passent le relais) : le premier pose la mise en place, le second les détails. Wan-AI annonce aussi une esthétique « Cinematic-level » et des performances « superior » aux grands modèles fermés, sur son propre banc, Wan-Bench 2.0. Le labo, juge et partie.
La famille. Six modèles Wan 2.2 chez Wan-AI au 26/10, plus des versions Diffusers :
| Modèle | Ce qu'il fait selon Wan | Chez nous |
|---|---|---|
| T2V-A14B | texte → vidéo, 480p et 720p | pas testé |
| I2V-A14B | image → vidéo, 480p et 720p | testé : banc du 26/10, n° 8, 10, 16 |
| TI2V-5B | texte ou image → vidéo, 720p à 24 i/s | testé : n° 10 et 16 |
| S2V-14B | vidéo pilotée par un son (« audio-driven ») | testé : n° 33 |
| Animate-14B | anime ou remplace un personnage d'après une vidéo | pas testé |
| Animate-2-14B | « Wan-Animate-2 », poids publiés le 07/08/2026 | pas testé |
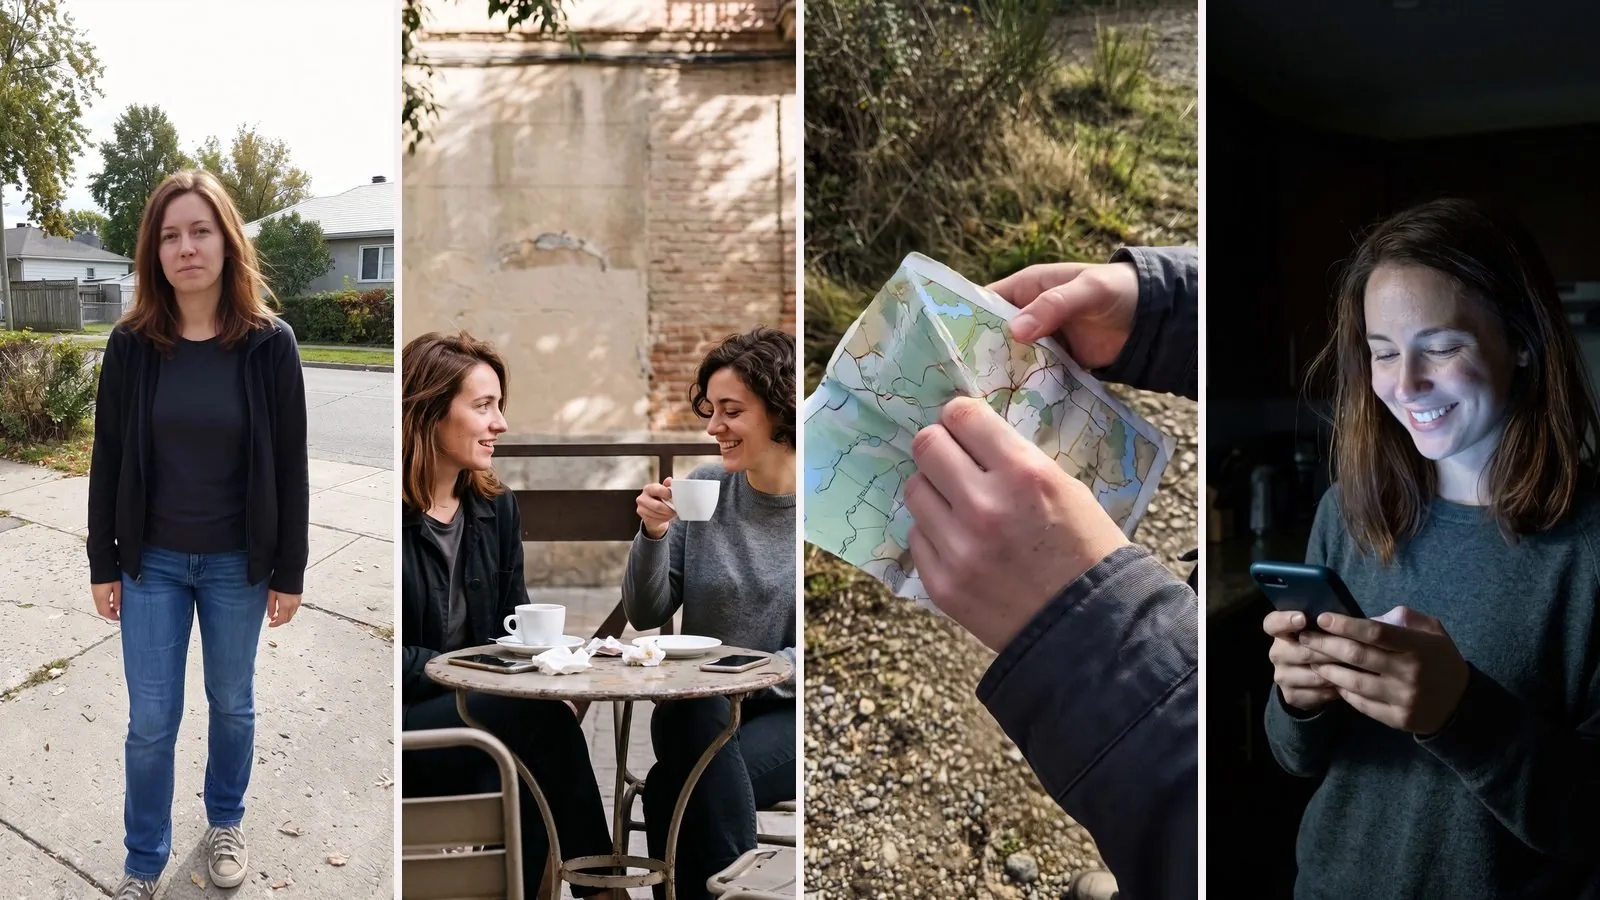
Nos quatre plans. Mêmes images de départ et mêmes consignes pour tous les modèles du banc, un seul tirage :
| Plan demandé | Wan 2.2 A14B rapide |
|---|---|
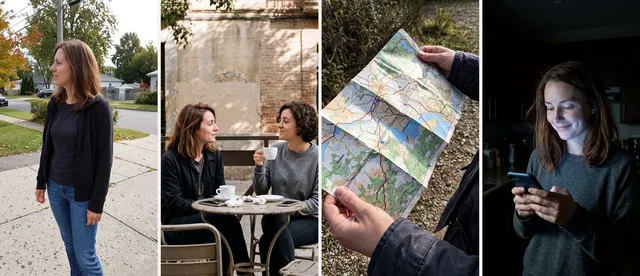
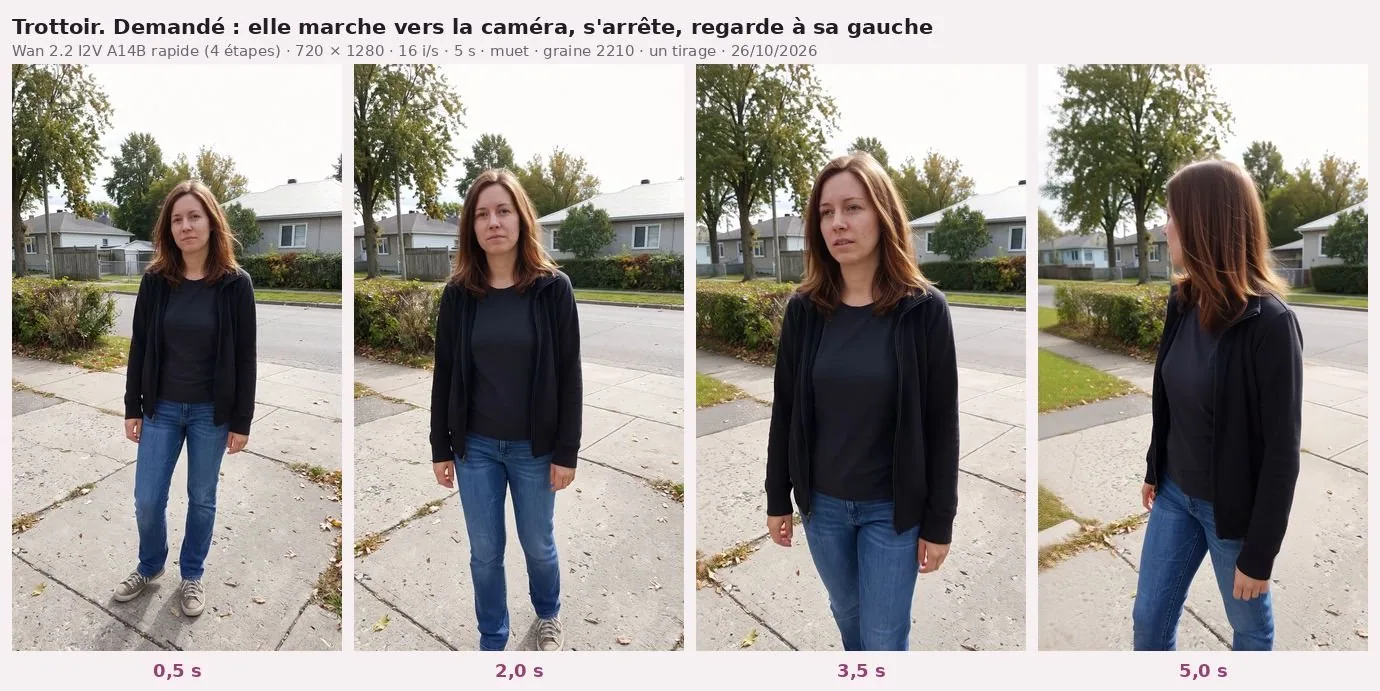
| Marcher vers la caméra, s'arrêter, regarder à gauche | À moitié : elle s'approche sans à-coup, puis se tourne vers SA droite ; à 5 s, visage caché |
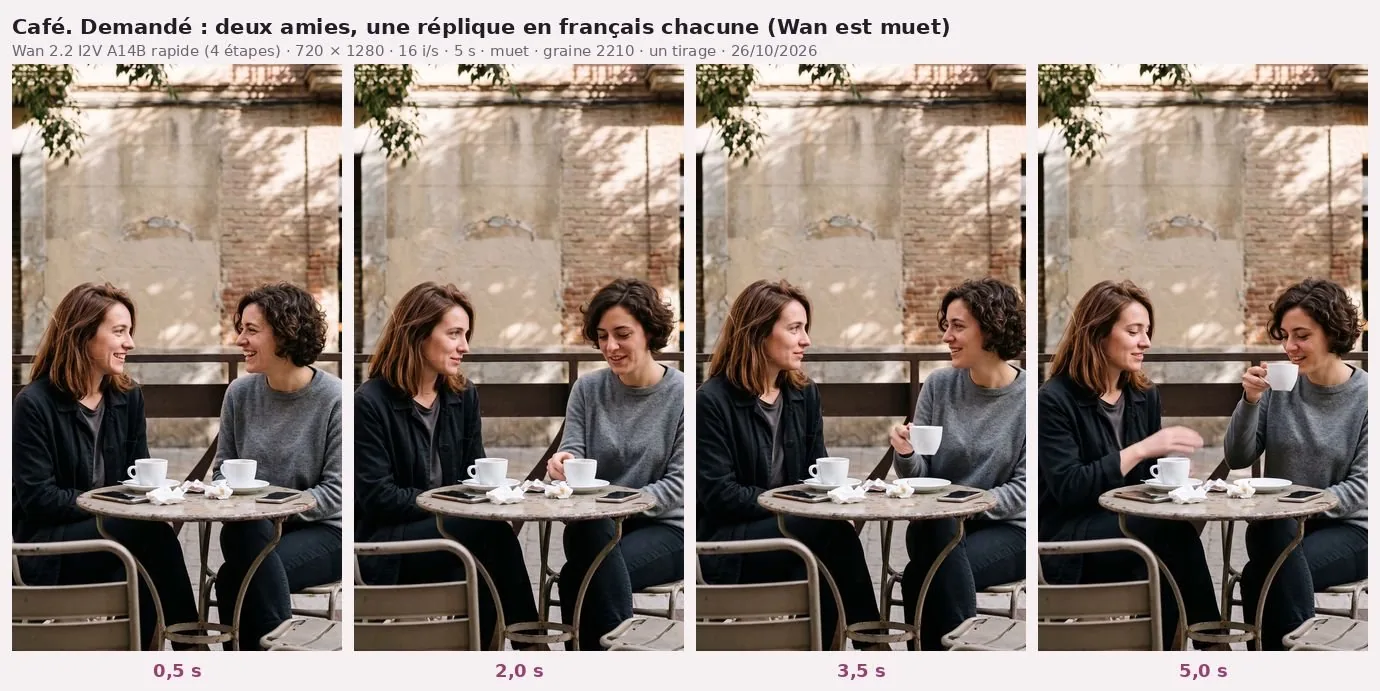
| Deux amies, une réplique en français chacune, une tasse levée | Les gestes, oui : tasse levée à 3,5 s, bue à 5 s, visages stables. Les répliques, non : pas de son |
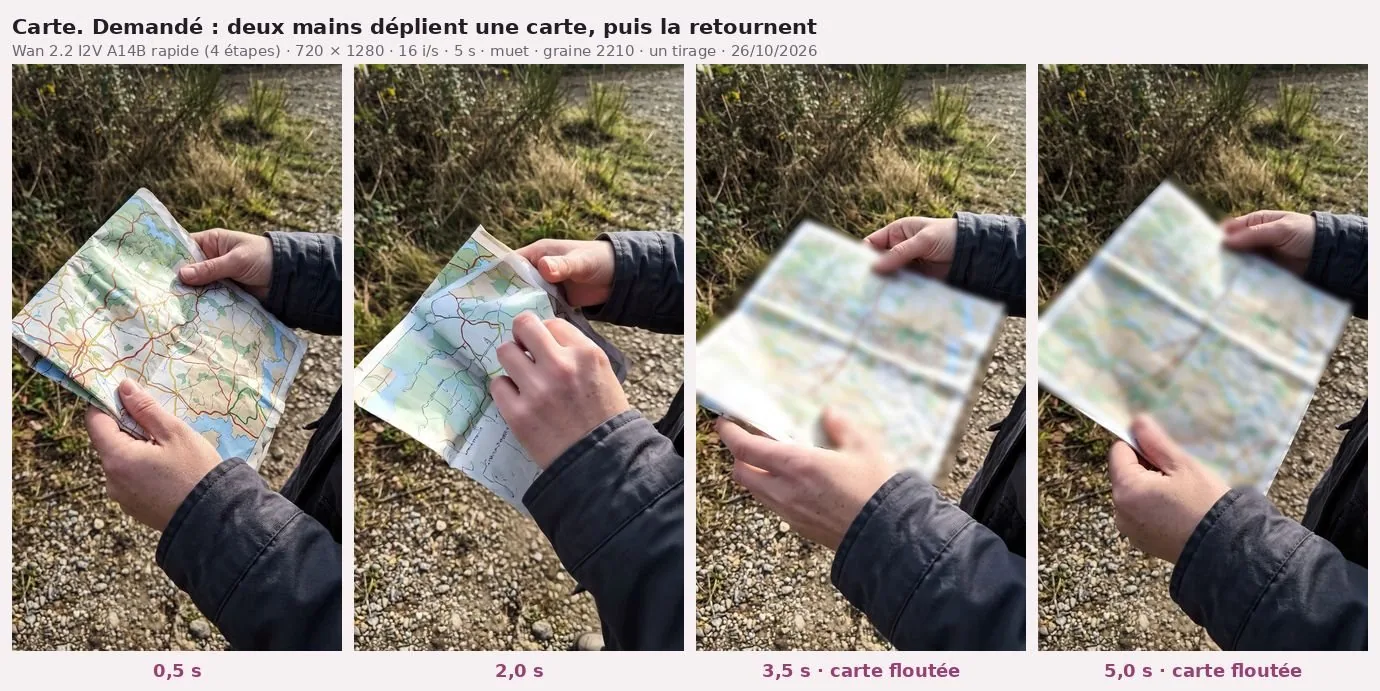
| Déplier toute la carte, puis la retourner | À moitié : dépliée à plat vers 3,5 s, doigts corrects, mais jamais retournée |
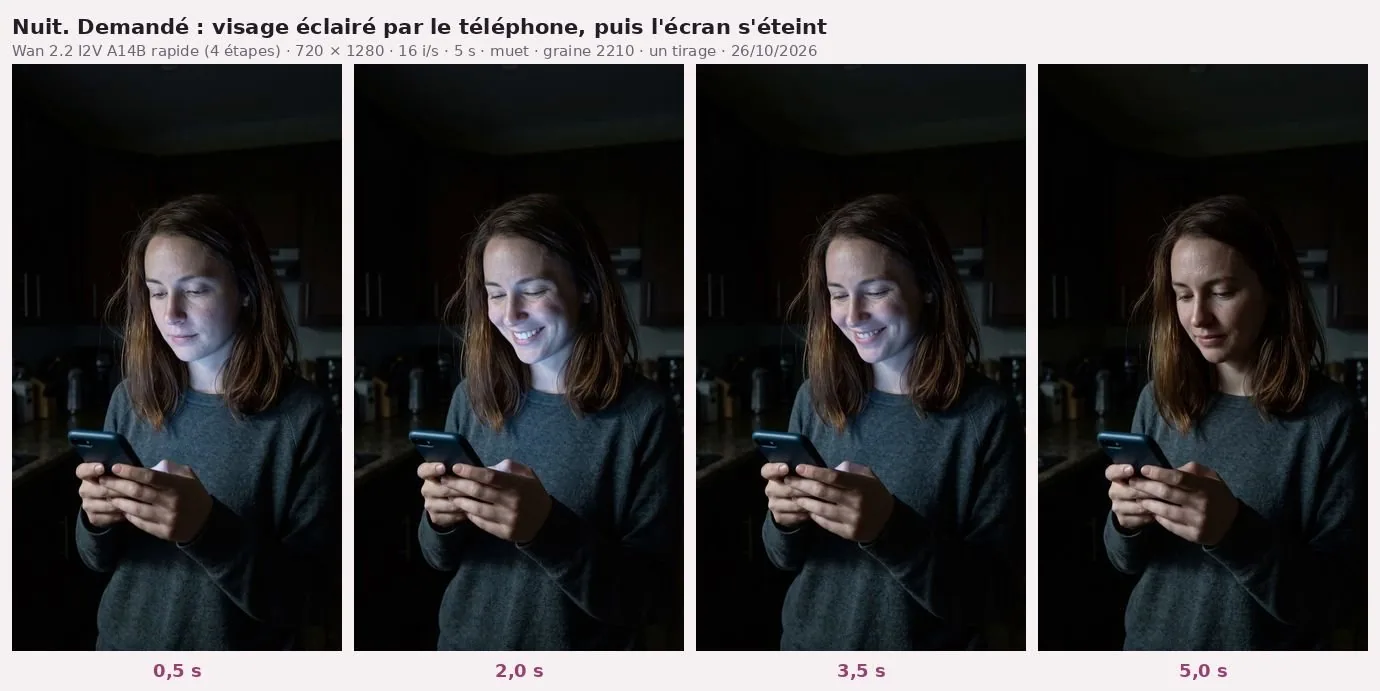
| Visage éclairé par le téléphone, puis l'écran s'éteint et le visage tombe dans le noir | À moitié : la lueur froide part vers 4 s, une lumière plus chaude la remplace ; jamais de noir |
Relecture image par image (toutes les 0,5 s, pleine taille), 26/10/2026.
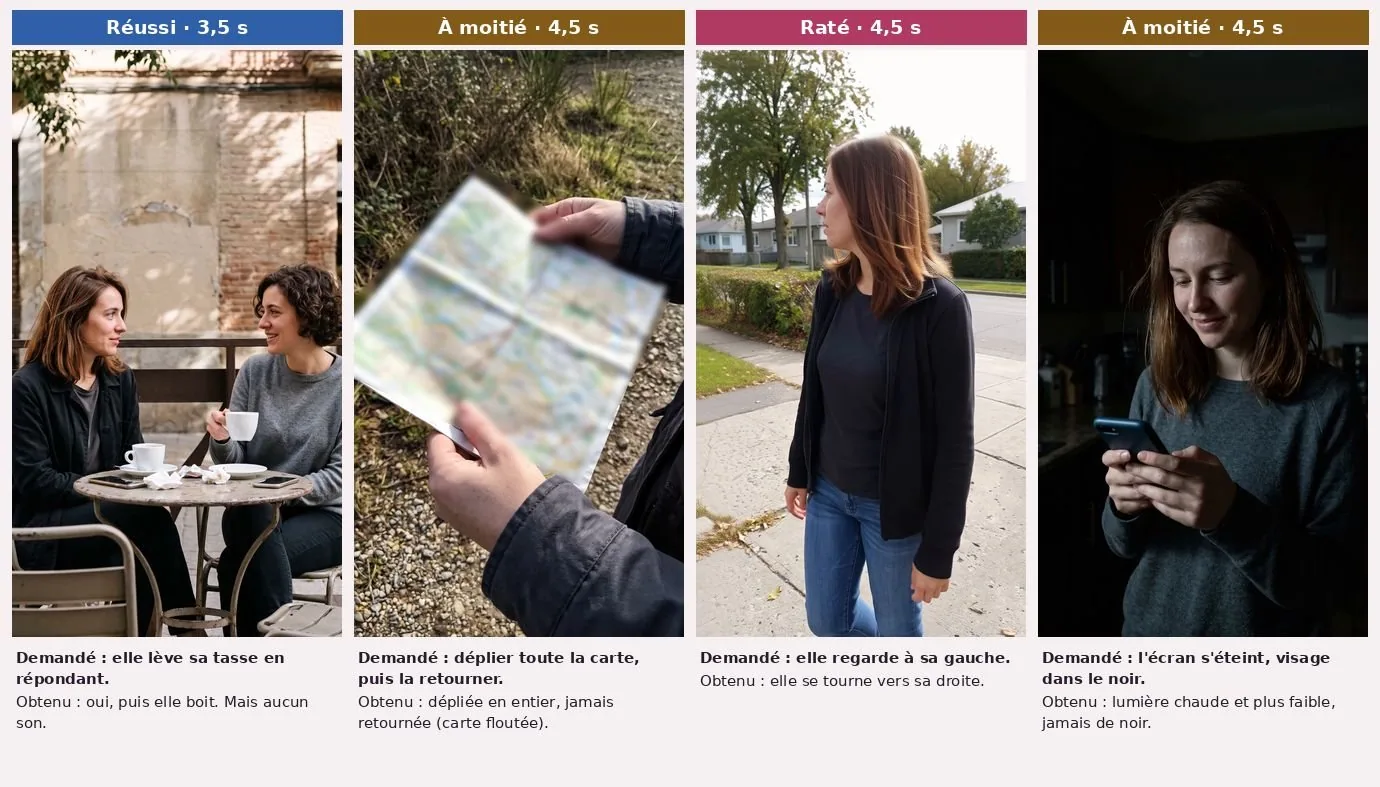
Face aux deux autres. Trottoir : LTX 2.5 se trompe de côté comme Wan ; seul MiniMax H3 regarde à sa gauche. Nuit : la lueur froide part vers 2 s chez LTX 2.5, 4 s chez Wan, 4,5 s chez MiniMax H3 ; aucun ne fait le noir, et chez Wan le visage perd entre un quart et un tiers de sa luminosité (notre mesure, selon la zone). Carte : LTX 2.5 ne l'ouvre jamais à plat, Wan la déplie, MiniMax H3 passe à une autre face.
Le son. Aucun : une piste image, rien d'autre, alors que nos prompts demandaient pas, oiseaux et frigo. LTX 2.5 et MiniMax H3 ont du son sur le même banc, et leurs deux répliques du café reviennent mot pour mot à la transcription. Dans la famille, seul S2V touche au son : il part d'un son qu'on lui donne, que Wan propose de fabriquer avec un outil de synthèse vocale à part, CosyVoice.
Le texte dans l'image. Nos prompts finissent par l'interdit « pas de texte », écrit en anglais. Mais la carte ouverte se couvre d'une douzaine d'étiquettes de faux texte ; l'une ressemble au nom d'une vraie petite ville. Sur nos images, la carte est floutée. Dans notre film, Wan A14B avait déjà inventé des sous-titres.
Ailleurs sur le site. Le croissant : en 20 étapes, le pigeon de Wan 2.2 ne vole rien. Le film open source : aucune prise Wan retenue, faute de son. Le refrain : S2V « reste quasi figé ».
Bon pour… mauvais pour…
- Bon pour les plans muets avec des mains : la carte dépliée en entier, doigts propres, là où LTX 2.5 ne l'ouvre jamais à plat. Et pour un budget moyen : 0,059 $ le plan, entre LTX 2.5 et MiniMax H3.
- Mauvais pour tout ce qui parle : pas de son, donc pas de dialogue.
- Mauvais pour une consigne précise : la tête part du mauvais côté, l'écran qui s'éteint n'est tenu qu'à moitié (comme chez les deux autres).
- Attention aux bords du cadre : une figurante entrée sans invitation dans notre film.
Mode rapide ou recette complète : ce que ça change
C'est LE point de cette fiche. Notre banc tourne en mode rapide : deux petits modules ajoutés (des LoRA « lightx2v ») font tenir le calcul en 4 étapes. La recette de Wan-AI en prévoit 40.
| Réglage | Wan-AI (code officiel) | Modèle officiel ComfyUI | Nous (banc du 26/10) |
|---|---|---|---|
| Étapes | 40 | 20, ou 4 avec l'accélérateur | 4 |
| Guidage (CFG) | 3,5 pour chaque expert | 3,5, ou 1 avec l'accélérateur | 1 |
| Passage au 2e expert | seuil de bruit (« boundary = 0.900 ») | étape 10 sur 20, ou 2 sur 4 | étape 2 sur 4 |
| Images | 81 à 16 i/s | 81 (5 s × 16 + 1) | 81, 5,06 s |
| Fichiers | poids d'origine de Wan-AI | fp8 de Comfy-Org | fp8 de Comfy-Org |
Ce que ça change pour toi.
- Le temps. Le 22/10, sur la même carte et au même format, le mode ComfyUI sans accélérateur (20 étapes) prenait 683 s de calcul par plan, contre 78 s en 4 étapes, sur deux scènes différentes. Le modèle officiel ComfyUI annonce un écart du même ordre sur une « RTX4090D 24GB », en 640 × 640 : « ≈ 513s » sans accélérateur, « ≈ 71s » avec, à la 2e génération.
- Le prix. 0,47 à 0,48 $ le plan en 20 étapes, contre 0,059 $ en 4 ; si tu fais 100 plans, environ 47 $ contre 5,94 $ (notre calcul).
- Le rendu. Sur notre verre de lait, le mode rapide pose une flaque trop tôt, le mode 20 étapes remplit sans une goutte ; aucun ne fait déborder un verre plein. Un tirage chacun : trop peu pour désigner un vainqueur.
- L'accélérateur n'est pas de Wan-AI : il vient de lightx2v, que Wan cite parmi les travaux de la communauté.
Matériel et coût
| Ce qu'on télécharge (six fichiers ComfyUI) | Taille |
|---|---|
| Expert « bruit fort », fp8 | 14,29 Go |
| Expert « bruit faible », fp8 | 14,29 Go |
| Accélérateur lightx2v, un par expert | 2 × 1,23 Go |
| Encodeur de texte umt5, fp8 | 6,74 Go |
| Décodeur vidéo (VAE de Wan 2.1) | 0,25 Go |
| Notre installation | 38,03 Go |
Gigaoctets décimaux, notre calcul depuis les octets ; mêmes tailles que la liste de Comfy-Org, empreintes SHA-256 vérifiées.
La carte. Wan-AI annonce au moins 80 Go de mémoire pour sa commande sur une carte (24 Go pour le 5B). Nous : une RTX PRO 6000 de 97 252 Mo ; ComfyUI y prépare 13,6 Go par expert, pic de mémoire non mesuré.
Le temps. Modèle chargé : 85,9 s par plan de 5 s, dont 77,9 s de calcul. Premier plan, chargement compris : 87,5 s, à peine plus ; le journal ne donne pas le chargement à part.
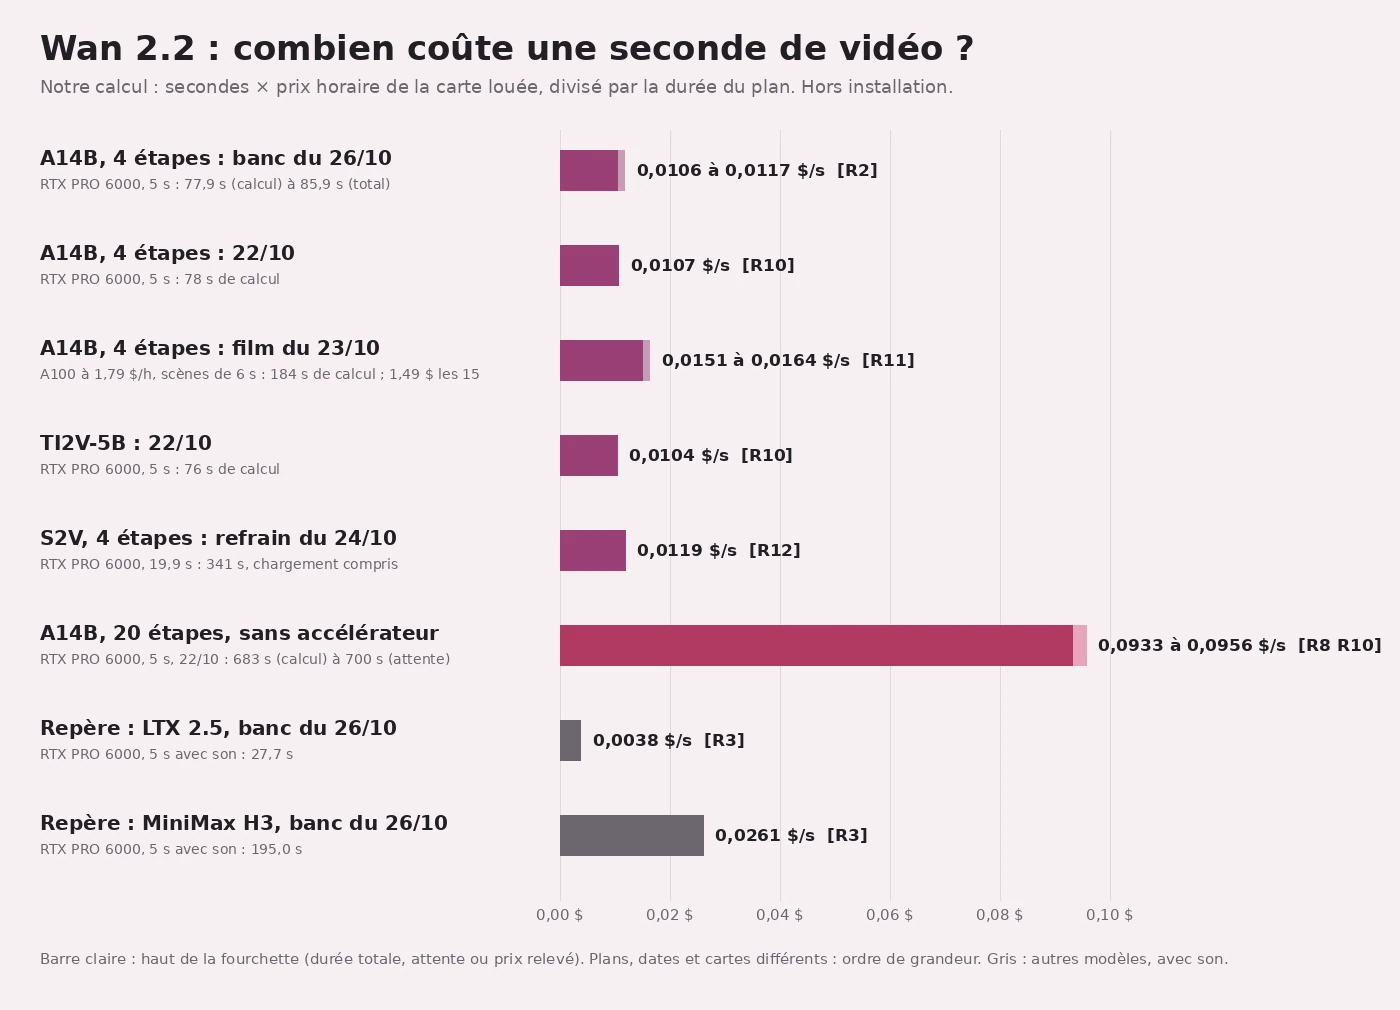
Le prix. Nos 4 vidéos du banc : 0,239 $, sur un pod qui a coûté 2,27 $ au prix horaire, pour quatre modèles. Sur une A100 à 1,79 $/h : 0,099 $ la scène de 6 s, 1,49 $ notre film de 15 scènes, génération seule. Le petit TI2V-5B, en 20 étapes : 0,053 $ le plan.
Face aux autres, même banc, même carte (modèle chargé, médianes) :
| Modèle | Temps par plan | Prix par plan | Prix par seconde | Format | Son |
|---|---|---|---|---|---|
| LTX 2.5 distillé | 27,7 s | 0,019 $ | 0,0038 $ | 704 × 1280, 24 i/s | oui |
| Wan 2.2 A14B rapide | 85,9 s | 0,059 $ | 0,0117 $ | 720 × 1280, 16 i/s | non |
| MiniMax H3 | 195,0 s | 0,135 $ | 0,0261 $ | 768 × 1344, 24 i/s | oui |
Licence
Wan 2.2 est sous Apache 2.0 : une licence « perpétuelle, mondiale, non exclusive, gratuite, libre de redevance, irrévocable », sans droit sur les marques (section 6) ni garantie (« EN L'ÉTAT »). Wan-AI ajoute : « Nous ne revendiquons aucun droit sur vos contenus générés » ; tu restes responsable de ton usage, qui ne doit pas diffuser de contenu illégal ou nuisible.
Usage commercial. Rien dans le texte ne le limite ni ne fixe de seuil de chiffre d'affaires.
Territoire. Licence « worldwide », aucune exclusion de pays dans le texte.
Télécharger
- Hugging Face, Wan-AI : Wan-AI/Wan2.2-I2V-A14B et les autres modèles de la famille, sans compte.
- GitHub, Wan-Video : Wan-Video/Wan2.2, le code officiel et ses réglages ; Animate-2 a son propre dépôt.
- ComfyUI : Comfy-Org/Wan_2.2_ComfyUI_Repackaged, « Fichiers de modèle réempaquetés pour ComfyUI », en fp16 et fp8, accélérateurs compris.
LoRA compatibles qu'on utilise
L'accélérateur lightx2v (le seul LoRA de notre banc) :
- Origine : lightx2v/Wan2.2-Lightning, version « Wan2.2-I2V-A14B-NFE4-V1 » publiée le 07/08/2025, rang 64, un fichier par expert. Comfy-Org en garde une copie renommée le 11/08/2025 : nos deux fichiers ont exactement les mêmes empreintes SHA-256 que ceux de lightx2v.
- Licence : « apache-2.0 » sur la page de lightx2v.
- Notre fichier : la copie Comfy-Org, 1,23 Go par expert, à pleine force.
- Réglages : 4 étapes « sans avoir besoin de l'astuce CFG » chez l'auteur, 4 étapes et CFG 1 chez nous. Effet : voir plus haut.
Aucun LoRA de personnage testé sur Wan. Wan déconseille d'ailleurs les LoRA de Wan 2.2 sur Animate.
Nos images de test
Wan 2.2 sur notre mini banc vidéo : quatre plans, quatre instants
Mini banc vidéo commun du 26/10/2026 : mêmes quatre images de départ pour tous les modèles, prompts en anglais, graine 2210, un tirage, aucun LoRA de personnage. Wan 2.2 I2V A14B en mode rapide : fichiers fp8 de Comfy-Org, accélérateur lightx2v en 4 étapes, CFG 1, sur une RTX PRO 6000 louée 2,49 $/h. Ce n'est pas la recette complète de l'éditeur (40 étapes). Images fixes tirées des vidéos avec ffmpeg à 0,5, 2,0, 3,5 et 5,0 s, sans recadrage ni retouche, sauf la carte floutée à 3,5 et 5,0 s (faux texte). Wan 2.2 ne fait pas de son : ces vidéos sont muettes.
Wan 2.2 A14B rapide 720 × 1280 · 16 i/s · 5 s muettes · 4 étapes · environ 86 s et 0,059 $ le plan
En pied
À moitié : elle s'approche de l'objectif sans à-coup, puis tourne la tête et le buste vers sa droite, alors que le prompt disait sa gauche. À la fin, on la voit de trois quarts dos, le visage caché.
Deux personnages
Les gestes sont justes : la femme bouclée prend sa tasse, la lève puis boit, visages stables. Mais Wan 2.2 ne fait pas de son : les deux répliques en français n'existent pas.
Mains et objet
À moitié : les doigts restent corrects et la carte finit dépliée en entier, à plat, vers 3,5 s. Mais elle n'est jamais retournée. Dès qu'elle est ouverte, des étiquettes de faux texte apparaissent : on a flouté la carte.
Nuit
À moitié : la lueur froide reste sur son visage jusqu'à 3,5 s environ, puis une lumière chaude et plus faible la remplace, téléphone toujours en main. Le visage perd entre un quart et un tiers de sa luminosité selon la zone mesurée, il ne tombe jamais dans le noir.
- Images entières : seule la carte est floutée, pour son faux texte.
L'avis de Milky
Wan 2.2, c'est le figurant appliqué : des mains propres, pas de voix, et quand tu lui dis « à gauche », il part à droite. Meilleur que les grands modèles fermés, dit Wan-AI, sur son propre banc. Sur le mien, il coûte trois fois LTX 2.5, qui, lui, parle. Mon usage : les plans muets, les mains, les inserts sous une musique. Pour parler, LTX 2.5 ; pour un regard précis, MiniMax H3. Pour qui : ceux qui veulent une licence simple et louent une grosse carte. Prochain duel prévu : « LTX 2.5 ou Wan 2.2 ? ». Je ferme le carnet. Lui, de toute façon, n'a rien à ajouter.
Ce qu'on ne sait pas encore
- La recette de Wan-AI (40 étapes) sur notre banc : temps, prix, rendu.
- Plusieurs tirages, et le même plan en 4 et en 20 étapes.
- Le texte → vidéo, Animate, Animate-2, le 480p, les autres accélérations.
- Le pic de mémoire, une carte grand public, un LoRA de personnage.
Les mots à retenir
- Experts (« Mixture-of-Experts ») : deux modèles qui se passent le relais, l'un pour la mise en place, l'autre pour les détails.
- CFG (guidage) : le réglage qui dit à quel point le modèle suit ton prompt ; 3,5 dans la recette de Wan-AI, 1 avec l'accélérateur.
- LoRA d'accélération : petit module ajouté au modèle pour générer en peu d'étapes.
- fp8 : poids rangés sur 8 bits, deux fois plus légers que le fp16 (14,29 Go contre 28,58 Go par expert).
Tous nos mots expliqués : le glossaire →
Passages sources
Afficher les 30 sources
| Réf. | Citation (langue originale) | URL |
|---|---|---|
| S1↑1↑2↑3↑4↑5↑6+6 | "Jul 28, 2025: 👋 We've released the inference code and model weights of Wan2.2." ; "Wan2.2 introduces a Mixture-of-Experts (MoE) architecture into video diffusion models" ; "a high-noise expert for the early stages, focusing on overall layout; and a low-noise expert for the later stages, refining video details" ; "Each expert model has about 14B parameters, resulting in a total of 27B parameters but only 14B active parameters per step" ; "Cinematic-level Aesthetics" ; "This repository also includes our I2V-A14B model, designed for image-to-video generation, supporting both 480P and 720P resolutions." ; "This command can run on a GPU with at least 80GB VRAM." ; "We compared Wan2.2 with leading closed-source commercial models on our new Wan-Bench 2.0 […] Wan2.2 achieves superior performance compared to these leading models." ; "The models in this repository are licensed under the Apache 2.0 License. We claim no rights over the your generated contents, granting you the freedom to use them while ensuring that your usage complies with the provisions of this license. You are fully accountable for your use of the models, which must not involve sharing any content that violates applicable laws, causes harm to individuals or groups" | https://huggingface.co/Wan-AI/Wan2.2-I2V-A14B |
| S2↑ | "This repository contains our T2V-A14B model, which supports generating 5s videos at both 480P and 720P resolutions." | https://huggingface.co/Wan-AI/Wan2.2-T2V-A14B |
| S3↑1↑2 | "This model supports both text-to-video and image-to-video generation at 720P resolution with 24fps" ; "This command can run on a GPU with at least 24GB VRAM (e.g, RTX 4090 GPU)." | https://huggingface.co/Wan-AI/Wan2.2-TI2V-5B |
| S4↑1↑2 | "Wan2.2-S2V-14B: Audio-Driven Cinematic Video Generation" ; "designed for audio-driven cinematic video generation" | https://huggingface.co/Wan-AI/Wan2.2-S2V-14B |
| S5↑ | "Wan-Animate takes a video and a character image as input, and generates a video in either "animation" or "replacement" mode." | https://huggingface.co/Wan-AI/Wan2.2-Animate-14B |
| S6↑1↑2 | "August 07, 2026: 🎉 We release the Wan-Animate-2 Base model weights." ; "August 07, 2026: 🎉 We release the Wan-Animate-2 Distillation model weights." ; "git clone --recursive https://github.com/Wan-Video/Wan-Animate-2.git" ; "license: apache-2.0" | https://huggingface.co/Wan-AI/Wan2.2-Animate-2-14B |
| S7↑1↑2↑3 | API, auteur Wan-AI : Wan2.2-T2V-A14B, Wan2.2-I2V-A14B, Wan2.2-TI2V-5B, Wan2.2-S2V-14B, Wan2.2-Animate-14B, Wan2.2-Animate-2-14B (+ versions « -Diffusers ») ; 27 dépôts, aucun Wan 3 | https://huggingface.co/api/models?author=Wan-AI |
| S8↑1↑2↑3↑4↑5↑6 | "Sep 19, 2025: 💃 We introduct [Wan2.2-Animate-14B] […] an unified model for character animation and replacement" ; "LightX2V, a lightweight and efficient video generation framework that integrates Wan2.1 and Wan2.2" ; "If you're using Wan-Animate, we do not recommend using LoRA models trained on Wan2.2" ; "Sep 5, 2025: 👋 We add text-to-speech synthesis support with CosyVoice for Speech-to-Video generation task." ; "LightX2V-HuggingFace, offers a variety of Wan-based step-distillation models" | https://github.com/Wan-Video/Wan2.2 |
| S9↑1↑2↑3↑4↑5↑6+2 | "i2v_A14B.sample_shift = 5.0" ; "i2v_A14B.sample_steps = 40" ; "i2v_A14B.boundary = 0.900" ; "i2v_A14B.sample_guide_scale = (3.5, 3.5) # low noise, high noise" ; "wan_shared_cfg.sample_fps = 16" ; "wan_shared_cfg.frame_num = 81" | https://github.com/Wan-Video/Wan2.2/blob/main/wan/configs/wan_i2v_A14B.py |
| S10↑1↑2↑3↑4↑5 | "Apache License Version 2.0, January 2004" ; "a perpetual, worldwide, non-exclusive, no-charge, royalty-free, irrevocable copyright license" ; "6. Trademarks. This License does not grant permission to use the trade names, trademarks, service marks, or product names of the Licensor" ; "on an "AS IS" BASIS" | https://github.com/Wan-Video/Wan2.2/blob/main/LICENSE.txt |
| S11↑1↑2↑3↑4↑5↑6+1 | "Repackaged model files for ComfyUI." ; base_model : "lightx2v/Wan2.2-Distill-Loras" ; API : wan2.2_i2v_high_noise_14B_fp8_scaled 14294742832 octets, _fp16 28577914792, wan2.2_i2v_lightx2v_4steps_lora_v1_high_noise 1226977424 (« Rename split_files/loras/Wan2.2_I2V_A14B_4steps_lora_rank64_… »), umt5_xxl_fp8_e4m3fn_scaled 6735906897, wan_2.1_vae 253815318 | https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged |
| S12↑1↑2↑3↑4↑5↑6+2 | Modèle ComfyUI video_wan2_2_14B_i2v : "Enable 4steps LoRA?" [false] ; "Int (Steps)" 20 / 4 ; "Float (CFG)" 3.5 / 1 ; "Int (split_step)" 10 / 2 ; ModelSamplingSD3 5 ; "floor (a * b + 1)" avec 5 s et 16 i/s ; note "GPU:RTX4090D 24GB" : "fp8_scaled |640*640| 84% | ≈ 536s | ≈ 513s" et "fp8_scaled + 4steps LoRA | 640*640 | 83% | ≈ 97s | ≈ 71s" ; historique : dernier envoi "2026-09-28" ; "Update Quiver templates (#807)" le "2026-04-17" (interrupteur passé de true à false) ; version du 2026-03-12 : "Enable 4steps LoRA?" [true] ; version du 2025-09-23 : branche 4 étapes active, branche 20 étapes désactivée | https://github.com/Comfy-Org/workflow_templates/blob/main/templates/video_wan2_2_14B_i2v.json |
| S13↑ | "LoRA weights extracted from Wan2.2 distilled models" ; API : "createdAt":"2025-10-16T07:23:10.000Z" ; fichiers image → vidéo "wan2.2_i2v_A14b_high_noise_lora_rank64_lightx2v_4step_1022.safetensors" 634645944 octets et "…low_noise…_1022.safetensors" 739472104 octets | https://huggingface.co/lightx2v/Wan2.2-Distill-Loras |
| S14↑1↑2 | API : "gated":false ; "createdAt":"2025-07-24T07:51:43.000Z" ; "lastModified":"2025-08-07T09:42:48.000Z" | https://huggingface.co/api/models/Wan-AI/Wan2.2-I2V-A14B |
| S15↑1↑2↑3↑4↑5↑6+2 | "license: apache-2.0" ; "Video generation now requires only 4 steps without the need of CFG trick, leading to x20 speed-up" ; "Aug 07, 2025: 👋 Release of [Wan2.2-I2V-A14B-NFE4-V1]" ; "The models in this repository are licensed under the Apache 2.0 License." ; API : Wan2.2-I2V-A14B-4steps-lora-rank64-Seko-V1/high_noise_model.safetensors 1226977424 octets, "oid":"d176c808d6fc461999b68e321efcb7501b20b8c3797523ed0df14f7d1deff11e" ; low_noise_model.safetensors 1226977424 octets, "oid":"024f21de095bc8fad9809ded3e9e49a2e170dcf27075da8145ba7d60d8aab7f9" | https://huggingface.co/lightx2v/Wan2.2-Lightning |
| R1↑1↑2↑3↑4↑5↑6+11 | Protocole du mini banc vidéo V0 (26/10/2026) : ComfyUI 0.42.0, RTX PRO 6000 Blackwell à 2,49 $/h, « Total VRAM 97252 MB » ; Wan 2.2 I2V A14B fp8 + LoRA lightx2v 4 étapes à 1,0 ; 4 étapes, bascule à 2, CFG 1, shift 5, euler/simple, négatif par défaut ; 720 × 1280, 81 images, 16 i/s ; graine 2210, un tirage ; « réglage par défaut du modèle » dans nos fiches ; prompts cités | — (test maison) |
| R2↑1↑2↑3↑4↑5↑6+1 | Temps et prix des 4 vidéos : médianes 85,9 s, 77,9 s de calcul, 0,0594 $ ; 1re vidéo 87,5 s, 82,0 s, 0,0605 $ ; somme 0,2394 $ ; 0,0117 $/s (total), 0,0106 $/s (calcul) ; 2 × 33 s pour les étapes | — (test maison) |
| R3↑1↑2↑3↑4↑5 | Même banc : LTX 2.5 27,7 s, 0,0192 $ ; MiniMax H3 195,0 s, 0,1349 $ ; rapports 3,1 et 2,3 ; échelles 100 plans, notre calcul | — (test maison) |
| R4↑1↑2↑3↑4↑5 | Six fichiers, 38 033 162 727 octets ; « sha256 identiques : 20/20 » ; LoRA : sha256 d176c808… (bruit fort) et 024f21de… (bruit faible) ; « WAN21 … 13630MB Staged » par expert, « WanTEModel … 6419MB Staged » ; pic de mémoire non relevé | — (test maison) |
| R5↑1↑2↑3↑4↑5↑6+7 | Relecture des 4 vidéos Wan toutes les 0,5 s (images n° 0, 8, 16…), pleine taille, zooms ; tête vers sa droite (v1) ; tasse prise, levée, bue (v2) ; carte dépliée à plat dès 3,5 s, même face, étiquettes de faux texte (v3) ; teinte +6/+9 jusqu'à 3,0 s puis −24/−28 dès 4,0 s, luminance du visage 78-80 puis 52-54 (v4) ; même mesure chez LTX 2.5 (bascule à 2,0 s) et MiniMax H3 (4,5 s) ; vérification : bascule entre 3,5 et 4,0 s, visage −27 % (20 % de pixels les plus clairs de la tête) à −35 % (cadre fixe sur la joue) ; trottoir des deux autres revu | — (test maison) |
| R6↑1↑2↑3↑4↑5↑6+1 | ffprobe : les 4 vidéos Wan « h264,video » sans piste son ; LTX 2.5 « aac,audio,48000,2 », MiniMax H3 « aac,audio,32000,2 » | — (test maison) |
| R7↑ | Transcription du café (26/10/2026) : LTX 2.5 et MiniMax H3, « Tu viens avec moi demain ? Oui, mais c'est toi qui conduis » | https://siliciumrose.fr/articles/ltx-2-5.html |
| R8↑1↑2↑3 | 22/10/2026, A14B en 20 étapes, CFG 3,5, sans accélérateur : « 1279 », « 701 », « 700 » s ; « 0,88 $ puis 0,48 $ » ; « Le croissant ne bouge pas jusqu'à la fin » | https://siliciumrose.fr/articles/comparatif-video-flux-wan.html |
| R9↑1↑2↑3 | Relecture « bureau » : tenues normales, décors génériques, aucune marque ; carte floutée, aucun texte recopié | — (test maison) |
| R10↑1↑2↑3↑4↑5↑6 | 22/10/2026 : TI2V-5B « 99 s* / 76 s », « 0,068 $ / 0,053 $ » ; A14B rapide « 190 s* / 78 s », « 0,131 $ / 0,054 $ » ; A14B qualité « 683 s », « 0,472 $ » (100 plans : 47,20 $, notre calcul) ; lait : « pose une flaque au pied du verre dès 1 s », « remplit sans une goutte », « aucun ne fait déborder un verre plein » | https://siliciumrose.fr/articles/sept-modeles-video-open-source.html |
| R11↑1↑2↑3↑4↑5 | 23/10/2026, A100 à 1,79 $/h : TI2V-5B « 1,20 $ », « 153 s » ; A14B rapide « 1,49 $ », « 184 s » ; « fait entrer une jeune femme absente de l'image de départ » ; « ajoute aussi des sous-titres en haut de la scène 14 » ; « Pas de Wan, muets. » | https://siliciumrose.fr/articles/film-ia-open-source.html |
| R12↑1↑2 | 24/10/2026 : S2V (LoRA 4 étapes) « 341 s pour 19,5 s », « ≈ 0,24 $ », « reste quasi figé », « seule la bouche travaille » | https://siliciumrose.fr/articles/faire-chanter-un-personnage-4-modeles-libres.html |
| R13↑ | Registre des coûts : « banc video V0 session O1 … 54 min 40 s x 2,49 $/h (LTX 2.5, Wan 2.2 A14B, MiniMax H3 x4 ; HunyuanVideo 1.5 50 etapes x1) » 2,270 $ | — (relevé interne) |
| R14↑1↑2 | Pas testé : recette de Wan-AI en 40 étapes, fp16, T2V, Animate, Animate-2, autres accélérations, 480p, LoRA de personnage, plusieurs graines, pic de mémoire, carte grand public | — (test maison) |
| R16↑ | Wan 3.0 : « non trouvés le 22/10 » ; aucun dépôt Wan 3 chez Wan-AI le 26/10 ; utilisé seulement par API | https://siliciumrose.fr/articles/comparatif-video-flux-wan.html |
Je ne crois pas une démo. Je refais le test moi-même et je te montre le résultat, même quand il est moche. Et ne me mets pas en colère, tu ne vas pas aimer la suite.