MiniMax H3 : le seul qui tourne la tête du bon côté, mais 2,1 à 3,3 fois plus cher que LTX 2.5 en mode rapide
195 secondes. C'est le temps que MiniMax H3 met pour rendre un plan de 5 secondes, aux réglages par défaut. LTX 2.5, lui, en met 28. Bon. MiniMax H3, c'est le modèle ouvert qu'on sort quand on veut du joli et qu'on a le temps. Je l'ai remis sur notre mini banc, face à trois autres. Verdict : le plus obéissant de la bande, il parle juste, mais il coûte plus cher que LTX 2.5. Aux réglages par défaut, c'est sept fois plus : 0,135 $ contre 0,019 $ le plan de 5 s, 195 s de calcul contre 28 s. Sauf que ce premier match n'était pas à armes égales : avec son LoRA turbo, MiniMax tombe à 0,040 $ et 58,3 s en 4 étapes (0,063 $ et 91,2 s en 8), contre 0,019 $ et 27,4 s pour LTX 2.5, soit 2,1 fois plus en 4 étapes. Si tu fais 100 plans : 4,03 $ contre 1,90 $. Et sur nos quatre essais, nos LoRA de personnages ne lui changent presque rien.
Fiche modèle. Pages officielles relevées le 26/10/2026 ; nos tests du 26/10/2026 sur Runpod, et nos tournages du 22 au 25/10/2026. Fiche mise à jour le 06/11/2026 ; mode turbo testé le 02/11/2026.
 MilkyCelle qui teste · Image, vidéo et ComfyUI
Vérifié par une 2e IA
En bref
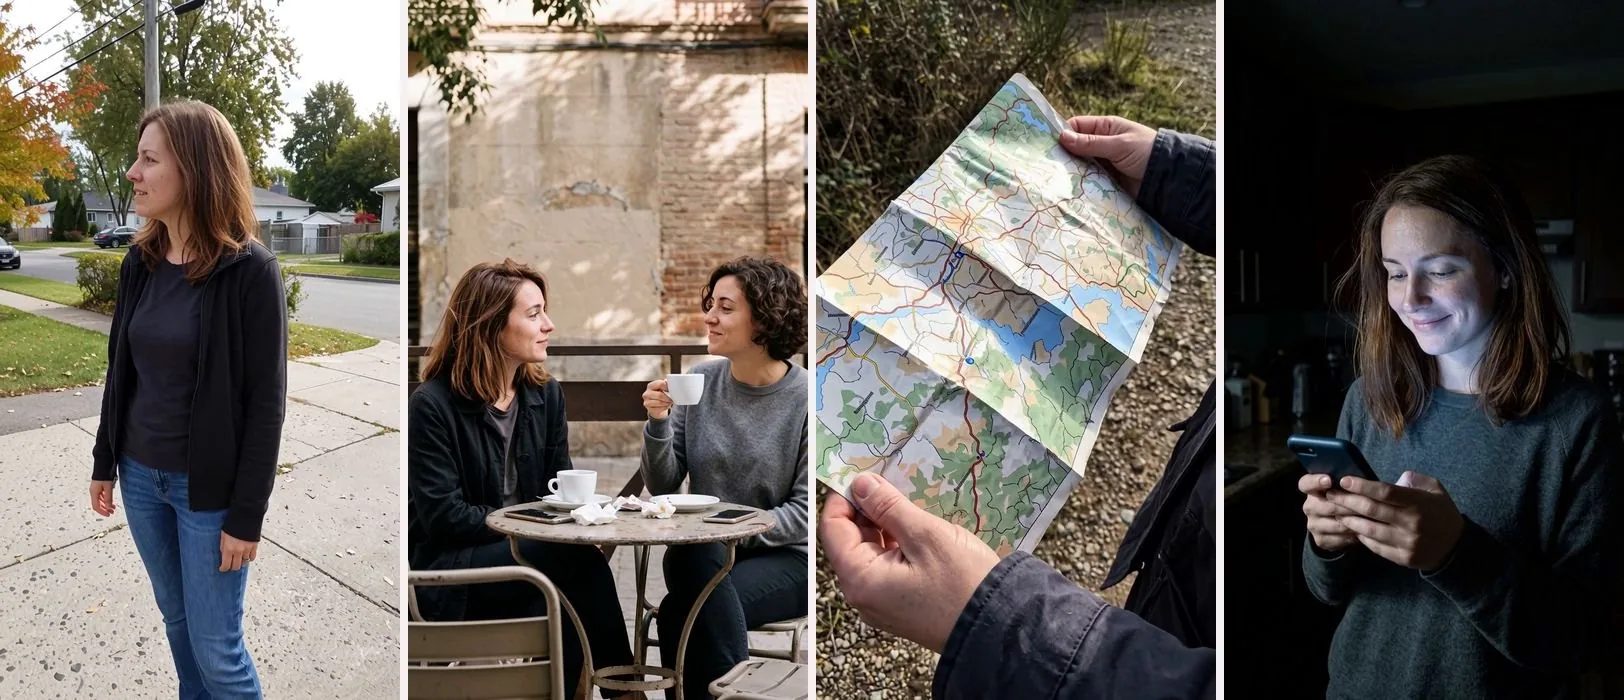
- Un modèle vidéo à poids ouverts de MiniMax, qui fait l'image et le son stéréo ensemble. Sur nos 4 plans : marche réussie (le seul à regarder à sa gauche, comme demandé), répliques mot pour mot, carte presque réussie, nuit à moitié.
- Chez nous, sur une RTX PRO 6000 louée 2,49 $/h, aux réglages par défaut (20 étapes) : environ 195 s et 0,135 $ le plan de 5 s avec son, soit 0,026 $ la seconde (médianes, notre calcul : durée × prix horaire). C'est sept fois le temps et le prix de LTX 2.5 (28 s, 0,019 $) ; pour une minute de film (12 plans de 5 s), compte 39 min et 1,62 $, contre 5 min 32 et 0,23 $ (notre calcul).
- À armes égales, avec le LoRA turbo (test du 02/11/2026) : 58,3 s et 0,040 $ en 4 étapes, 91,2 s et 0,063 $ en 8 étapes, contre 27,4 s et 0,019 $ pour LTX 2.5 : 2,1 fois plus en 4 étapes, 3,3 fois en 8. Si tu fais 100 plans : 4,03 $ contre 1,90 $ en 4 étapes, 6,31 $ en 8 étapes ; au réglage par défaut, 13,49 $ contre 1,92 $. Détail dans le match en mode rapide.
- La version ouverte n'a ni le module qui réécrit les consignes, ni la 2K : pour l'instant, ils restent sur l'API de MiniMax. Nos LoRA de personnages (environ 19 minutes chacun) changent peu le résultat, sur un essai par personnage.
| Carte d'identité | |
|---|---|
| Nom, version testée | MiniMax H3, point de contrôle « FL2VA » (texte ou image vers vidéo + son), en int8 « pruned » pour ComfyUI |
| Éditeur | MiniMax (« MiniMaxAI » sur Hugging Face) |
| Sortie | « MiniMax H3 release date/License date: August 2, 2026 » ; dépôt Hugging Face créé le 28/07/2026 |
| Type | Transformeur de 33 milliards de paramètres, dont environ 13 qu'on peut ne pas charger pour générer ; texte lu par Qwen3-VL-32B |
| Ouvert ou fermé | Poids téléchargeables sans compte ; deux points de contrôle, FL2VA et Ref2VA (vidéo depuis des références) |
| Prix officiel | Aucun prix par vidéo en local ; une API chez MiniMax, prix non relevé |
| Où on l'a fait tourner | Runpod (lien parrainé), ComfyUI 0.42.0, NVIDIA RTX PRO 6000 Blackwell |
Ce qu'il sait faire
La promesse. MiniMax le présente comme « a general-purpose, omni-modal generative system », capable de faire de la vidéo « avec un audio stéréo natif à des résolutions jusqu’à 2K et des durées jusqu’à 15 secondes ». Son en 32 kHz stéréo, 24 images par seconde, et un support « stable » de onze langues de dialogue, dont le français.
Ce que la version ouverte n'a pas. Le système complet a trois étages. Le premier, H3-Context-IR, réécrit tes consignes : « critique pour la qualité du résultat final », dit MiniMax, mais « non inclus dans cette version open source ». Le dernier, la 2K, est « pas encore passé en open source ». En local, reste l'étage du milieu, en 768p. Nous : prompts écrits à la main.
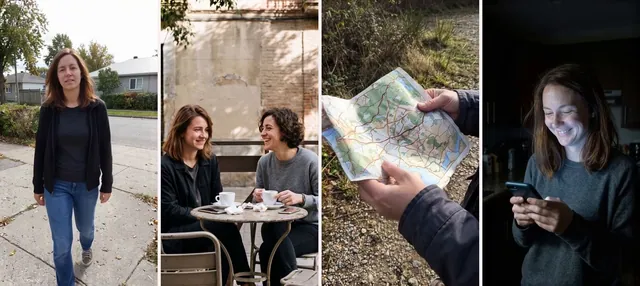
Nos quatre plans. Mêmes images de départ et mêmes consignes pour tous les modèles du banc, un seul tirage :
| Plan demandé | MiniMax H3 |
|---|---|
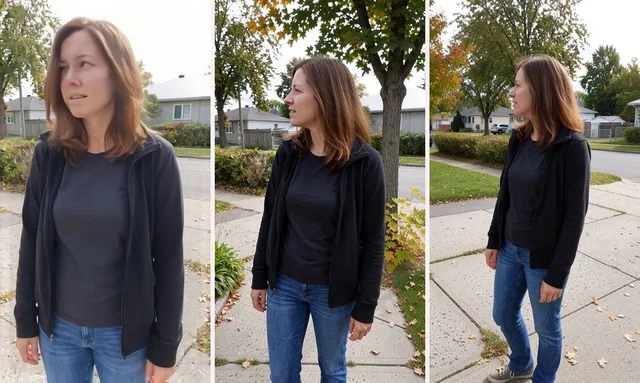
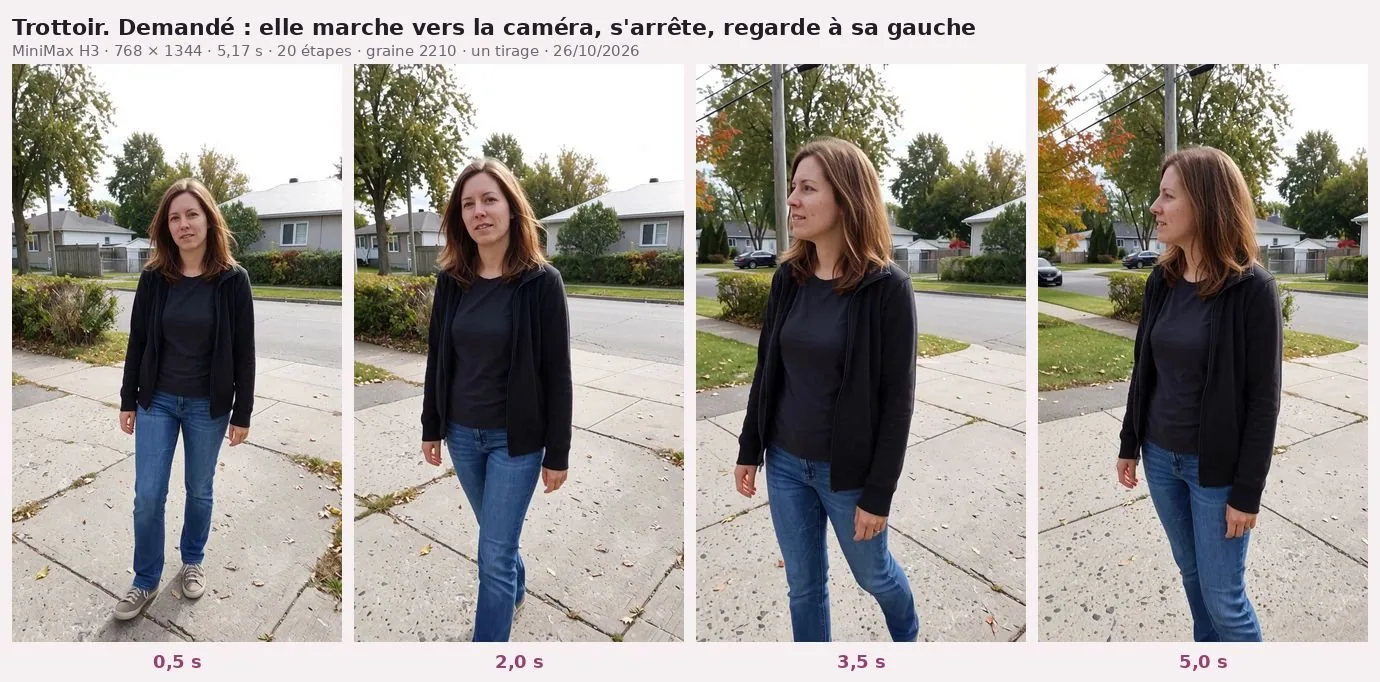
| Marcher vers la caméra, s'arrêter, regarder à gauche | Oui : vers 3 s, la tête tourne vers sa gauche. Le seul des quatre modèles du banc ; avec le turbo 4 et 8 étapes aussi (02/11) |
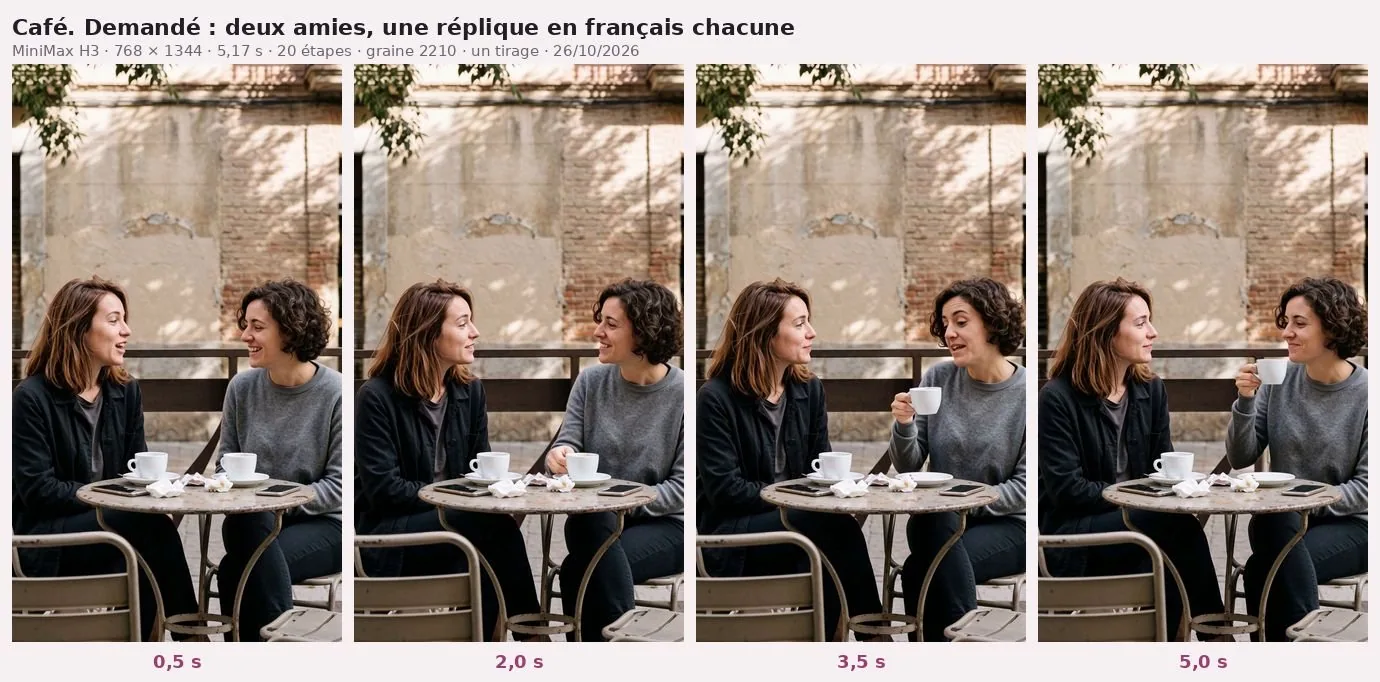
| Deux amies, une réplique en français chacune, une tasse levée | Oui : répliques mot pour mot, la bonne bouche qui bouge ; tasse levée en répondant |
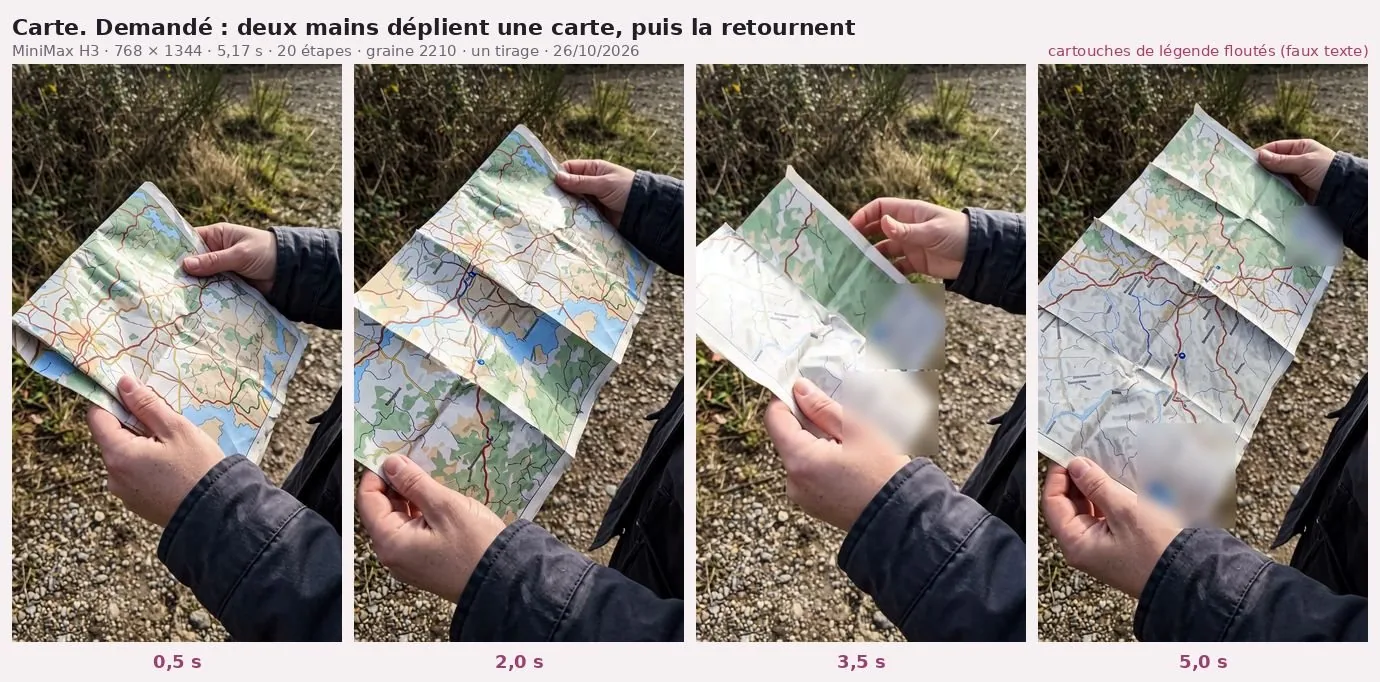
| Déplier toute la carte, puis la retourner | Presque : dépliée vers 2 s, repliée vers 3 s, une autre face à 3,5 s ; pas de vrai geste de retournement |
| Visage éclairé par le téléphone, puis l'écran s'éteint et le visage tombe dans le noir | À moitié : la lueur froide quitte son visage vers 4,5 s, une lumière chaude la remplace ; téléphone en main, jamais de noir |
Relecture image par image (toutes les 0,5 s, pleine taille), 26/10/2026.
Le son et la diction. Piste stéréo à 32 kHz sur les quatre vidéos, comme annoncé. Sur le café, notre outil de transcription (Scribe v2) rend « Tu viens avec moi demain ? Oui, mais c'est toi qui conduis », zéro mot faux, mais n'entend qu'une voix, quand il en entendait deux chez LTX 2.5. À l'œil, chaque réplique tombe sur la bonne bouche. Un tirage, et l'outil peut se tromper : un indice, pas une preuve. Sur la marche, la piste est plus forte : −43,7 dB de volume moyen, contre −50,0 dB chez LTX (une mesure de volume, pas une écoute). En turbo, la diction du café est mesurée (02/11) : en 4 comme en 8 étapes, les deux répliques sortent en entier et justes, selon deux transcripteurs automatiques indépendants (Gemini, Whisper small) sur le son seul de la vidéo, qui retrouvent aussi la transcription Scribe du rendu du 26/10. Ces transcripteurs peuvent inventer des paroles sur un bruit (contrôle fait) ; ici les deux concordent mot pour mot. Mesuré : les mots prononcés. Pas mesuré : la synchronisation des lèvres, le timbre.
Le texte dans l'image. Nos prompts finissent par « no text ». Sur la carte, il a quand même dessiné deux cartouches de légende en faux texte, illisibles ; floutés par précaution. Il sème aussi sur la carte de petites hachures qui imitent des noms de lieux, sans une lettre lisible.
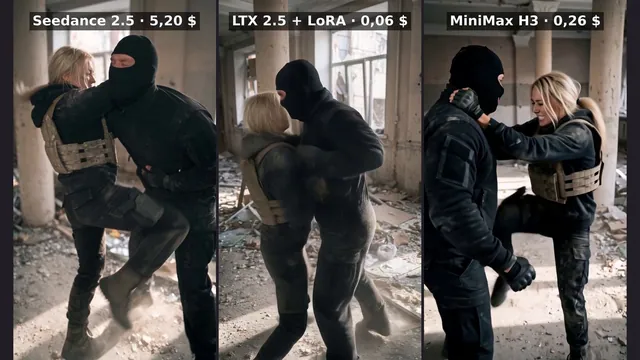
Ailleurs sur le site. Sept modèles vidéo : la crêpe la plus complète. Le refrain : « le rendu le plus détaillé », 19 min 50 contre 1 min 32 pour 15 s (environ 0,82 $ contre 0,06 $), 13 fois plus lent que LTX 2.5. Le duel contre Seedance : de vrais coups… et le mauvais vainqueur au sol.
Bon pour… mauvais pour…
- Bon pour suivre une consigne de regard ou de geste : le seul à tourner la tête du bon côté, le seul à montrer l'autre face de la carte, même sans vrai geste de retournement (trois modèles ont fait ce plan).
- Bon pour deux personnes qui se parlent : répliques justes, visages stables ; LTX 2.5 tient aussi les deux répliques, sept fois plus vite aux réglages par défaut (28 s contre 195 s), 2,1 fois plus vite face au turbo 4 étapes (27,4 s contre 58,3 s).
- Plus lent et plus cher pour tourner en volume : aux réglages par défaut, 195 s et 0,135 $ le plan, contre 28 s et 0,019 $ chez LTX 2.5 ; en turbo 4 étapes, 58,3 s et 0,040 $ contre 27,4 s et 0,019 $, soit 2,13 $ de plus pour 100 plans (4,03 $ contre 1,90 $).
- Attention à la durée : 185 s de calcul pour 5 s, 382 s pour 8 s : deux fois plus de calcul pour 1,55 fois plus de vidéo (notre calcul sur deux séries différentes : un indice, pas une règle).
- Mauvais pour un événement précis : « l’écran s’éteint et son visage tombe dans l’obscurité », tenu à moitié, comme chez LTX 2.5 et Wan 2.2.
- Mauvais pour imposer un visage par LoRA : sur nos quatre essais en image → vidéo, il change peu ce que l'image de départ donne déjà.
Réglages conseillés
| Réglage | L'éditeur et ComfyUI | Nous (banc du 26/10) |
|---|---|---|
| Taille | côté court de 768 px ; ComfyUI s'ouvre à 0,4 mégapixel, « 1344 × 768 » pour la qualité native | 768 × 1344 vertical |
| Durée | « 4–15 seconds » ; 5 s = 124 images, 5,17 s | 5,17 s |
| Étapes | 20 sans turbo ; 8 avec le turbo en image → vidéo | 20, turbo coupé (26/10) ; 4 et 8 avec le LoRA turbo (02/11) |
| Guidage | points de contrôle « CFG-distilled » | pas de CFG, pas de prompt négatif |
| Fichier du modèle | « pruned_int8_convrot » | le même |
| Préparation du prompt | H3-Context-IR, « strongly recommend » | aucune, prompt à la main |
- Le son veut des étapes : « La parole et le timbre nécessitent 12 étapes ou plus ». Nos 20 passent.
- Le turbo, tel qu'on l'a lancé le 02/11 : LoRA turbo 4 ou 8 étapes (variante 768p, force 1,0), décalage (shift) 6 pour la vidéo et 3 pour l'audio, euler + simple, sans guidage CFG, 768 × 1344, sans LoRA de personnage.
- À refaire avec : la préparation des consignes, et « Sage Attention », donnée pour « roughly 2× » plus rapide.
Matériel et coût
| Ce qu'on télécharge (quatre fichiers ComfyUI) | Taille |
|---|---|
| Transformeur FL2VA « pruned », int8 | 20,97 Go |
| Encodeur de texte Qwen3-VL-32B, nvfp4 | 15,69 Go |
| Décodeur vidéo int8 + décodeur audio fp32 | 2,81 + 0,61 Go |
| Notre installation | 40,07 Go |
Gigaoctets décimaux, notre calcul depuis les octets ; mêmes tailles que la liste officielle de Comfy-Org.
Pourquoi « pruned ». En bf16, 66,28 Go complet, 40,23 Go « pruned » : à 2 octets le poids, 33 puis 20 milliards, les 13 milliards qu'on peut ne pas charger (notre calcul).
La carte. Aucune carte minimale écrite ; l'exemple de MiniMax tourne sur quatre cartes (« --num-gpus 4 »), la doc ComfyUI conseille la plus petite version « qui tient dans la VRAM ». Nous : une RTX PRO 6000 Blackwell, 97 252 Mo ; pic de mémoire non mesuré.
Le temps. Modèle chargé : 195,0 s par plan de 5 s, dont 185,1 s de calcul, surtout 20 étapes de 8,8 s. Premier plan, chargement compris : 203,6 s.
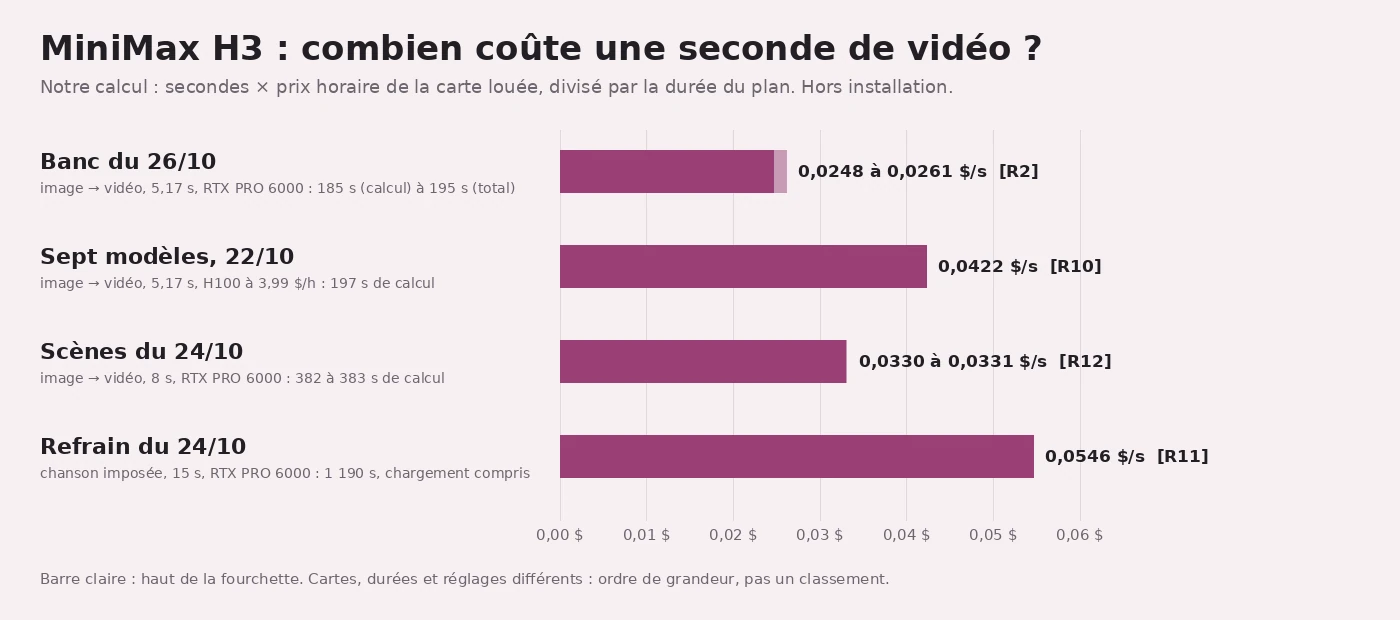
Le prix. Par plan : 0,135 $ les 5 s ; 0,26 $ les 8 s ; environ 0,82 $ les 15 s avec chanson imposée, chargement compris ; 0,218 $ les 5 s sur une H100 à 3,99 $/h. Nos 4 vidéos du banc : 0,546 $.
Face aux autres, même banc, même carte (modèle chargé, médianes) :
| Modèle | Temps par plan | Prix par plan | Format | Son |
|---|---|---|---|---|
| LTX 2.5 distillé | 27,7 s | 0,019 $ | 704 × 1280, 24 i/s | oui |
| Wan 2.2 A14B rapide | 85,9 s | 0,059 $ | 720 × 1280, 16 i/s | non |
| MiniMax H3 | 195,0 s | 0,135 $ | 768 × 1344, 24 i/s | oui |
| HunyuanVideo 1.5 (un plan, chargement compris) | 1 869,9 s | 1,29 $ | 720 × 1280, 24 i/s | non |
| Banc du 02/11 : LTX 2.5 distillé, encodeur officiel | 27,4 s | 0,019 $ | 704 × 1280, 24 i/s | oui |
| Banc du 02/11 : MiniMax H3 turbo 4 étapes | 58,3 s | 0,040 $ | 768 × 1344, 24 i/s | oui |
| Banc du 02/11 : MiniMax H3 turbo 8 étapes | 91,2 s | 0,063 $ | 768 × 1344, 24 i/s | oui |
Les quatre premières lignes : banc du 26/10, médianes. Les trois dernières : banc du 02/11, médianes des plans café, carte et nuit, un tirage chacun, même carte, un pod par modèle ; à comparer entre elles, pas avec les quatre premières.
Les versions hébergées. Chez fal (prix lus le 26/10/2026), H3 se loue à la seconde, 0,06 $ en 768p, et sa variante « post-trained » maison, H3 Max, 0,08 $ en 768p une fois finie la promotion annoncée jusqu'au 31 octobre : pas testées ici.
Chez Replicate, la famille compte trois variantes, louées à la seconde de vidéo (prix relevés par Replicate sur ses pages de modèles le 31/10/2026, publiés dans un guide du 03/11/2026) :
- H3 Lite, la moins chère : 0,025 $ en 480p, 0,04 $ en 768p ;
- H3 Highspeed, celle par laquelle Replicate conseille de commencer : 0,06 $, en 768p seulement ;
- H3, la seule des trois en 2K, et réglée en 2K par défaut : 0,08 $ en 768p, 0,13 $ en 2K.
Pour un plan de 10 s en 768p, ça fait 0,40 $, 0,60 $ ou 0,80 $ ; pour 100 plans de 10 s, 40 $, 60 $ ou 80 $. La 2K, absente de la version ouverte, se loue donc là : 1,30 $ le plan de 10 s. Pas testées ici.
Licence
MiniMax H3 est sous la MiniMax H3 Community License Agreement, datée du 2 août 2026. Elle exclut certains territoires et demande une autorisation écrite préalable de MiniMax si tes produits et services commerciaux génèrent « plus de 20 millions de dollars américains (ou l’équivalent dans d’autres devises) de chiffre d’affaires annuel » (clause IV.1).
Télécharger
- Hugging Face, MiniMax : MiniMaxAI/MiniMax-H3, les poids d'origine, sans compte.
- GitHub, MiniMax : MiniMax-AI/MiniMax-H3, même présentation, plus un « skill » d'écriture de prompts.
- ComfyUI : Comfy-Org/MiniMax-H3, « Fichiers de modèle reempaquetés pour ComfyUI », de 16 à 66 Go selon la précision, plus les LoRA turbo ; ComfyUI « 0.30.0+ ». Nous : 0.42.0, empreintes SHA-256 vérifiées, aucun souci.
LoRA compatibles qu'on utilise
Nos quatre LoRA de personnages (Kira, Milky, Riot, White Rose) :
- Origine et réglages : entraînés par nous avec AI Toolkit sur le transformeur « pruned », à partir de 30 à 48 images fixes par personnage ; 1 500 étapes, rang 32, 768 px ; 0,62 Go le fichier. On ne les distribue pas.
- Temps et coût : environ 19 minutes chacun (mesuré sur trois d'entre eux), soit 0,79 $ de calcul (notre calcul) ; 5,25 $ au registre pour les quatre, en comptant aussi l'installation, un entraînement arrêté en route et les huit vidéos de test (notre somme de deux lignes). Une première série a été perdue avec la machine.
- Ce qu'ils changent : même image, même prompt, même graine, avec et sans LoRA, regardés en vignettes puis en pleine taille : mêmes visages, tenues et gestes. Kira ne retrouve pas les anneaux au nez de ses images d'entraînement, absents de l'image de départ. Chez Milky, seule la fin diffère : sans LoRA elle baisse les yeux, avec, elle regarde l'objectif. Le temps de calcul change à peine : 13 s d'écart au plus.
- Notre lecture : en image → vidéo, l'image de départ porte déjà le visage. Un tirage par fille : un indice, pas une mesure. Avec la série perdue, le studio trouvait que le LoRA de Kira tenait mieux visage et tenue : son avis, pas un verdict.
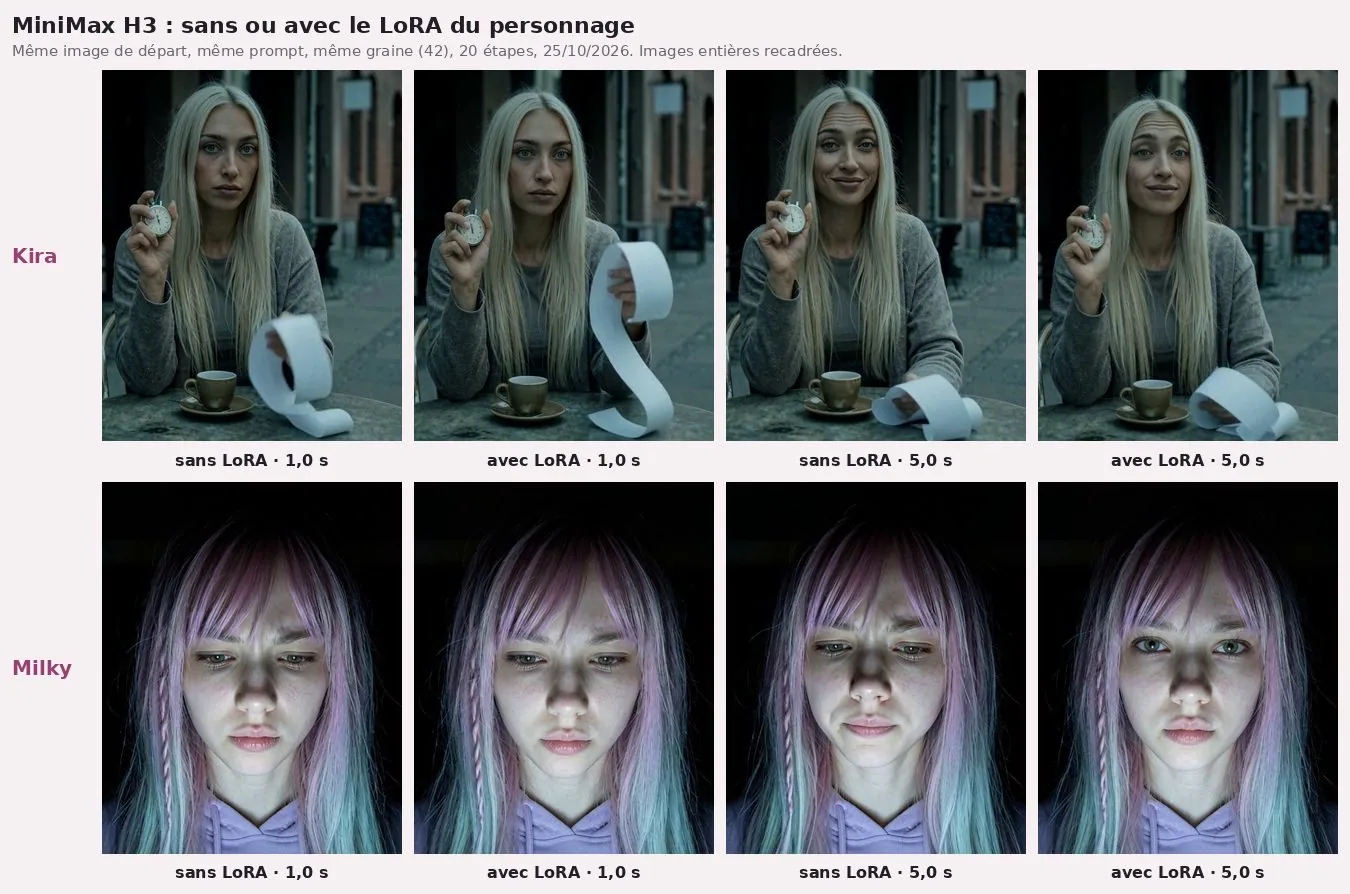
Les LoRA turbo. Comfy-Org en publie trois (le README cite lightx2v parmi ses dépôts d'origine), et le modèle ComfyUI les prévoit, coupés par défaut. On a testé le 4 et le 8 étapes le 02/11, sans LoRA de personnage : temps, prix et images plus haut. Le troisième, non.
Nos images de test
Le mini banc vidéo commun, sans LoRA.
MiniMax H3 sur notre mini banc vidéo : quatre plans, quatre instants
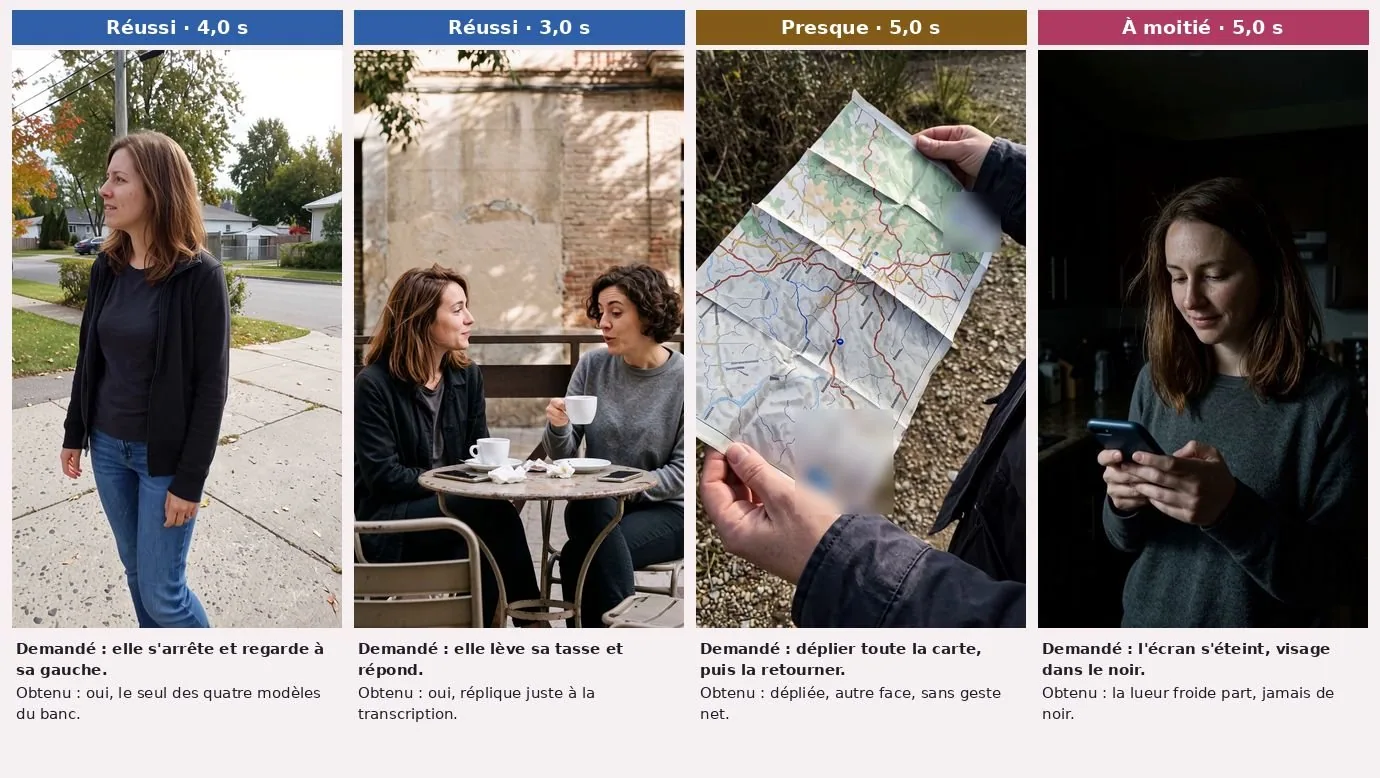
Mini banc vidéo commun du 26/10/2026 : mêmes quatre images de départ pour tous les modèles, prompts en anglais, graine 2210, un tirage, aucun LoRA. MiniMax H3 en mode image → vidéo (fichiers int8 « pruned » pour ComfyUI), modèle officiel ComfyUI, 20 étapes, mode turbo coupé, sans préparation automatique du prompt, sur une RTX PRO 6000 louée 2,49 $/h. Images fixes tirées des vidéos avec ffmpeg à 0,5, 2,0, 3,5 et 5,0 s, sans recadrage ; seuls les cartouches de faux texte de la carte sont floutés. Les vidéos ont du son : ici, on ne voit que l'image.
MiniMax H3 768 × 1344 · 24 i/s · 5,17 s avec son · 20 étapes · environ 195 s et 0,135 $ le plan
En pied
Réussi : elle marche, s'arrête, puis tourne la tête vers sa gauche, comme demandé. Le seul des quatre modèles du banc à regarder du bon côté.
Deux personnages
Réussi : les deux répliques en français sortent mot pour mot à la transcription, et, à l'œil, c'est la bonne bouche qui bouge à chaque fois. Mais l'outil de transcription n'entend qu'une seule voix. La femme bouclée lève sa tasse en répondant, puis boit.
Mains et objet
Presque : la carte se déplie en grand vers 2 s, se replie vers 3 s, puis une autre face apparaît à 3,5 s et finit dépliée à plat. On ne voit pas de vrai geste de retournement. Et malgré « no text », deux cartouches de légende en faux texte.
Nuit
À moitié : beau sourire à la lueur du téléphone, mais la consigne de fin n'est pas tenue. Vers 4,5 s, la lueur froide quitte son visage et une lumière chaude la remplace ; le téléphone reste en main et le visage ne tombe jamais dans le noir.
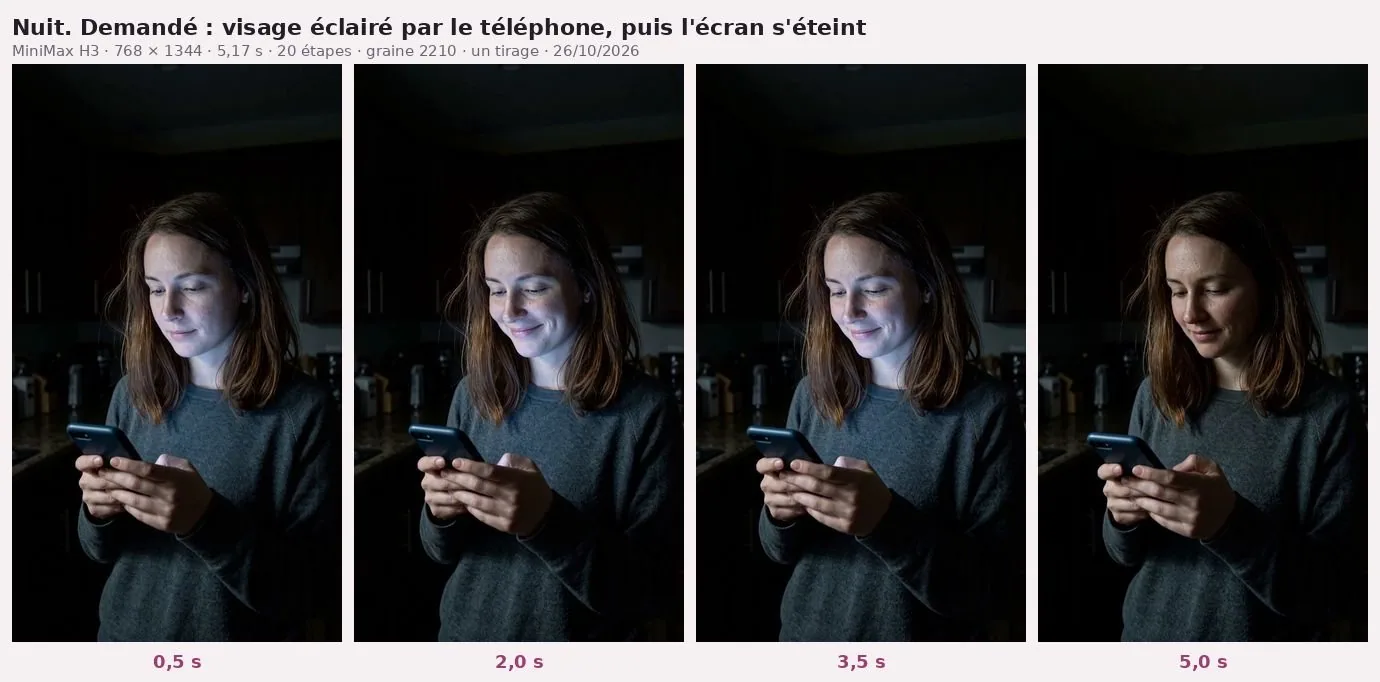
- Ce qui marche : la marche, le regard, la conversation, les visages. Ce qui casse : la consigne de fin et le « no text » ; les cartouches de faux texte sont floutés, aucune marque.
L'avis de Milky
MiniMax H3, c'est l'élève appliqué qui lit la consigne en entier. Tourner la tête à gauche ? Lui, il le fait. Deux répliques en français ? Justes. Mais il met sept fois plus de temps que LTX 2.5 à rendre sa copie au réglage par défaut (195 s contre 28 s), 2,1 fois en turbo 4 étapes (58,3 s contre 27,4 s), et il gribouille une légende là où on avait écrit « no text ».
Mon usage : le plan qui doit être juste plutôt que nombreux, un regard, un geste précis. Pour le volume, je reste sur LTX 2.5. Pour qui : ceux qui louent une grosse carte et ont de la patience. Les 195 secondes, je les ai comptées jusqu'au bout, et pour le bon côté de la tête, je les recompterais.
Ce qu'on ne sait pas encore
- La préparation des consignes de MiniMax et la 2K, par l'API.
- Le mode turbo : plusieurs tirages, et le troisième LoRA turbo. Temps, prix et images : mesurés le 02/11 sur un tirage par plan.
- Plusieurs tirages par plan, pour la diction comme pour l'image.
- Le pic de mémoire, et une carte grand public.
- Nos LoRA en texte → vidéo, sans image de départ, et le mode Ref2VA.
Les mots à retenir
- FL2VA / Ref2VA : les deux points de contrôle ; le premier part du texte, avec ou sans image de début et/ou de fin, le second de références (images, vidéos, sons).
- H3-Context-IR : le module qui réécrit les consignes avant la génération ; absent de la version ouverte.
- « CFG-distilled » : modèle entraîné pour se passer du guidage classique ; pas de prompt négatif.
- Turbo : un LoRA qui fait générer en moins d'étapes (4 ou 8 au lieu de 20).
Tous nos mots expliqués : le glossaire →
Passages sources
Afficher les 30 sources
| Réf. | Citation (langue originale) | URL |
|---|---|---|
| S1↑1↑2↑3↑4↑5↑6+17 | "MiniMax H3 is a general-purpose, omni-modal generative system." ; "can generate video with native stereo audio at resolutions up to 2K and durations of up to 15 seconds" ; "Output duration | 4–15 seconds" ; "The shorter side is set to 768 pixels by default." ; "Output frame rate | 24 FPS" ; "Output audio | 32 kHz stereo" ; "Stable support for 11 languages" ; "French" ; "H3-Context-IR is critical to the quality of the final output, so we strongly recommend incorporating it into your generation pipeline" ; "it is not included in this open-source release. We provide an API" ; "H3-Base: Generates audio and video based on the H3-Context-IR output, producing results at 768p resolution." ; "Due to the complexity of the system, this module is not yet open-sourced." ; "H3-Omni-Transformer is a 33B-parameter dense, single-stream Transformer, with approximately 13B parameters residing in AdaLN-related branches" ; "these parameters do not need to be loaded for inference-only deployment" ; "The H3-Encoder uses the full pretrained weights of Qwen3-VL-32B" ; "The released checkpoints are CFG-distilled Omni Transformer model weights." ; "MiniMax-H3 Base FL2VA" / "MiniMax-H3 Base Ref2VA" ; "--num-gpus 4" | https://huggingface.co/MiniMaxAI/MiniMax-H3 |
| S2↑1↑2 | "MiniMax H3 release date/License date: August 2, 2026." ; IV.1 "You shall obtain a separate, prior written authorization from MiniMax … if your commercial products and services generate more than 20 million US dollars (or equivalent in other currencies) in yearly revenue." ; clauses I.3, I.5 et V.4 (territoire) | https://huggingface.co/MiniMaxAI/MiniMax-H3/raw/main/LICENSE |
| S3↑1↑2↑3↑4 | API : "author":"MiniMaxAI" ; "gated":false ; "createdAt":"2026-07-28T10:45:18.000Z" ; "lastModified":"2026-08-13T01:46:29.000Z" | https://huggingface.co/api/models/MiniMaxAI/MiniMax-H3 |
| S4↑ | "## Prompt Writing Skill" ; "npx skills add https://github.com/MiniMax-AI/MiniMax-H3 --skill h3-prompt-writing" | https://github.com/MiniMax-AI/MiniMax-H3 |
| S5↑1↑2↑3↑4↑5↑6 | "Repackaged model files for ComfyUI." ; "https://huggingface.co/lightx2v/Minimax-h3-Turbo" ; API des fichiers : minimax_h3_fl2va_bf16 66280487368 octets ; minimax_h3_fl2va_pruned_bf16 40225724176 ; minimax_h3_fl2va_pruned_int8_convrot 20970379616 ; minimax_h3_fl2va_pruned_w6a8 15983746636 ; qwen3vl_32b_minimax_h3_nvfp4_awq 15687142551 ; minimax_h3_video_vae_int8_convrot 2811065184 ; minimax_h3_audio_vae_fp32 605254808 ; trois fichiers « loras/minimax_h3_…_turbo_… » | https://huggingface.co/Comfy-Org/MiniMax-H3 |
| S6↑1↑2↑3↑4↑5↑6+6 | "base T2V/I2V/R2V templates need 0.30.0+" ; "Pick the smallest build that fits in VRAM." ; "pruned_int8_convrot | 21 GB | Default in templates" ; "Templates open at Megapixels 0.4" ; "set Megapixels to 0.98 or enter 1344 × 768 on the node" ; "a 5 s request renders 124 frames (5.17 s)" ; "Defaults (Lightning LoRA off): 20 steps. With turbo on: 8 for T2V/I2V" ; "Speech and timbre need 12+ steps" ; "Templates use res_multistep + simple." ; "[Sage Attention] can roughly 2× speed with small quality impact" ; "Use pruned checkpoints when both full and pruned builds exist." | https://docs.comfy.org/tutorials/video/minimax/minimax-h3 |
| S7↑ | (relu en ligne le 26/10/2026 à 02:25 UTC, inchangé) "MiniMax H3 is a frontier video model." ; "Video costs $0.05 per second at 480p, $0.06 per second at 768p, $0.13 per second at 2K and $0.16 per second at 4K." | https://fal.ai/models/minimax/h3/image-to-video |
| S8↑ | (relu en ligne le 26/10/2026 à 02:25 UTC, inchangé) "fal's H3 Max is a post-trained variant of MiniMax H3" ; "The discount ends October 31, after which 480p is $0.05/second, 768p is $0.08/second, and 1080p is $0.16/second." | https://fal.ai/models/minimax/h3-max/image-to-video |
| S9↑1↑2↑3 | (guide de Replicate, « Posted November 3, 2026 », lu le 03/11/2026 vers 17:45 UTC) "MiniMax’s H3 family has three video models on Replicate: minimax/h3-highspeed , minimax/h3-lite , and minimax/h3 ." ; "Our suggestion is to start with Highspeed" ; "H3 Highspeed 768P $0.06 $0.60" ; "H3 Lite 480P, 768P $0.025 at 480P, $0.04 at 768P $0.40" ; "H3 768P, 2K $0.08 at 768P, $0.13 at 2K $0.80" ; "Prices are from the model pages on October 31, 2026. At 2K, a 10-second H3 clip is $1.30." ; "A hundred 10-second clips at 768P come to $40 on Lite, $60 on Highspeed, and $80 on H3." ; "the only one of the three that outputs 2K. It’s also the only one whose resolution defaults to 2K" | https://replicate.com/blog/which-minimax-h3-model |
| R1↑1↑2↑3↑4↑5↑6+12 | Protocole du mini banc vidéo V0 (26/10/2026) : ComfyUI 0.42.0, RTX PRO 6000 Blackwell à 2,49 $/h, « Total VRAM 97252 MB » ; modèle officiel video_minimax_h3_i2v, turbo coupé, aucune préparation du prompt ; 768 × 1344, 124 images, 24 i/s ; 20 étapes, res_multistep, sans CFG ni négatif ; graine 2210, un tirage ; prompts cités, tous finis par « no music, no text, no subtitles, no logos » | — (test maison) |
| R2↑1↑2↑3↑4↑5↑6+3 | Temps et prix des 4 vidéos : médianes 195,0 s, 185,1 s de calcul, 0,1349 $ ; 1re vidéo 203,6 s, 0,1408 $ ; somme 0,5459 $ ; 0,0261 $ la seconde ; 20 étapes à 8,76 s | — (test maison) |
| R3↑1↑2↑3↑4↑5↑6+2 | Même banc : LTX 2.5 27,7 s, 0,0192 $ ; Wan 2.2 A14B rapide 85,9 s, 0,0594 $ ; HunyuanVideo 1.5 1 869,9 s, 1,2933 $ ; rapport MiniMax / LTX ≈ 7,0 ; échelles 100 plans et 12 plans (1 minute), notre calcul | — (test maison) |
| R4↑1↑2↑3↑4↑5 | Quatre fichiers Comfy-Org, 40 073 842 159 octets, SHA-256 vérifiés ; transformeur « 20970 Mo en 57 s » ; pic de mémoire non relevé ; notre calcul 66,28 et 40,23 Go ÷ 2 octets | — (test maison) |
| R5↑1↑2↑3↑4↑5↑6+6 | Relecture des 4 vidéos toutes les 0,5 s, pleine taille : tête vers sa gauche dès ≈ 3 s (v1) ; répliques et tasse (v2) ; carte dépliée, repliée, autre face à 3,5 s, cartouches de faux texte et petites hachures façon étiquettes, illisibles (v3) ; lueur froide jusqu'à 4,0 s, lumière chaude dès 4,5 s, jamais de noir (v4) | — (test maison) |
| R6↑1↑2 | Son : aac 32 000 Hz, 2 canaux ; volumes moyens -43,7 / -20,4 / -42,8 / -50,4 dB ; LTX 2.5 -50,0 / -17,0 / -55,6 / -54,7 dB | — (test maison) |
| R7↑1↑2↑3↑4↑5 | Transcription Scribe v2 (26/10/2026) : « Tu viens avec moi demain ? Oui, mais c'est toi qui conduis » ; 0,78-1,80 s puis 2,96-4,40 s ; une seule voix (speaker_0) ; LTX 2.5 : deux voix | — (test maison) |
| R8↑1↑2↑3↑4↑5 | Autres modèles du banc, pleine taille : LTX, Wan et HunyuanVideo tournent la tête vers leur droite ; sur la carte, seul MiniMax passe à une autre face ; ni LTX ni Wan ne plongent le visage dans le noir (HunyuanVideo n'a tourné que le trottoir) | — (test maison) |
| R9↑1↑2↑3 | Relecture « bureau » : aucune marque ; cartouches de faux texte de la carte floutés ; rien d'écarté dans le banc | — (test maison) |
| R10↑1↑2↑3 | « 214 s* / 197 s », « 0,237 $ / 0,218 $ » sur H100 à 3,99 $/h ; « la plus grande flaque, mais triche » ; crêpe « le plus complet » | https://siliciumrose.fr/articles/sept-modeles-video-open-source.html |
| R11↑1↑2↑3 | Refrain, chanson imposée : 15 s en 1 190 s chargement compris, « environ 0,82 $ » ; « Le rendu le plus détaillé, taches de rousseur comprises » ; « environ 13 fois plus que LTX 2.5 » ; « 19 min 50 de calcul pour 15 s » ; LTX 2.5 « 1 min 32 pour 15 s » ; « environ 0,82 $ » et « environ 0,06 $ » (temps × prix horaire, calcul de l'article) | https://siliciumrose.fr/articles/faire-chanter-un-personnage-4-modeles-libres.html |
| R12↑1↑2↑3↑4 | « 382 et 383 s de calcul pour ces deux plans de 8 s, 0,26 $ chacun » ; « de vrais coups, lisibles » ; « Vainqueur inversé » | https://siliciumrose.fr/articles/modele-libre-peut-il-remplacer-seedance.html |
| R13↑1↑2 | « Cinq LoRA vidéo (quatre pour MiniMax H3, un pour LTX 2.5) … puis perdus » ; avis du studio sur le LoRA de Kira, « Son avis, pas un verdict » | https://siliciumrose.fr/articles/machine-supprimee-lora-perdus.html |
| R14↑1↑2↑3 | AI Toolkit, « arch: minimax_h3 », « partition: fl2va_pruned », rang 32, 1 500 étapes, lr 1e-4, 768 px, images fixes (30 à 48) ; 619 865 168 octets ; registre « LoRA MiniMax Riot v2, Milky, WR (≈ 19 min chacun) » ; registre 1,330 $ (« Kira réentraîné … + Riot v2 arrêté à 13 % ») + 3,920 $ (« … + 8 tests avec / sans LoRA ») | — (test maison) |
| R15↑1↑2↑3↑4↑5 | Tests avec / sans LoRA (25/10/2026), graine 42, regardés en vignettes et en pleine taille ; temps 200/187, 187/188, 157/158, 191/197 s ; observations Kira et Milky | — (test maison) |
| R16↑ | Trois LoRA turbo dans Comfy-Org ; le 4 et le 8 étapes (768p) lancés le 02/11 (R19), le troisième jamais lancé chez nous | — (test maison) |
| R17↑ | Pas testé : Context-IR, 2K, Sage Attention, autres précisions, Ref2VA sur le banc, plusieurs graines, pic de mémoire, carte grand public, versions hébergées | — (test maison) |
| R18↑1↑2↑3↑4 | Banc V0, même pod (une RTX PRO 6000, ComfyUI 0.42.0, « Using pytorch attention ») pour les quatre modèles ; LTX 2.5 : « 22B distillé, int8 », 8 étapes à demi-résolution + 3 après agrandissement ×2, 704 × 1280, 121 images ; MiniMax H3 : 20 étapes, 768 × 1344, 124 images, turbo coupé ; calcul maison des étapes × pixels : 8 × 0,225 + 3 × 0,901 = 4,50 Mpx·étapes contre 20 × 1,032 = 20,64, soit ≈ 4,6 | — (test maison) |
| R19↑1↑2↑3↑4↑5↑6+5 | Banc du 02/11/2026 : MiniMax H3 + LoRA turbo lightx2v 4 et 8 étapes (variante 768p, force 1,0, shift 6 vidéo / 3 audio, euler + simple, sans CFG), 768 × 1344, 124 images, 24 i/s, graine 2210, un tirage, sans LoRA de personnage, RTX PRO 6000 à 2,49 $/h, ComfyUI 0.42.0, un pod par modèle ; 4 étapes : 58,4 / 58,3 / 58,3 s (café, carte, nuit), 0,0404 / 0,0403 / 0,0403 $ ; 8 étapes : 91,0 / 91,2 / 91,5 s, 0,0629 / 0,0631 / 0,0633 $ ; médianes 58,3 s et 0,0403 $, 91,2 s et 0,0631 $ ; LTX 2.5 encodeur officiel : 27,4 s et 0,0190 $ ; 100 plans : 4,03 $, 6,31 $ et 1,90 $ ; premier plan non compté (chargement du modèle) ; rappel du banc du 26/10 : 13,49 $ contre 1,92 $ | — (test maison) |
| R20↑1↑2 | Relecture des vidéos turbo, images extraites avec ffmpeg, pleine taille (dernières images du plan trottoir) : à 4 et à 8 étapes, la femme finit tournée vers sa gauche, de profil, comme demandé ; LTX 2.5, avec l'encodeur officiel comme avec la copie, finit tournée vers sa droite, le visage caché par ses cheveux ; carte : 4 étapes, une autre face pâle ; 8 étapes, carte dépliée en grand puis à demi retournée (relevé du 02/11) | — (test maison) |
| R21↑ | Diction du café mesurée le 02/11/2026 : le son seul de chaque vidéo, remonté sur une image noire pour ne pas lire les sous-titres incrustés, passé à deux transcripteurs automatiques indépendants, Gemini (API, 2 passes) et Whisper small (local, français) ; répliques attendues « Tu viens avec moi demain ? » puis « Oui, mais c'est toi qui conduis. » ; MiniMax H3 turbo 4 et 8 étapes : les deux répliques en entier et justes chez les deux, qui retrouvent aussi la transcription Scribe du 26/10 sur les rendus d'alors ; contrôles : sur un bruit pur de 5 s, Gemini et Whisper inventent chacun une phrase (limite) ; sur deux vidéos coupées à 2,2 s, Gemini ne rend que la première réplique ; non mesuré : synchronisation des lèvres, timbre, qui dit quelle réplique | — (test maison) |
Je ne crois pas une démo. Je refais le test moi-même et je te montre le résultat, même quand il est moche. Et ne me mets pas en colère, tu ne vas pas aimer la suite.