LTX 2.5 : deux centimes le plan, il parle juste (mais froisse les cartes)
« Tu viens avec moi demain ? » C'est la réplique que LTX 2.5 a prononcée dans notre plan du café, et deux transcripteurs automatiques l'ont réécrite mot pour mot. Bon. LTX 2.5, c'est notre moteur vidéo principal : clips, LoRA (des modules d'appoint qui lui apprennent un visage ou un style), scènes de film, tout passe par lui. Je l'ai remis sur notre mini banc, quatre plans de 5 secondes, face à trois autres modèles ouverts. Verdict : le plus rapide et le moins cher de la bande, très bon pour faire parler deux personnes, nul pour déplier une carte routière.
Fiche modèle. Pages officielles relevées le 26/10/2026 ; nos tests du 26/10/2026 sur Runpod, et nos tournages du 22 au 24/10/2026. Fiche mise à jour le 04/11/2026 ; banc refait avec l'encodeur de texte officiel le 02/11/2026.
 MilkyCelle qui teste · Image, vidéo et ComfyUI
Vérifié par une 2e IA
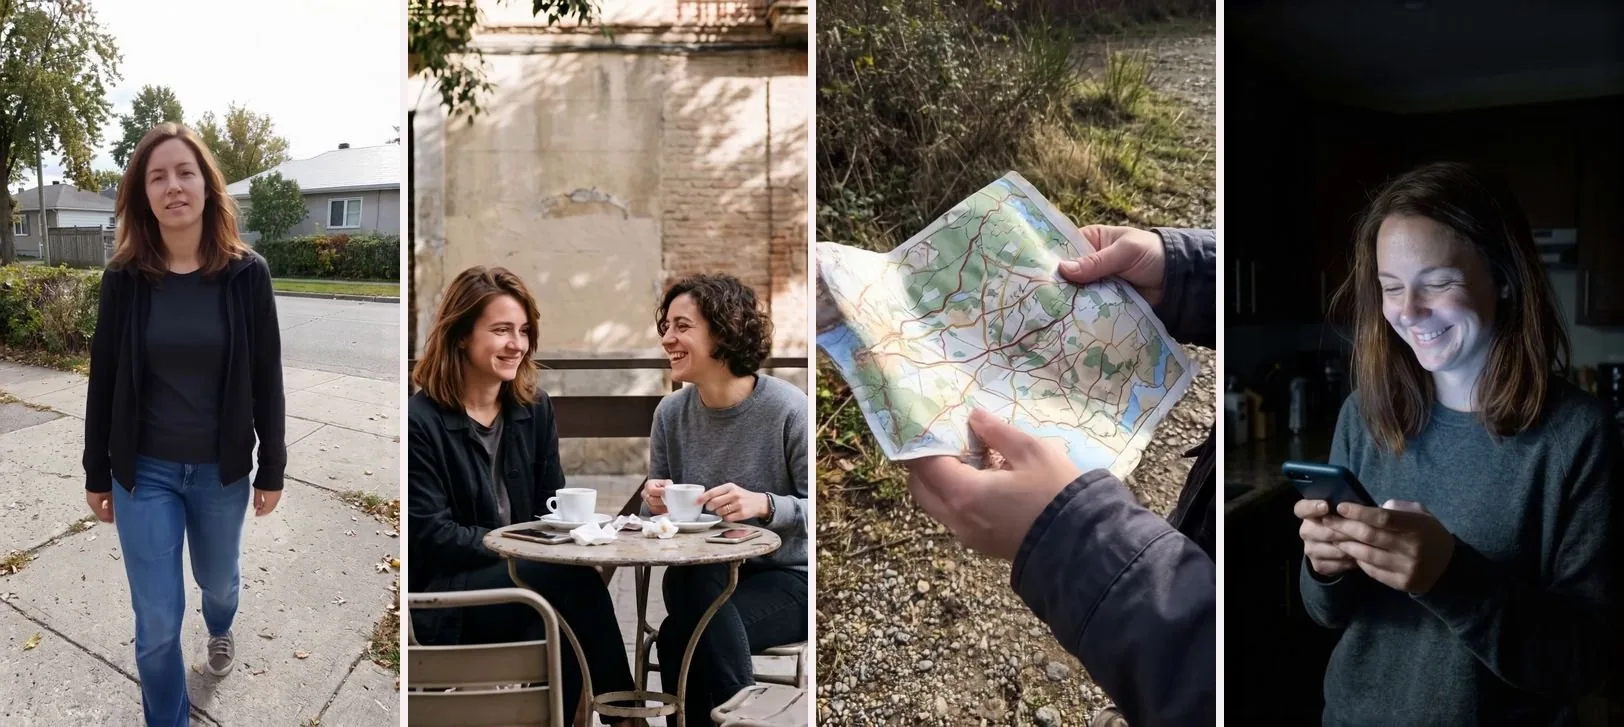
En bref
- Un modèle vidéo à poids ouverts de Lightricks, qui fait l'image et le son ensemble. Sur nos 4 plans : marche et conversation réussies, les deux répliques du café transcrites mot pour mot, y compris avec l'encodeur officiel ; carte ratée, et le noir demandé à la fin du plan de nuit ne vient pas.
- Chez nous, sur une RTX PRO 6000 louée 2,49 $/h : environ 28 s et 0,019 $ pour un plan de 5 s avec son, soit 0,0038 $ la seconde (médianes, notre calcul : durée × prix horaire). Si tu fais 100 plans : 1,92 $ et 46 min de calcul (notre calcul). En 1080p, compte environ 0,12 $ les 15 s.
- Licence LTX-2.x Community : gratuite sous 10 millions de dollars de chiffre d'affaires annuel, payante au-dessus. Nos fichiers viennent d'une copie libre, pas du dépôt officiel : l'un des cinq, l'encodeur de texte, a été remplacé chez Lightricks quatre jours après la copie. Refait le 02/11/2026 avec l'encodeur officiel : mêmes temps et même coût (27,4 s et 0,019 $ le plan), mais des images différentes, avec des sous-titres déformés au café. On te raconte notre erreur dans un prochain article.
| Carte d'identité | |
|---|---|
| Nom, version testée | LTX-2.5, transformeur « distillé » en int8 pour ComfyUI |
| Éditeur | Lightricks : la licence écrit « the Licensor is Lightricks Ltd. » |
| Sortie | Date non écrite dans les pages lues. Dépôt Hugging Face créé le 23/07/2026 ; un envoi intitulé « LTX-2.5 model release » le 11/08/2026, date de la licence |
| Type | Image, texte ou vidéo vers vidéo avec son ; « 22B » dans son nom (« LTX-2.5-22B »), nombre de paramètres non écrit en toutes lettres |
| Ouvert ou fermé | Poids téléchargeables, dépôt « gated » : compte et conditions à accepter |
| Prix officiel | Aucun prix par vidéo : « No per-generation billing » en local |
| Où on l'a fait tourner | Runpod (lien parrainé), ComfyUI 0.42.0, NVIDIA RTX PRO 6000 Blackwell |
Ce qu'il sait faire
La promesse. Lightricks le présente comme « un modèle de monde ouvert (un « world model », qui simule une scène), aux poids ouverts, conçu pour l'exécution locale et le fine-tuning », fait pour générer « vidéo et audio synchronisés, de haute fidélité ». Il annonce aussi plusieurs plans liés en une passe (« Native multishot generation »), un améliorateur de prompt et un distillé « Substantially improved ». Les deux premiers : pas testés.
Nos quatre plans. Mêmes images de départ et mêmes consignes pour tous les modèles du banc, un seul tirage :
| Plan demandé | LTX 2.5 |
|---|---|
| Marcher vers la caméra, s'arrêter, regarder à gauche | Oui, mais elle tourne la tête vers sa droite, et finit le visage caché par ses cheveux (MiniMax H3, lui, regarde bien à gauche) |
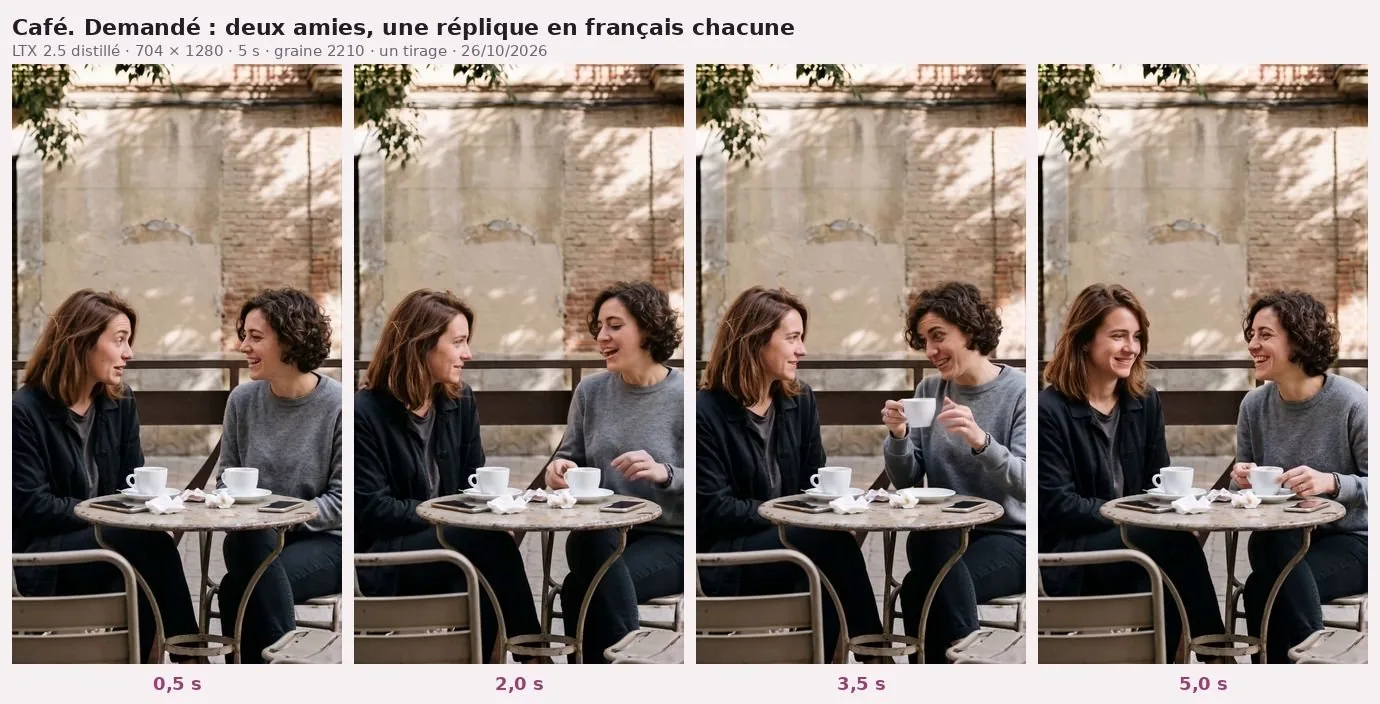
| Deux amies, une réplique en français chacune, une tasse levée | Oui : les deux répliques, mot pour mot à la transcription, deux voix ; tasse levée puis reposée |
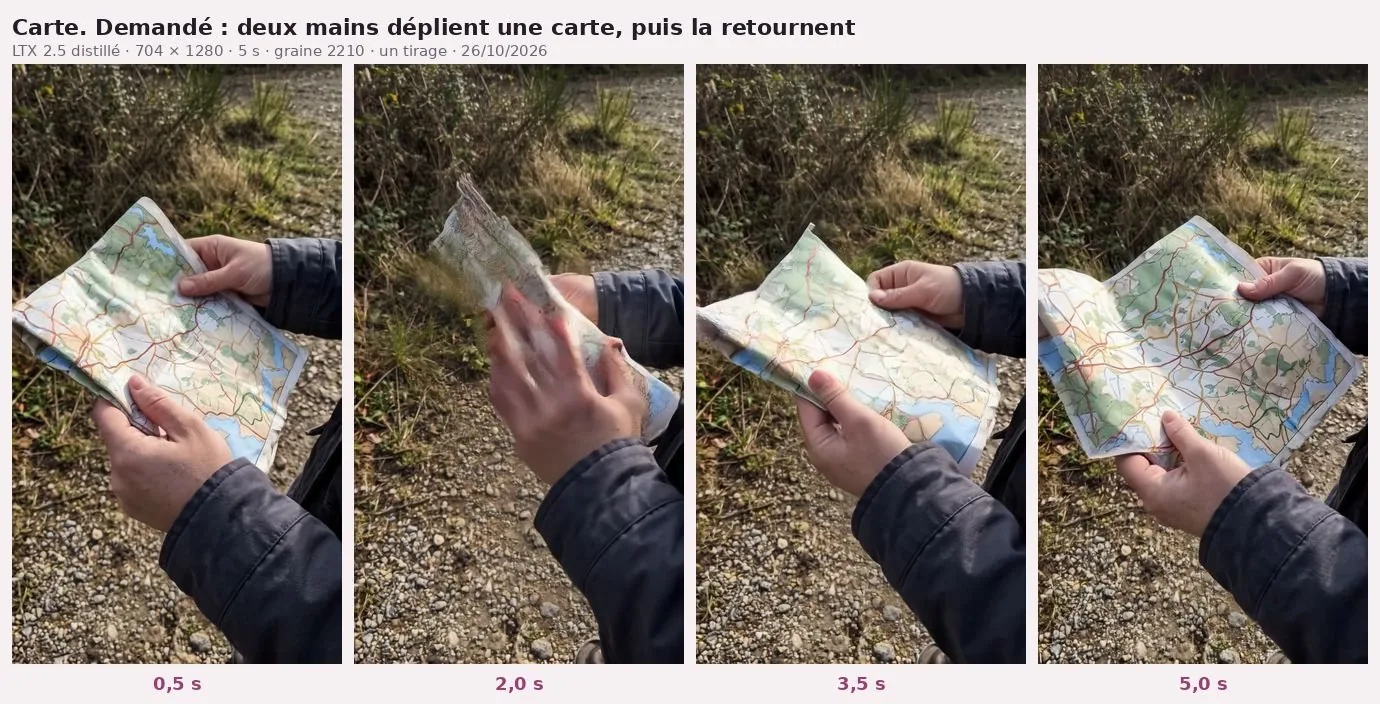
| Déplier toute la carte, puis la retourner | Non : main et papier se mêlent dans un flou vers 2 s, la carte se roule puis revient presque à plat, jamais retournée |
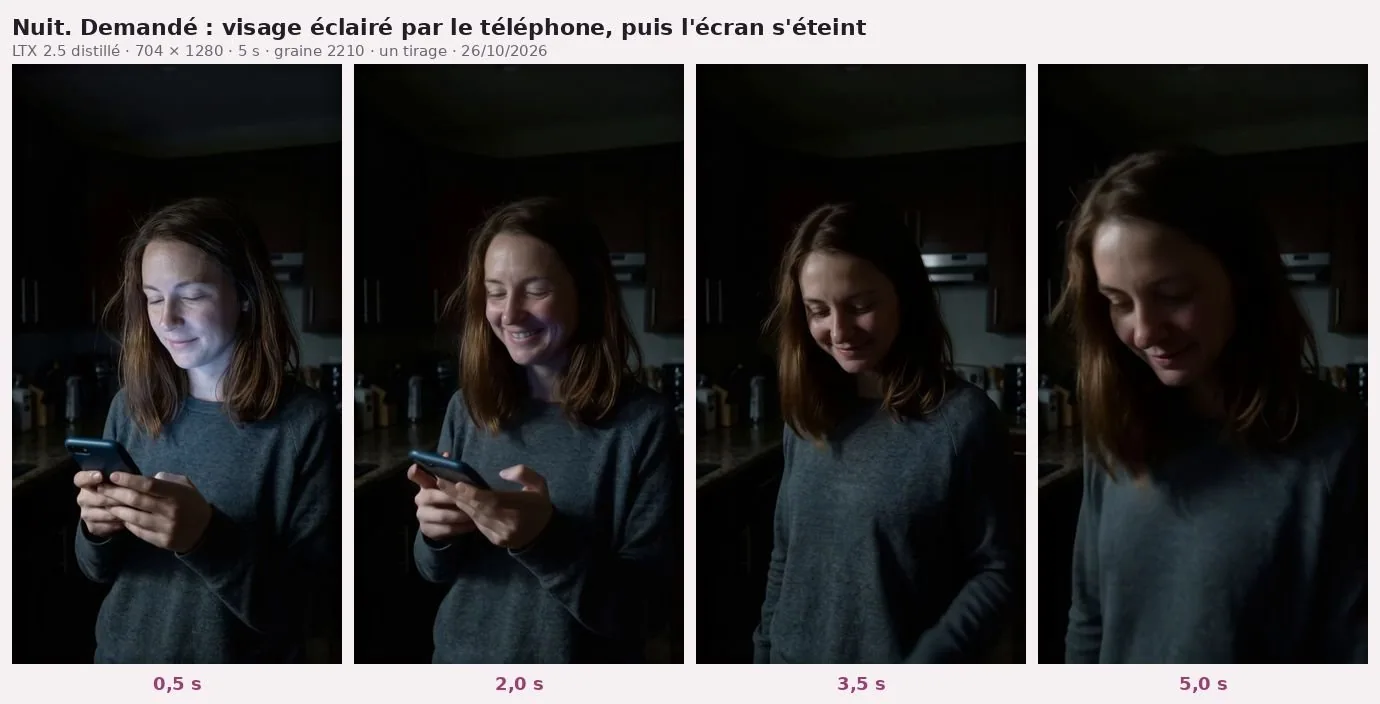
| Visage éclairé par le téléphone, puis l'écran s'éteint et le visage tombe dans le noir | À moitié : la lueur froide quitte son visage vers 2 s, une lumière chaude la remplace ; le téléphone sort du cadre, le noir ne vient jamais |
Relecture image par image (toutes les 0,5 s, pleine taille), 26/10/2026, sur le banc fait avec la copie de l'encodeur ; le même banc refait avec l'encodeur officiel est plus bas.
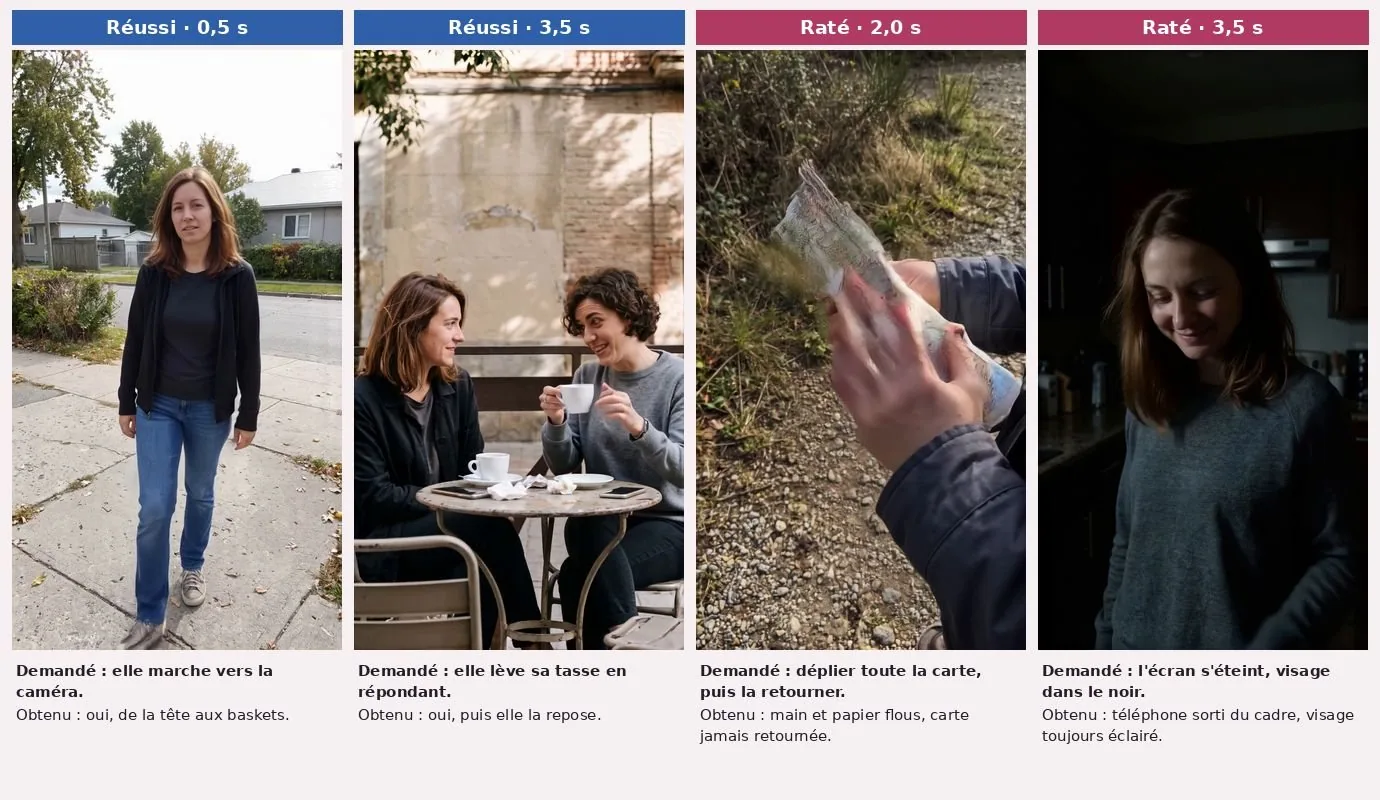
Le son et la diction. Les quatre vidéos ont une piste son. Sur le café, j'ai fait transcrire le son par Scribe v2, l'outil de nos tests de diction : « Tu viens avec moi demain ? » puis « Oui, mais c'est toi qui conduis. », mot pour mot, avec deux voix différentes selon l'outil. MiniMax H3 sur le même plan : les deux répliques justes aussi, mais l'outil n'y entend qu'une voix. Un tirage chacun, et l'outil peut se tromper : un indice, pas une preuve. Coût : 0,016 $ pour les deux. Cette transcription date du banc avec la copie de l'encodeur. Refaite le 02/11 avec l'encodeur officiel, sur le son seul de la vidéo, par deux autres transcripteurs automatiques indépendants (Gemini, Whisper small) : les deux répliques en entier et justes, et ils retrouvent aussi la transcription Scribe de la copie. Ces transcripteurs peuvent inventer des paroles sur un bruit (contrôle fait) ; ici les deux concordent mot pour mot. Mesuré : les mots prononcés. Pas mesuré : la synchronisation des lèvres, le timbre. Sur les trois autres plans, l'ambiance est très discrète : volume moyen de −50 à −56 dB, quand MiniMax H3 tourne autour de −43 dB sur la marche et la carte. Ailleurs, notre studio a noté une réplique « parfaite » dans une scène d'action, mais avec de faux sous-titres incrustés.
Faire chanter. On peut lui imposer une vraie chanson comme piste son : c'est notre clip de 3 min 06. Le visage « reste reconnaissable et vit » ; la synchro des lèvres n'a pas été mesurée.
Le texte dans l'image. Pas demandé sur notre banc. Avec la copie de l'encodeur, aucun n'est apparu ; avec l'encodeur officiel, des sous-titres déformés sont apparus au café, malgré « no subtitles » dans la consigne. Mais en scène d'action, il a inventé un sous-titre « Bouge pas. » puis une ligne sans sens. Depuis, on met « pas de sous-titres » dans la consigne.
Les modules officiels. Lightricks publie des IC-LoRA, qui suivent une vidéo ou une image de référence : un agrandisseur qui « creatively upscales a low-resolution video », un module qui suit une planche de référence (« a reference sheet ») : personnages, objets, lieu. Pas testés chez nous.
Refait avec l'encodeur de texte officiel
Le banc ci-dessus a tourné avec la copie de l'encodeur du 13/08. Le 02/11/2026, je l'ai refait avec l'encodeur officiel de Lightricks (envoi du 17/08) : mêmes images de départ, mêmes consignes, même graine 2210, un tirage par plan, même modèle de carte ; seul l'encodeur change. On te raconte notre erreur dans un prochain article.
| 4 plans de 5 s, Runpod, RTX PRO 6000 à 2,49 $/h | Copie du 13/08 (banc publié) | Encodeur officiel (02/11) |
|---|---|---|
| Médiane café, carte, nuit | 27,7 s, 0,0192 $ | 27,4 s, 0,0190 $ |
| Les 4 plans, premier plan compris | 127,1 s, 0,0879 $ | 126,8 s, 0,0878 $ |
| Si tu fais 100 plans de 5 s | 1,92 $ et 46 min 10 | 1,90 $ et 45 min 40 |
Temps de génération × 2,49 $/h, hors installation, notre calcul ; un tirage chacun.
Le temps et le coût ne bougent pas, mais les images, si. L'écart de structure entre les deux versions (SSIM, 1 = identiques) : 0,90 au trottoir, 0,91 au café, 0,78 à la carte, 0,92 à la nuit. C'est une mesure de différence, pas de qualité. Ce que j'ai lu sur les images extraites avec ffmpeg, toutes les 0,5 s, en pleine taille :
- Trottoir : comme avant. Elle s'arrête, tourne la tête vers sa droite alors que la consigne dit sa gauche, et finit le visage caché par ses cheveux.
- Café : des sous-titres blancs déformés s'incrustent en bas de l'image (« Tu viens avec deamin.. ? », puis « Oui […] gui donduis. »), alors que la consigne dit « no subtitles ». Un seul tirage : je ne sais pas si ça reviendrait. La diction, elle, tient : les deux répliques sortent en entier et justes à la transcription du son seul ; les deux femmes parlent à tour de rôle et la seconde lève sa tasse.
- Carte : comme avant. Froissée, un flou main-papier dès le début et encore vers 2,5 s, presque à plat à la fin, jamais retournée.
- Nuit : comme avant, un peu plus tard. La lueur froide part vers 2,5 s au lieu de 2 s, le téléphone sort du cadre vers 3 s, le noir ne vient jamais.
Donc : le verdict sur la vitesse et le prix tient ; les gestes aussi ; la ligne « répliques mot pour mot » vaut pour le banc fait avec la copie comme pour celui de l'encodeur officiel.
Bon pour… mauvais pour…
- Bon pour les brouillons en série : 0,019 $ et 28 s le plan de 5 s ; sur le même banc, Wan 2.2 rapide prend 3,1 fois plus de temps (86 s, 0,059 $) et MiniMax H3 7 fois plus (195 s, 0,135 $). Pour une minute de film (12 plans), compte 0,23 $ ici, 0,71 $ chez Wan, 1,62 $ chez MiniMax (notre calcul).
- Bon pour deux personnes qui se parlent : le café est notre meilleur plan, visages stables, gestes justes, répliques comprises mot pour mot ; MiniMax H3 tient aussi les deux répliques, sept fois plus lentement (195 s contre 28 s). Avec l'encodeur officiel, des sous-titres déformés s'ajoutent, mais les répliques restent justes à la transcription.
- Bon pour un clip musical : 3 min 06 en 1080p, deux caméras, environ 3,40 $, installation et images comprises.
- Bon pour apprendre un visage : un LoRA en 12 minutes, 3,39 $ avec les images ; quatre personnages pour 9,74 $.
- Mauvais pour les gestes fins : la carte, ratée ; Wan et MiniMax, eux, la déplient en entier sur le même banc, et MiniMax finit sur une autre face, avec un cartouche de légende (à l'œil, en pleine taille).
- Mauvais pour un événement précis : notre consigne « l'écran s'éteint et son visage tombe dans l'obscurité » n'est tenue qu'à moitié : la lueur froide part, le noir ne vient pas. Wan et MiniMax font pareil, plus tard (vers 4 et 4,5 s), téléphone en main.
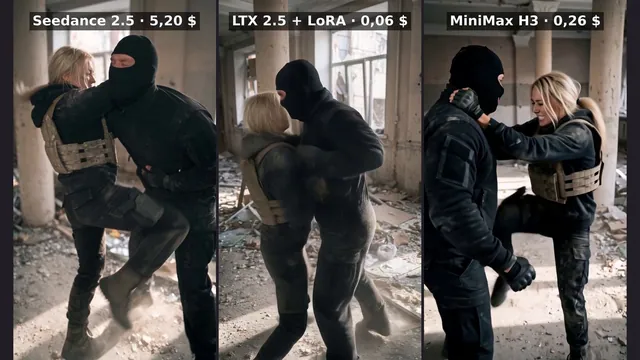
- Mauvais pour la baston : « corps-à-corps confus », à l'œil, et « nettement en dessous » de Seedance selon notre studio.
- Attention aux visages petits : dans notre clip, le visage de White Rose change d'un morceau à l'autre ; notre explication, non testée : il était petit sur l'image de départ.
Réglages conseillés
| Réglage | L'éditeur | Nous (banc du 26/10) |
|---|---|---|
| Modèle | distillé : « Fixed 8-step schedule, CFG=1 » | distillé int8 pour ComfyUI |
| Étapes | « 8 steps stage 1, 4 steps stage 2 » | 8 + 3, modèle officiel ComfyUI (voir l'encadré) |
| Guidance (CFG) | 1 | 1 vidéo, 1 son |
| Taille | largeur et hauteur « divisible by 32 » | 720 × 1280 demandé, 704 × 1280 obtenu |
| Nombre d'images | « num_frames % 8 == 1 » | 121 images, 24 i/s, 5,04 s |
| Décodeur vidéo | « DiffVAE — higher quality, heavier » ou « Conv VAE — faster, lighter » | DiffVAE |
| Améliorateur de prompt | proposé | coupé |
- 720 n'est pas divisible par 32, 704 si : sans doute la raison de nos 704 pixels de large (notre calcul).
- Prompt : le GitHub conseille une description « chronological » des actions, en un paragraphe, « within 200 words ». Nos prompts : un paragraphe en anglais, les répliques en français entre guillemets, « no subtitles » à la fin.
- À refaire avec : l'améliorateur de prompt et le rendu « DFR », dit « production-quality ».
Matériel et coût
| Ce qu'on télécharge (cinq fichiers ComfyUI) | Taille |
|---|---|
| Transformeur distillé int8 | 21,50 Go |
| Encodeur de texte Gemma 4 12B int8 | 15,37 Go |
| Décodeur vidéo + décodeur audio | 1,47 + 0,36 Go |
| Agrandisseur x2 | 1,00 Go |
| Notre installation | 39,71 Go |
Gigaoctets décimaux, notre calcul depuis les octets. Fichiers « ComfyUI only » selon l'éditeur.
La carte. Aucune carte minimale dans les pages lues ; le GitHub propose des options pour les petites mémoires. Nous : une RTX PRO 6000 Blackwell, 97 252 Mo vus par ComfyUI ; pic de mémoire non mesuré.
Le temps. Une fois le modèle chargé : 27,7 s par plan de 5 s, dont 19,7 s de calcul. Premier plan, chargement compris : 44,3 s.
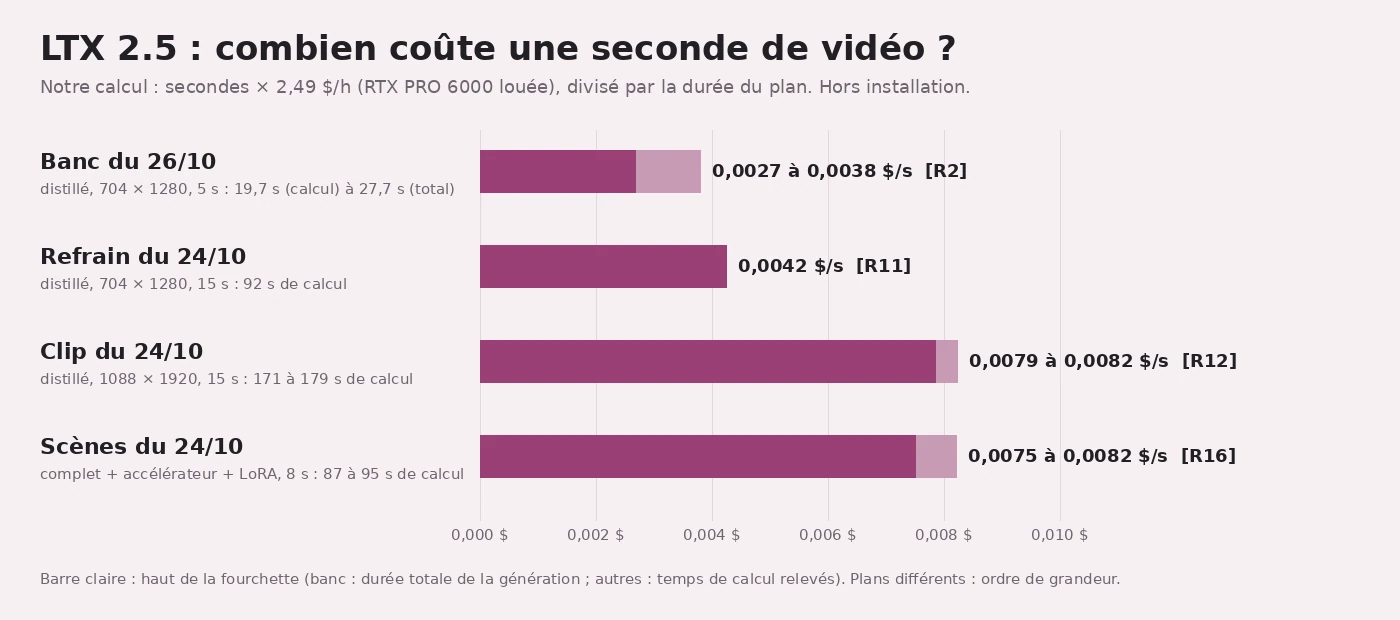
Le prix. Par plan : 0,019 $ les 5 s en 704 × 1280 ; 0,06 $ les 15 s au même format, 0,12 $ en 1088 × 1920 ; 0,06 à 0,07 $ les 8 s en version complète avec un LoRA. Nos 4 vidéos du banc : 0,088 $ en tout. Le 22/10, avec les fichiers officiels : 19 s de calcul, 0,013 $ la vidéo de 5 s.
Face aux autres, même banc, même carte (modèle chargé, médianes) :
| Modèle | Temps par plan | Prix par plan | Format | Son |
|---|---|---|---|---|
| LTX 2.5 distillé | 27,7 s | 0,019 $ | 704 × 1280, 24 i/s | oui |
| Wan 2.2 A14B rapide | 85,9 s | 0,059 $ | 720 × 1280, 16 i/s | non |
| MiniMax H3 | 195,0 s | 0,135 $ | 768 × 1344, 24 i/s | oui |
| HunyuanVideo 1.5 (un plan, chargement compris) | 1 869,9 s | 1,29 $ | 720 × 1280, 24 i/s | non |
Licence
LTX 2.5 est sous la LTX-2.x Community License Agreement, datée du 11 août 2026. Le texte, tel quel :
- 2.1 : une licence « non exclusive, mondiale, non transférable et libre de redevances », mais les entités « avec des revenus annuels d'au moins 10 000 000 $ » doivent prendre une licence payante, sauf usage « exclusivement pour une finalité non commerciale ». Le chiffre d'affaires se compte avec les filiales (1.6).
- 3.5 : un LoRA est un dérivé ; le donner à une entreprise au-dessus du seuil l'oblige à prendre une licence payante, « peu importe qui a créé ce dérivé ».
- 5 : « Le concédant ne revendique aucun droit sur la sortie que vous générez ».
- Annexe A : interdit entre autres de diffuser sans dire que c'est « machine generated », et les « deepfakes » sans consentement.
Usage commercial. Gratuit sous 10 millions de dollars de chiffre d'affaires annuel ; au-dessus, licence payante pour tout usage hors « Non-Commercial Purpose ». La page de téléchargement le résume pareil et ajoute : « Le transfert de fine-tunes peut nécessiter une licence payante ».
Territoire. La licence est « worldwide » ; la section 7 exclut les personnes et pays « soumis à des sanctions globales », sans liste dans le texte.
Télécharger
- Hugging Face, Lightricks : Lightricks/LTX-2.5, tous les fichiers (bf16, int8 pour ComfyUI, nvfp4, LoRA d'accélération). Il faut un compte et accepter les conditions (« Vous devez accepter de partager vos informations Hugging Face »).
- GitHub, Lightricks : Lightricks/LTX-2, le code, les pipelines et l'outil d'entraînement de LoRA.
- ComfyUI : les modèles officiels de workflow « être livré dans ComfyUI ». Nous : ComfyUI 0.42.0.
- Ce qu'on a vécu. Pour le banc et le clip, nos fichiers viennent d'une copie libre, comfyicu/LTX-2.5, sans compte (« gated » : false), qui n'est pas le compte de l'éditeur. On a comparé les empreintes SHA-256 : quatre fichiers sur cinq sont identiques à l'officiel ; pas l'encodeur de texte (2 412 octets d'écart). L'historique public des fichiers donne les dates : la copie a été faite le 13/08/2026, et Lightricks a remplacé ses encodeurs de texte le 17/08/2026 (« Update Gemma 4 12B text encoders: », sans détail lisible) ; notre copie a donc sans doute l'ancien (notre déduction ; refait avec l'officiel le 02/11, voir plus haut). La dernière modification du dépôt officiel, le 11/10/2026, ne touche que la fiche (« Update documentation links »). Ni la fiche ni le journal des versions du GitHub ne disent ce qui a changé.
LoRA compatibles qu'on utilise
Aucun LoRA d'un tiers : les visages de la maison.
- Origine : entraînés par nous avec l'outil officiel, sur la version complète (« Full / trainable DiT »).
- Licence : un LoRA est un dérivé au sens de la licence (voir plus haut). On ne distribue pas les nôtres.
- Ce qu'on a mesuré : 1 500 étapes, environ 12 minutes par LoRA ; 3,39 $ pour White Rose, 9,74 $ pour quatre. À l'œil, il rend un peu mieux sur la version complète avec le petit LoRA d'accélération officiel (« Distilled LoRA ») que sur la distillée. Détail : White Rose, Kira.
- LoRA et IC-LoRA officiels : 15 dépôts « LTX-2.5-22b » chez Lightricks dans la liste de l'API, au 26/10. Pas encore testés.
Nos images de test
Le mini banc vidéo commun : quatre plans de 5 s, mêmes images de départ pour tous, graine 2210, un tirage, sans LoRA.
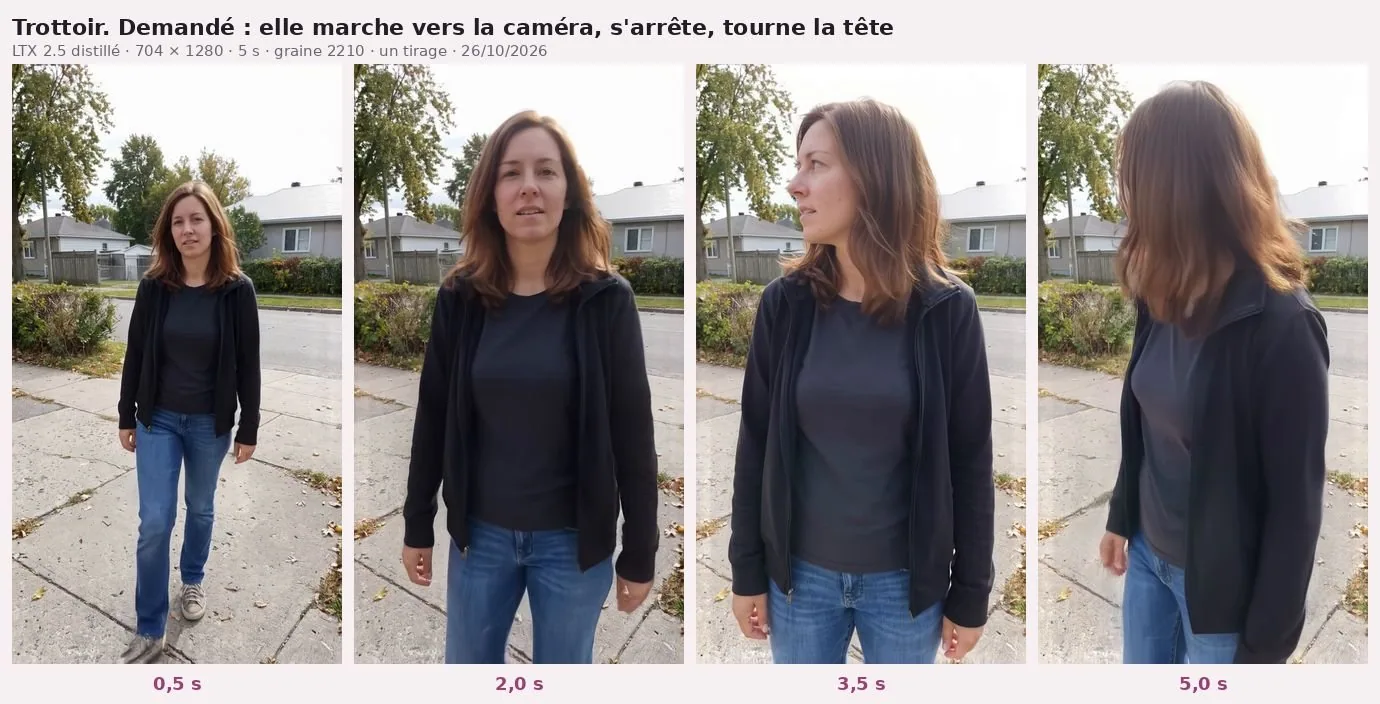
LTX 2.5 sur notre mini banc vidéo : quatre plans, quatre instants
Mini banc vidéo commun du 26/10/2026 : mêmes quatre images de départ pour tous les modèles, prompts en anglais, graine 2210, un tirage, aucun LoRA. LTX 2.5 distillé (fichiers int8 pour ComfyUI), modèle officiel ComfyUI, amélioration automatique du prompt coupée, sur une RTX PRO 6000 louée 2,49 $/h. Images fixes tirées des vidéos avec ffmpeg à 0,5, 2,0, 3,5 et 5,0 s, sans recadrage ni retouche. Les vidéos ont du son : ici, on ne voit que l'image.
LTX 2.5 distillé 704 × 1280 · 24 i/s · 5 s avec son · 8 + 3 étapes · environ 28 s et 0,019 $ le plan
En pied
Réussi en grande partie : elle marche, s'arrête, tourne la tête. Mais vers sa droite (le prompt disait sa gauche), et à la fin ses cheveux lui cachent le visage.
Deux personnages
Le meilleur plan : les deux parlent à tour de rôle, la femme bouclée lève sa tasse puis la repose, visages stables. Les deux répliques en français sortent mot pour mot à la transcription.
Mains et objet
Raté : vers 2 s, une main et le papier se mêlent dans un flou ; la carte se roule, se froisse, puis revient presque à plat, sans jamais être retournée. Les doigts redeviennent corrects ensuite.
Nuit
Belle lumière de téléphone et vrai sourire, mais la consigne n'est tenue qu'à moitié : la lueur froide quitte son visage vers 2 s, une lumière chaude la remplace, elle baisse le téléphone hors du cadre, et le visage ne tombe jamais dans le noir.
- Ce qui marche : la marche, les visages, la conversation, la lumière de nuit. Ce qui casse : les mains qui manipulent, et la consigne de fin.
- Tenues et décors : tout est montrable tel quel, rien de recadré, aucune marque ni texte lisible.
- Ailleurs sur le site : sept modèles vidéo, le refrain, le clip à 3,40 $, sa version 2, le duel contre Seedance.
L'avis de Milky
LTX 2.5, c'est le stagiaire qui rend tout le premier, pour deux centimes, et qui bavarde à la machine à café, sans écorcher un mot (avec l'encodeur officiel, c'est aux sous-titres qu'il invente qu'il écorche les mots). Donne-lui une carte routière : origami flou. Demande-lui de plonger la pièce dans le noir : il range le téléphone et laisse la lumière.
Mon usage : tout ce qui se tourne en volume. Brouillons, clips, scènes de dialogue, personnages avec LoRA. Pour une bagarre ou un geste précis, je prends un autre modèle, ou je relance. Pour qui : les petits studios et les curieux qui louent une carte à l'heure. Et pour la chute, je lui laisse la réplique : « Oui, mais c'est toi qui conduis. »
Ce qu'on ne sait pas encore
- Si la diction tient sur plusieurs tirages et sur des répliques plus longues : ici, deux phrases courtes, un tirage.
- Ce qui a changé dans l'encodeur : aucune page lue ne le détaille. Si les sous-titres du café reviennent sur plusieurs tirages (la diction, elle, tient avec l'encodeur officiel sur ce tirage).
- Ce que compte le « 4 steps stage 2 » du GitHub, l'améliorateur de prompt, le rendu « DFR », la 1080p et la 4K sur le banc.
- Plusieurs graines par plan : ici, un seul tirage.
- Le pic de mémoire, et une carte grand public.
- Les IC-LoRA officiels et les plans multiples en une passe.
Les mots à retenir
- Modèle distillé : version entraînée pour aller vite en peu d'étapes ; chez LTX 2.5, « Fixed 8-step schedule ».
- Version complète (« dev ») : le modèle entier, celui qu'on peut entraîner.
- IC-LoRA : un LoRA « en contexte », qui lit une vidéo de référence en plus du prompt.
- int8 : poids rangés sur 8 bits, deux fois plus légers que le bf16 (21,50 Go contre 42,02 Go pour le transformeur) ; ici, réservés à ComfyUI.
- Dépôt « gated » : téléchargement après connexion et acceptation des conditions.
Tous nos mots expliqués : le glossaire →
Passages sources
Afficher les 34 sources
| Réf. | Citation (langue originale) | URL |
|---|---|---|
| S1↑1↑2↑3↑4↑5↑6+19 | "LTX-2.5 is an open world model with open weights, built for local execution and fine-tuning. Its established use is generating synchronized, high-fidelity video and audio from text, image, and video inputs" ; "No per-generation billing" ; "Native multishot generation" ; "Prompt enhancer" ; "Duration predictor (optional)" ; "Substantially improved distilled model" ; "Distilled DiT (bf16). Fixed 8-step schedule, CFG=1." ; "Full / trainable DiT (bf16)." ; "Distilled DiT (Comfy int8 + convrot). ComfyUI only — not for ltx-pipelines / PyTorch." ; "DiffVAE — higher quality, heavier" ; "Conv VAE — faster, lighter" ; "Distilled LoRA (dev-transformer workflows)" ; "Frame count: num_frames % 8 == 1" ; "Width and height divisible by 32" ; "Official LTX-2.5 workflow templates ship in ComfyUI." ; "Based on our testing, the large majority of LoRAs and IC-LoRAs trained on LTX-2.3 run on LTX-2.5 without changes. A small number of exceptions exist" ; "Prompt following is heavily influenced by prompting style." ; "Commercial and production use at no cost under the LTX-2.x Community License. Transfer of fine-tunes may require a paid license" ; "You need to agree to share your Hugging Face information to access this model" | https://huggingface.co/Lightricks/LTX-2.5 |
| S2↑1↑2↑3↑4↑5↑6+2 | API : "gated":"auto" ; "lastModified":"2026-10-11T07:00:53.000Z" ; "createdAt":"2026-07-23T07:55:24.000Z" ; "license_link":"https://github.com/Lightricks/LTX-2/blob/main/LICENSE-2_x" ; liste des fichiers avec octets et SHA-256 | https://huggingface.co/api/models/Lightricks/LTX-2.5 |
| S3↑1↑2↑3↑4↑5↑6+1 | "Fastest inference with only 8 predefined sigmas (8 steps stage 1, 4 steps stage 2)." ; "DFR (Diffusion Fidelity Rendering) is the production-quality text/image-to-video path." ; "In cases of GPU memory constraints, consider --quantization fp8-cast --offload {cpu, disk}." ; "focus on detailed, chronological descriptions of actions and scenes" ; "Keep within 200 words." ; "Files are not interchangeable between the two models, and a LoRA only works with the model it was trained on." (section « Legacy: LTX-2.3 ») ; "ltx-trainer" | https://github.com/Lightricks/LTX-2 |
| S4↑1↑2↑3↑4↑5↑6+7 | "License date: August 11, 2026" ; 1.9 "This license is applicable to all LTX-2.5 versions released since August 11, 2026" ; 1.5 "Derivatives of LTX-2.x include: (i) any fine-tuned or adapted weights" ; 1.6 "all subsidiaries, affiliates, and companies under common Control shall be considered collectively" ; 1.8 "the Licensor is Lightricks Ltd." ; 2.1 "you are granted a non-exclusive, worldwide, non-transferable and royalty-free limited license" ; "Entities with annual revenues of at least $10,000,000 (the "Commercial Entities") are required to obtain a paid license for any use (excluding use solely for a Non-Commercial Purpose as set forth in Section 2.2)" ; 3.5 "(including any fine-tuned weights, LoRA adapters, or similar adaptations)" ; "it must obtain a paid license from Licensor prior to any use of any Derivative of LTX-2.x, regardless of who created such Derivative" ; 5 "Licensor claims no rights in the Output you generate using LTX-2.x." ; 7 "any country or territory subject to comprehensive sanctions" ; Attachment A 5) "without expressly and intelligibly disclaiming that the information and/or content is machine generated" ; 7) "To impersonate or attempt to impersonate (e.g. deepfakes) others without their consent" | https://github.com/Lightricks/LTX-2/blob/main/LICENSE-2_x |
| S5↑1↑2↑3 | "It creatively upscales a low-resolution video" ; "Base Model: LTX-2.5-22B Video" ; "The model is an in-context LoRA: instead of taking only a text prompt, it also consumes a reference video in context" | https://huggingface.co/Lightricks/LTX-2.5-22b-IC-LoRA-Pixel-Spatial-Upscaler |
| S6↑1↑2 | "conditions video generation on a reference sheet — a single composite image inventorying the characters, props, and location of a scene" ; API : 15 dépôts « Lightricks/LTX-2.5-22b-… » (LoRA et IC-LoRA) | https://huggingface.co/api/models?author=Lightricks&search=LTX-2.5 |
| S7↑1↑2↑3 | Copie comfyicu : "gated":false ; "lastModified":"2026-08-13T07:22:00.000Z" ; "license_link: https://github.com/Lightricks/LTX-2/blob/main/LICENSE.md" ; liste des fichiers avec octets et SHA-256 | https://huggingface.co/comfyicu/LTX-2.5 |
| S8↑1↑2↑3 | API publique des fichiers (sans compte), dernier envoi par fichier : "LTX-2.5 model release" (2026-08-11T18:52:50) ; "Update Gemma 4 12B text encoders:" (2026-08-17T13:46:36, deux encodeurs de texte) ; "Restore keyframes support on the distilled NVFP4 transformer." (2026-08-16) ; "Update documentation links" (2026-10-11T07:00:53, README seul) | https://huggingface.co/api/models/Lightricks/LTX-2.5/tree/main?recursive=true&expand=true |
| S9↑1↑2 | Modèle ComfyUI officiel video_ltx2_5_i2v : ManualSigmas "1.0, 0.99375, 0.9875, 0.98125, 0.975, 0.909375, 0.725, 0.421875, 0.0" puis "0.85, 0.7250, 0.4219, 0.0" | https://github.com/Comfy-Org/workflow_templates/blob/main/templates/video_ltx2_5_i2v.json |
| S10↑ | Journal des versions du GitHub (1.2.0 du 2026-08-11 « Support for LTX 2.5 » à 1.5.0 du 2026-10-18) : aucune entrée sur le remplacement des encodeurs de texte | https://github.com/Lightricks/LTX-2/blob/main/CHANGELOG.md |
| R1↑1↑2↑3↑4↑5↑6+10 | Protocole du mini banc vidéo V0 (26/10/2026) : ComfyUI 0.42.0, RTX PRO 6000 Blackwell à 2,49 $/h, « Total VRAM 97252 MB » ; modèle officiel video_ltx2_5_i2v, amélioration de prompt coupée ; 720 × 1280 demandé, 704 × 1280 obtenu, 121 images, 24 i/s ; 8 + 3 étapes, CFG 1/1 ; graine 2210, un tirage ; prompts cités | — (test maison) |
| R2↑1↑2↑3↑4↑5↑6+2 | Temps et prix des 4 vidéos : médianes 27,7 s, 19,7 s de calcul, 0,0192 $ ; 1re vidéo 44,3 s, 0,0306 $ ; somme 0,0879 $ ; 0,0038 $ la seconde | — (test maison) |
| R3↑1↑2↑3↑4 | Même banc : Wan 2.2 A14B rapide 85,9 s, 0,0594 $ ; MiniMax H3 195,0 s, 0,1349 $ ; HunyuanVideo 1.5 1 869,9 s, 1,2933 $ ; rapports 3,1 et 7,0 ; échelles 100 plans et 12 plans (1 minute), notre calcul | — (test maison) |
| R4↑1↑2↑3 | Cinq fichiers, 39 709 874 648 octets ; SHA-256 vérifiés ; fichiers prêts 37 s après ComfyUI ; pic de mémoire non relevé | — (test maison) |
| R5↑1↑2 | Comparaison avec le dépôt officiel : 4 fichiers identiques ; encodeur int8 15 372 971 786 octets (copie) contre 15 372 969 374 (officiel) | — (test maison) |
| R6↑1↑2↑3↑4↑5↑6+2 | Relecture des 4 vidéos toutes les 0,5 s (images n° 0, 12, 24…), pleine taille : tête tournée vers sa droite et visage caché (v1) ; tour de parole et tasse (v2) ; flou main-papier vers 2 s, carte roulée puis presque à plat, jamais retournée (v3) ; lueur froide partie vers 2 s, lumière chaude ensuite, téléphone hors cadre à 3,5 s, jamais de noir (v4) ; aucun texte | — (test maison) |
| R7↑1↑2 | Son : aac 48 kHz ; volumes moyens -50,0 / -17,0 / -55,6 / -54,7 dB ; MiniMax -43,7 / -20,4 / -42,8 / -50,4 dB | — (test maison) |
| R8↑1↑2 | Autres modèles, revus en pleine taille toutes les 0,5 s : Wan et MiniMax déplient la carte, MiniMax finit sur une autre face avec un cartouche de légende ; v4 : téléphone en main jusqu'au bout, lueur froide partie vers 4 s (Wan) et 4,5 s (MiniMax), visage jamais dans le noir ; v1 : MiniMax tourne la tête vers sa gauche, Wan vers sa droite | — (test maison) |
| R9↑ | Relecture « bureau » : aucune image écartée ni recadrée, aucune marque ni texte lisible | — (test maison) |
| R10↑ | « 37 s* / 19 s », « 0,026 $ / 0,013 $ », fichiers du dépôt officiel, 22/10/2026 | https://siliciumrose.fr/articles/sept-modeles-video-open-source.html |
| R11↑1↑2↑3 | « 1 min 32 de calcul pour 15 s de vidéo, environ 0,06 $ » ; « Le visage reste reconnaissable et vit » ; synchro des lèvres « pas mesurée » | https://siliciumrose.fr/articles/faire-chanter-un-personnage-4-modeles-libres.html |
| R12↑1↑2↑3↑4↑5↑6+2 | Clip 3 min 06, 1080p, « environ 3,40 $ » ; morceaux de 15 s « de 171 à 179 s » de calcul ; visage qui change d'un morceau à l'autre (explication du studio, non testée : visage petit sur l'image de départ) ; action « nettement en dessous » de Seedance ; « la réplique est parfaite, avec de faux sous-titres » ; « Bouge pas. » | https://siliciumrose.fr/articles/clip-3-minutes-3-dollars-40.html |
| R13↑1↑2↑3↑4↑5 | LoRA : « 12 minutes d'entraînement, 3,39 $ en tout » ; version complète, outil officiel ; « une différence, mais assez légère » | https://siliciumrose.fr/articles/apprendre-son-visage-au-modele-lora-video.html |
| R14↑ | Clip v2 : consigne « pas de sous-titres » ; version complète + accélérateur ; environ 4,98 $ | https://siliciumrose.fr/articles/clip-white-rose-version-2-lora.html |
| R15↑1↑2↑3 | « 1 500 étapes, environ 12 minutes » ; « 9,74 $ pour quatre personnages » | https://siliciumrose.fr/articles/4-lora-video-en-une-soiree.html |
| R16↑1↑2↑3↑4 | « 87 s de calcul pour le plan de la baston (0,06 $), 95 s pour le zombie (0,07 $) » ; « corps-à-corps confus » | https://siliciumrose.fr/articles/modele-libre-peut-il-remplacer-seedance.html |
| R17↑1↑2↑3↑4↑5 | Kit du studio : copie comfyicu ; « 1088x1920 : environ 3 min de calcul pour 15 s (≈ 0,12 $) » ; chanson imposée ; négative « subtitles, captions, text on screen » | — (relevé interne) |
| R18↑1↑2↑3↑4 | Pas testé : bf16, nvfp4, Conv VAE, tête de durée, améliorateur de prompt, DFR, IC-LoRA, multishot, plusieurs graines, pic de mémoire, carte grand public | — (test maison) |
| R20↑1↑2↑3↑4↑5↑6 | Transcription Scribe v2 (fal, « language_code » fra, diarisation), 26/10/2026, 0,016 $ : LTX 2.5 « Tu viens avec moi demain ? Oui, mais c'est toi qui conduis. », speaker_0 de 0,34 à 1,06 s, speaker_1 de 2,42 à 3,62 s ; MiniMax H3 « Tu viens avec moi demain ? Oui, mais c'est toi qui conduis », une seule voix (speaker_0) | — (test maison) |
| R21↑ | github.com/Lightricks/LTX-2/blob/main/LICENSE.md : HTTP 404 le 26/10/2026 ; fichiers à la racine du dépôt : LICENSE, LICENSE-2, LICENSE-2_x (API GitHub) | — (relevé) |
| R22↑1↑2↑3 | Banc refait le 02/11/2026 avec l'encodeur de texte officiel Lightricks (envoi du 17/08/2026, 15 372 969 374 octets, sha256 6ce688a0aa98…), les quatre autres fichiers identiques ; mêmes images, consignes, réglages (8 + 3 étapes, 704 × 1280, 121 images, graine 2210), RTX PRO 6000 à 2,49 $/h, ComfyUI 0.42.0 : 44,7 / 27,0 / 27,7 / 27,4 s et 0,0309 / 0,0187 / 0,0192 / 0,0190 $ ; somme 126,8 s et 0,0878 $ ; copie : 44,3 / 27,7 / 27,8 / 27,3 s, somme 127,1 s et 0,0879 $ ; médianes café, carte, nuit : 27,4 s et 0,0190 $ contre 27,7 s et 0,0192 $ ; 100 plans : 1,90 $ et 2 740 s contre 1,92 $ et 2 770 s | — (test maison) |
| R23↑1↑2↑3↑4 | Relecture des 4 vidéos à l'encodeur officiel, images extraites avec ffmpeg toutes les 0,5 s, pleine taille, comparées à celles de la copie : trottoir, tête vers sa droite, visage caché à la fin ; café, sous-titres blancs « Tu viens avec deamin.. ? » (0,5 et 1,0 s) puis « Oui, , gui donduis. » (2,5 à 3,5 s), absents de la copie ; carte, froissée, jamais retournée ; nuit, lueur froide partie vers 2,5 s, téléphone hors cadre vers 3,0 s, jamais de noir | — (test maison) |
| R24↑ | SSIM entre la version copie et la version officielle, par plan : 0,8977 / 0,9059 / 0,7798 / 0,9205 (PSNR 24,16 / 24,97 / 22,45 / 27,61 dB) | — (test maison) |
| R25↑1↑2↑3↑4↑5 | Diction du café mesurée le 02/11/2026 : le son seul de chaque vidéo, remonté sur une image noire pour ne pas lire les sous-titres incrustés, passé à deux transcripteurs automatiques indépendants, Gemini (API, 2 passes) et Whisper small (local, français) ; répliques attendues « Tu viens avec moi demain ? » puis « Oui, mais c'est toi qui conduis. » ; LTX 2.5 (encodeur officiel) : les deux répliques en entier et justes chez les deux, qui retrouvent aussi la transcription Scribe du 26/10 sur les rendus d'alors ; contrôles : sur un bruit pur de 5 s, Gemini et Whisper inventent chacun une phrase (limite) ; sur deux vidéos coupées à 2,2 s, Gemini ne rend que la première réplique ; non mesuré : synchronisation des lèvres, timbre, qui dit quelle réplique | — (test maison) |
Je ne crois pas une démo. Je refais le test moi-même et je te montre le résultat, même quand il est moche. Et ne me mets pas en colère, tu ne vas pas aimer la suite.