Qwen-Image, toutes les variantes : huit modèles d'images à télécharger, deux licences et un piège
Tout le monde a un tiroir où s'entassent les câbles dont personne ne connaît plus la prise. Attends. Voilà : la famille Qwen-Image, c'est ce tiroir, version modèles d'images. Un original, une mise à jour, trois modèles de retouche, un découpeur de calques, une 2.0 qu'on ne peut pas télécharger, une 2.1 qui change de licence, et trois cousins qui ne dessinent pas. Bon. J'ai tout sorti sur la table, passé trois d'entre eux au banc, et voici qui fait quoi.
Comparatif, page de famille du catalogue. Pages officielles relevées le 26/10/2026 ; nos tests du 25/10/2026 sur Runpod, une NVIDIA L40S. Page mise à jour à chaque nouveau test de la famille.
 MilkyCelle qui teste · Image, vidéo et ComfyUI
Vérifié par une 2e IA
En bref
- L'équipe Qwen publie huit modèles d'images à poids téléchargeables : Qwen-Image et sa mise à jour 2512 pour générer, Edit, Edit 2509 et Edit 2511 pour retoucher, Layered pour découper en calques, puis la 2.1 et la 2.1 Turbo, qui génèrent et retouchent dans un seul modèle. Qwen-Image 2.0, annoncée en février 2026, n'a pas de poids chez l'éditeur au 26/10/2026.
- Les six premiers sont sous Apache 2.0, usage commercial compris ; la 2.1 et la 2.1 Turbo sont sous une licence de recherche, « À DES FINS NON COMMERCIALES UNIQUEMENT ».
- Chez nous, même carte et réglages de l'éditeur : 98,3 s par image pour l'original, 98,8 s pour la 2512, environ 0,030 $ chacune, et 106,1 s pour une retouche avec Edit 2511. Si tu génères 1 000 images, une après l'autre : 29,80 $ et 27 h 18 avec l'original, 29,90 $ et 27 h 27 avec la 2512. À ce prix, sur nos photos (un tirage chacune), la 2512 rend une peau moins lisse au portrait et réussit le plan en pied que l'original rate.
Quelle variante pour quoi
| Variante | Sortie, selon l'éditeur | Ce qu'elle fait | Licence | Chez nous |
|---|---|---|---|---|
| Qwen-Image | 04/08/2025 | Texte vers image, 20 milliards de paramètres | Apache 2.0 | Testée en fp8 : 98,3 s, 0,030 $ |
| Qwen-Image-Edit | 18/08/2025 | Retouche d'une image, texte compris | Apache 2.0 | Pas testée |
| Qwen-Image-Edit-2509 | 22/09/2025 | Retouche à partir de 1 à 3 images, ControlNet intégré | Apache 2.0 | Pas testée |
| Qwen-Image-Layered | 19/12/2025 | Découpe une image en calques transparents | Apache 2.0 | Pas testée |
| Qwen-Image-Edit-2511 | 23/12/2025 | Retouche, moins de dérive de l'image | Apache 2.0 | Testée en fp8mixed : 106,1 s, 0,032 $ |
| Qwen-Image-2512 | 31/12/2025 | Texte vers image, mise à jour pour le réalisme | Apache 2.0 | Testée en fp8 : 98,8 s, 0,030 $ |
| Qwen-Image-2.0 | Annoncée le 10/02/2026 | Génération et retouche | Pas de poids publiés | — |
| Qwen-Image-2.1 | 20/09/2026 | Génère et retouche, 7 milliards de paramètres, images transparentes | Recherche, non commercial | Pas testée |
| Qwen-Image-2.1-Turbo | 09/10/2026 | La 2.1 en 8 étapes | Recherche, non commercial | Pas testée |
Une photo en local, pour un usage commercial : la 2512. Retoucher une photo : Edit 2511, la plus récente des Edit sous Apache 2.0. Séparer les éléments d'une image pour les déplacer : Layered. La 2.1 : seulement pour la recherche ou l'évaluation, d'après sa licence.
Le tiroir, variante par variante
Sur le compte Hugging Face de l'éditeur, « Qwen », onze dépôts portent le nom Qwen-Image au 26/10/2026 : huit génèrent ou retouchent des images, deux réécrivent des prompts, un note des images.
Première génération : le gros modèle de 20 milliards
Qwen-Image, l'original. Annoncé par son billet comme « a 20B MMDiT image foundation model », publié le 04/08/2025, et vendu pour son « complex text rendering ». Le texte, lui, est lu par un autre modèle, l'encodeur Qwen2.5-VL, fourni à côté. La fiche complète, réglages et LoRA compris, est dans la fiche Qwen-Image.
Qwen-Image-2512, la mise à jour de décembre. « la mise à jour de décembre » du modèle texte vers image, publiée le 31/12/2025. Sa promesse principale : « réduit considérablement l'aspect « généré par l'IA » », « en particulier pour les sujets humains ». L'éditeur avoue même que l'original « a du mal à rendre avec précision les caractéristiques faciales liées à l'âge (par exemple, les rides) ». Une note de version qui balance son grand frère : j'adore.
Qwen-Image-Edit, la retouche d'août. « la version d'édition d'images de Qwen-Image », « Construit à partir de notre modèle Qwen-Image 20B ». Elle modifie un objet, un style, un point de vue, et sait corriger le texte d'une image en gardant la police.
Qwen-Image-Edit-2509, l'itération de septembre. « l'itération mensuelle de Qwen-Image-Edit ». Ce qu'elle ajoute : plusieurs images en entrée (« La performance optimale est actuellement obtenue avec 1 à 3 images d'entrée »), une meilleure tenue des visages et des produits, et des guides de type ControlNet compris d'origine, comme une carte de profondeur ou des points de pose. Le GitHub de l'éditeur conseille d'ailleurs de prendre directement la 2509 plutôt que la première Edit.
Qwen-Image-Edit-2511, la plus récente des Edit. « une version améliorée par rapport à Qwen-Image-Edit-2509 » : moins de dérive de l'image, des personnages qui restent les mêmes d'une retouche à l'autre, et des LoRA de la communauté intégrés au modèle. C'est elle qu'on a testée, en 40 étapes comme dans le code de l'éditeur.
Qwen-Image-Layered, le découpeur. « un modèle capable de décomposer une image en plusieurs calques RGBA » : il découpe une image en calques transparents. Chaque calque se déplace, se recolore ou s'efface sans toucher au reste. Son GitHub prévient : les poids publiés sont réglés pour découper une image, et la génération de calques à partir d'un texte seul reste « limited ».
Deuxième génération : plus petite, et plus fermée
Qwen-Image-2.0, l'annoncée sans poids. Le GitHub de l'éditeur écrit, le 10/02/2026 : « Nous lançons Qwen-Image-2.0, un modèle de fondation de génération d'images de nouvelle génération », avec, entre autres, une architecture plus légère, « Taille de modèle plus petite avec une vitesse d'inférence plus rapide ». Aucun dépôt Qwen-Image-2.0 sur le compte Hugging Face de Qwen au 26/10/2026. Je ne note pas les absents.
Qwen-Image-2.1, le tout-en-un. « un modèle unifié de génération texte-vers-image et d'édition d'images », avec « 7B paramètres dans son composant de génération visuelle ». Elle génère des images normales ou transparentes, retouche à partir de « jusqu'à 10 images de référence », et se pilote par des cercles ou des masques dessinés. Publiée le 20/09/2026, réglée par défaut sur 40 étapes. Son encodeur de texte change : Comfy-Org fournit un « qwen3vl_8b » au lieu du Qwen2.5-VL 7B de la première génération.
Qwen-Image-2.1-Turbo, la pressée. « un checkpoint accéléré » de la 2.1, en « 8 denoising steps », et « La génération utilise CFG=1 par défaut ».
Les deux réécrivains, PE-T2I et PE-I2I. Ce ne sont pas des générateurs : ce sont deux modèles de 9 milliards de paramètres, des Qwen3.5-VL affinés, qui transforment une demande courte en prompt détaillé pour la 2.1, l'un pour créer une image, l'autre pour la retoucher. Même licence de recherche que la 2.1.
L'intrus, Qwen-Image-Bench. Malgré son nom, c'est un juge : « Un modèle juge affiné pour évaluer la qualité de la génération texte-vers-image (T2I) », construit sur un modèle de 27 milliards de paramètres. Il ne dessine rien. Il note.
Les licences : la même famille, deux régimes
Apache 2.0 pour les six variantes de la première génération. Chaque fiche Hugging Face l'écrit (« license: apache-2.0 »). Seul le dépôt de l'original contient le fichier de licence : le texte de la fondation Apache, avec « Copyright 2024 Alibaba Cloud ». En une phrase : utiliser, modifier, redistribuer, gratuitement, partout (« perpetual, worldwide, non-exclusive, no-charge, royalty-free »), à condition de joindre la licence et de signaler ce que tu as modifié si tu redistribues. Le détail est dans la fiche.
La « Qwen RESEARCH LICENSE AGREEMENT » pour la 2.1, la 2.1 Turbo et leurs réécrivains. Elle accorde les droits « À DES FINS NON COMMERCIALES UNIQUEMENT » (clause 2.a), définit le non commercial comme « à des fins de recherche ou d'évaluation uniquement » (clause 1.i), et demande une licence à part pour tout usage commercial (clause 2.b). Les textes de la 2.1 Turbo et des deux réécrivains sont identiques à celui de la 2.1, au caractère près.
C'est ça, le piège : le numéro le plus haut n'est pas celui qui te donne le plus de droits.
Les fichiers : officiels, repackagés, allégés
L'éditeur publie chaque variante au format Diffusers, en plusieurs morceaux : 57,70 Go de poids pour chaque variante de la première génération, encodeur et décodeur compris, dont 40,86 Go pour le seul modèle d'images en BF16. Pour la 2.1, 33,12 Go, et 14,23 Go pour le modèle d'images. L'éditeur ne publie aucune version allégée sur Hugging Face.
Les fichiers uniques pour ComfyUI viennent du compte Comfy-Org, « Fichiers de modèle reempaquetés pour ComfyUI » :
| Variante (Comfy-Org) | bf16 | Allégés |
|---|---|---|
| Qwen-Image | 40,86 Go | fp8 20,43 ; fp8mixed 20,53 ; fp8_hq 22,74 ; nvfp4 19,77 Go |
| Qwen-Image-2512 | 40,86 Go | fp8 20,43 Go |
| Qwen-Image-Edit | 40,86 Go | fp8 20,43 Go |
| Qwen-Image-Edit-2509 | 40,86 Go | fp8 20,43 ; fp8mixed 20,53 ; int8 20,50 Go |
| Qwen-Image-Edit-2511 | 40,86 Go | fp8mixed 20,53 ; int8 20,50 Go |
| Qwen-Image-Layered | 40,86 Go | fp8mixed 20,53 Go, plus son propre décodeur de 0,25 Go |
| Qwen-Image-2.1 et 2.1 Turbo | 14,23 Go chacune | int8 7,26 Go chacune |
| Encodeur de texte, 1re génération (Qwen2.5-VL 7B) | 16,58 Go | fp8 9,38 ; nvfp4 6,11 Go |
| Encodeur de texte, 2.1 (qwen3vl_8b) | 17,53 Go | int8 9,35 ; w4a8 6,31 Go |
| Décodeur d'image | 0,25 Go (1re génération) | 0,68 Go (2.1) |
Tailles en gigaoctets (milliards d'octets), notre calcul d'après les octets publiés par Hugging Face le 26/10/2026.
- Ce qu'on a testé : l'original et la 2512 en fp8, Edit 2511 en fp8mixed, avec l'encodeur en fp8 : 30,07 Go à installer par variante, 71,03 Go pour les trois, puisqu'elles partagent l'encodeur et le décodeur. Rien d'autre.
- L'installation la plus légère de la première génération chez Comfy-Org : l'original en nvfp4 avec l'encodeur nvfp4, 26,14 Go, notre calcul. La 2512 n'existe pas en nvfp4. Pas testé.
Comment on a testé
Le banc commun du catalogue : six photos du quotidien écrites en anglais, la même femme « à la fin de sa vingtaine avec des cheveux bruns arrivant aux épaules », graine 2210, 1152 × 1536, un tirage par prompt, aucun LoRA, le 25/10/2026 sur un pod Runpod (lien parrainé) avec une NVIDIA L40S louée 1,09 $/h et ComfyUI 0.42.0. Les étapes et le CFG sont ceux de l'éditeur : 50 étapes et CFG 4 pour l'original et la 2512, 40 étapes et CFG 4 pour Edit 2511. L'échantillonneur et ses réglages viennent des modèles de workflow Comfy-Org. On n'a pas utilisé l'outil de réécriture de prompt que l'éditeur recommande, et on a gardé le format du banc, 1152 × 1536, au lieu des 1140 × 1472 et 1104 × 1472 qu'il conseille en 3:4.
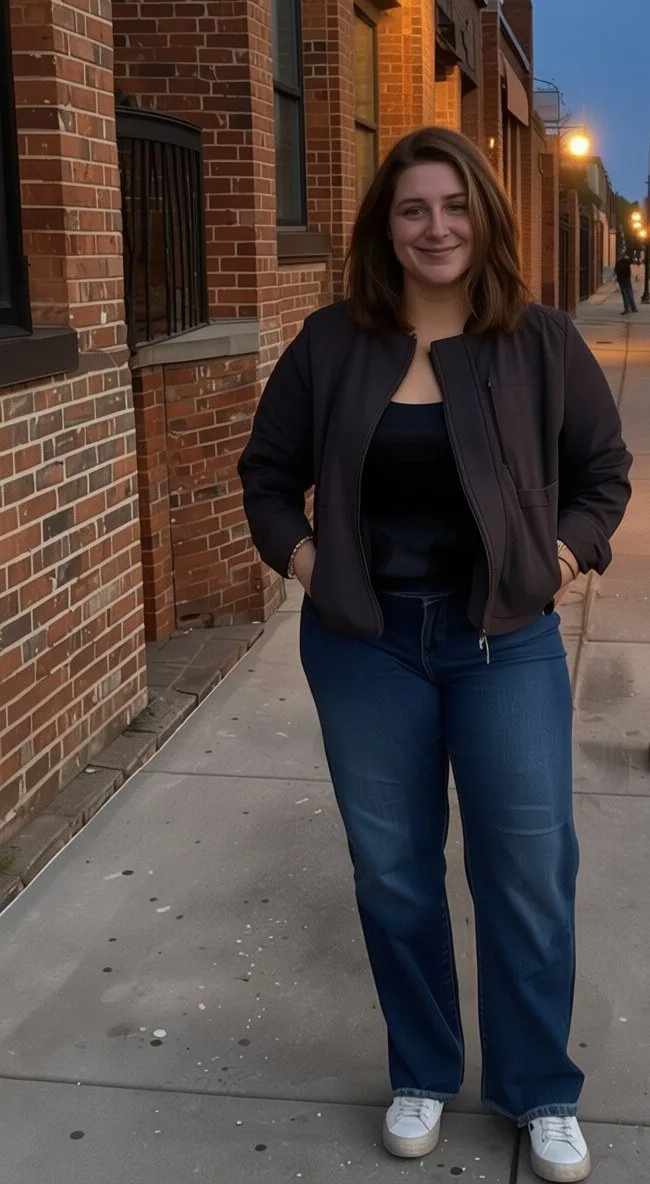
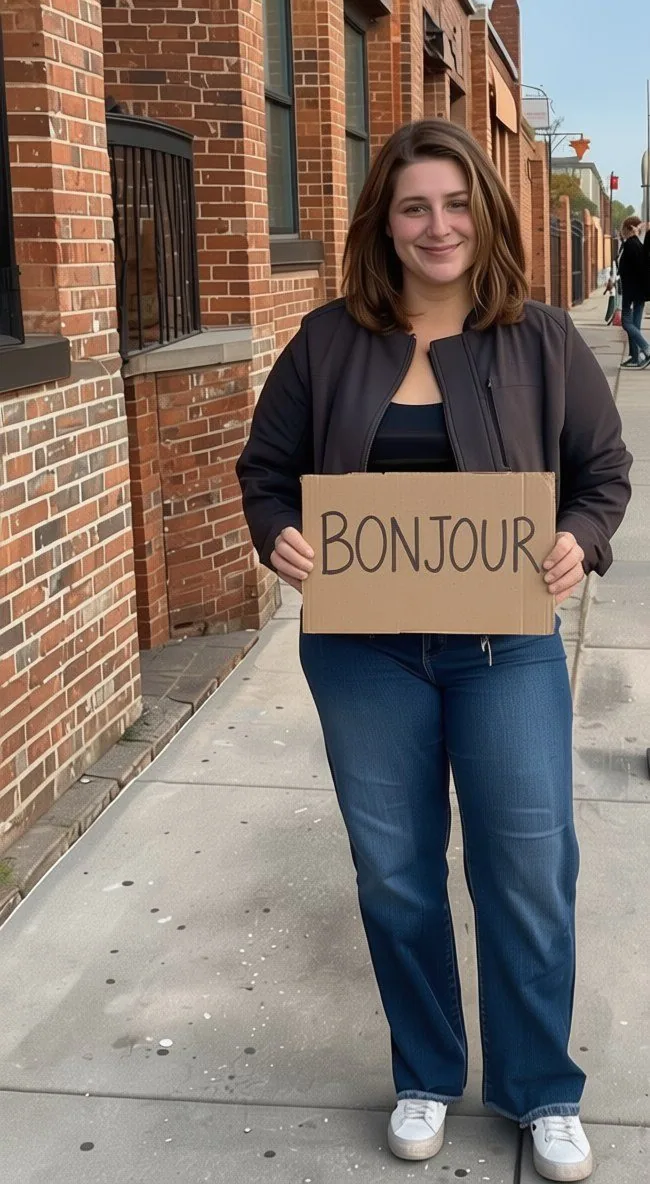
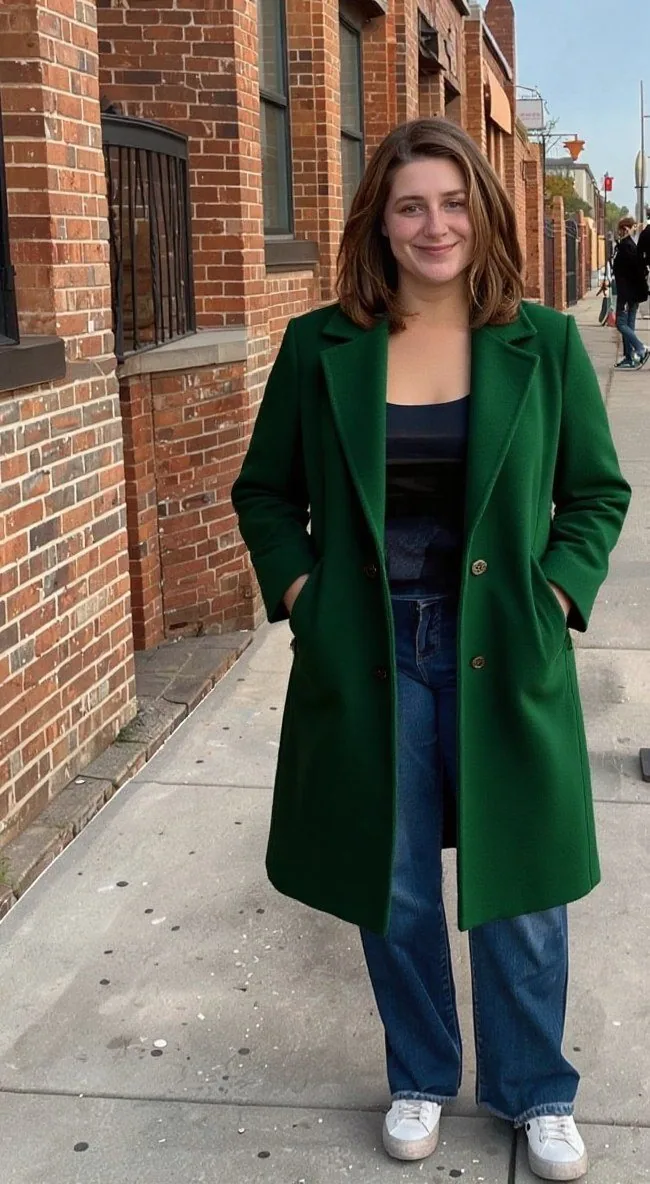
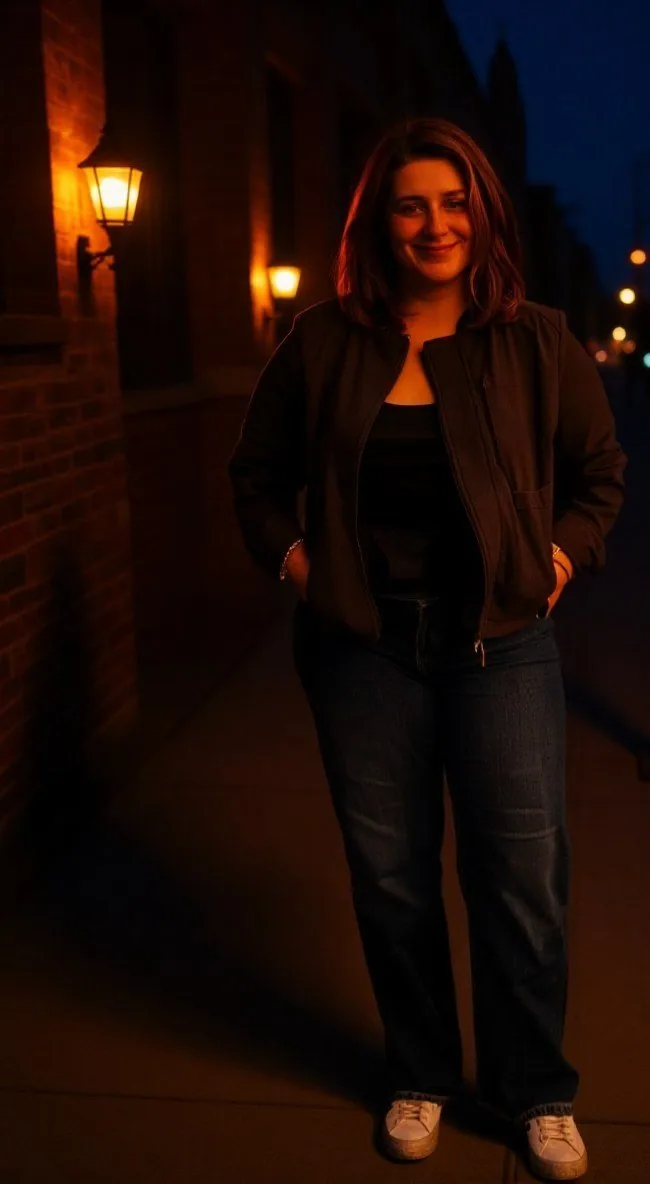
Pour la retouche, une seule photo d'entrée, une femme en veste sombre sur un trottoir, faite par FLUX.3 Klein sur notre banc du 23/10, et trois consignes : un manteau vert, le début de soirée, un petit carton « BONJOUR ».
Le repère, c'est FLUX.1 Kontext dev, d'une autre famille : le seul autre modèle de retouche passé au même banc, avec la même photo, les mêmes consignes et la même graine, sur un autre pod avec la même carte. Il tourne en fp8, en 20 étapes : il est là pour situer, pas pour gagner. Pas de repère sur les six photos : le duel avec Z-Image s'en charge.
La galerie
Qwen-Image : nos photos du banc, variante par variante
Banc du 25/10/2026 sur Runpod, une NVIDIA L40S à 1,09 $/h, ComfyUI 0.42.0, graine 2210, un tirage par prompt, fichiers fp8 de Comfy-Org (fp8mixed pour Edit 2511), réglages de l'éditeur pour Qwen (50 étapes et CFG 4 pour générer, 40 étapes et CFG 4 pour retoucher ; le repère Kontext, sur un autre pod avec la même carte, a ses propres réglages, voir son onglet), aucun LoRA. Temps par image, de l'envoi à l'image rendue (la première image de chaque modèle comprend le chargement) ; prix = notre calcul (durée × prix horaire de la carte). Recadrages et objectifs de téléphone floutés : c'est dit sous chaque image.
Qwen-Image 2512 fp8 · 50 étapes, CFG 4, négatif de l'éditeur · 98,8 s et 0,030 $ par image
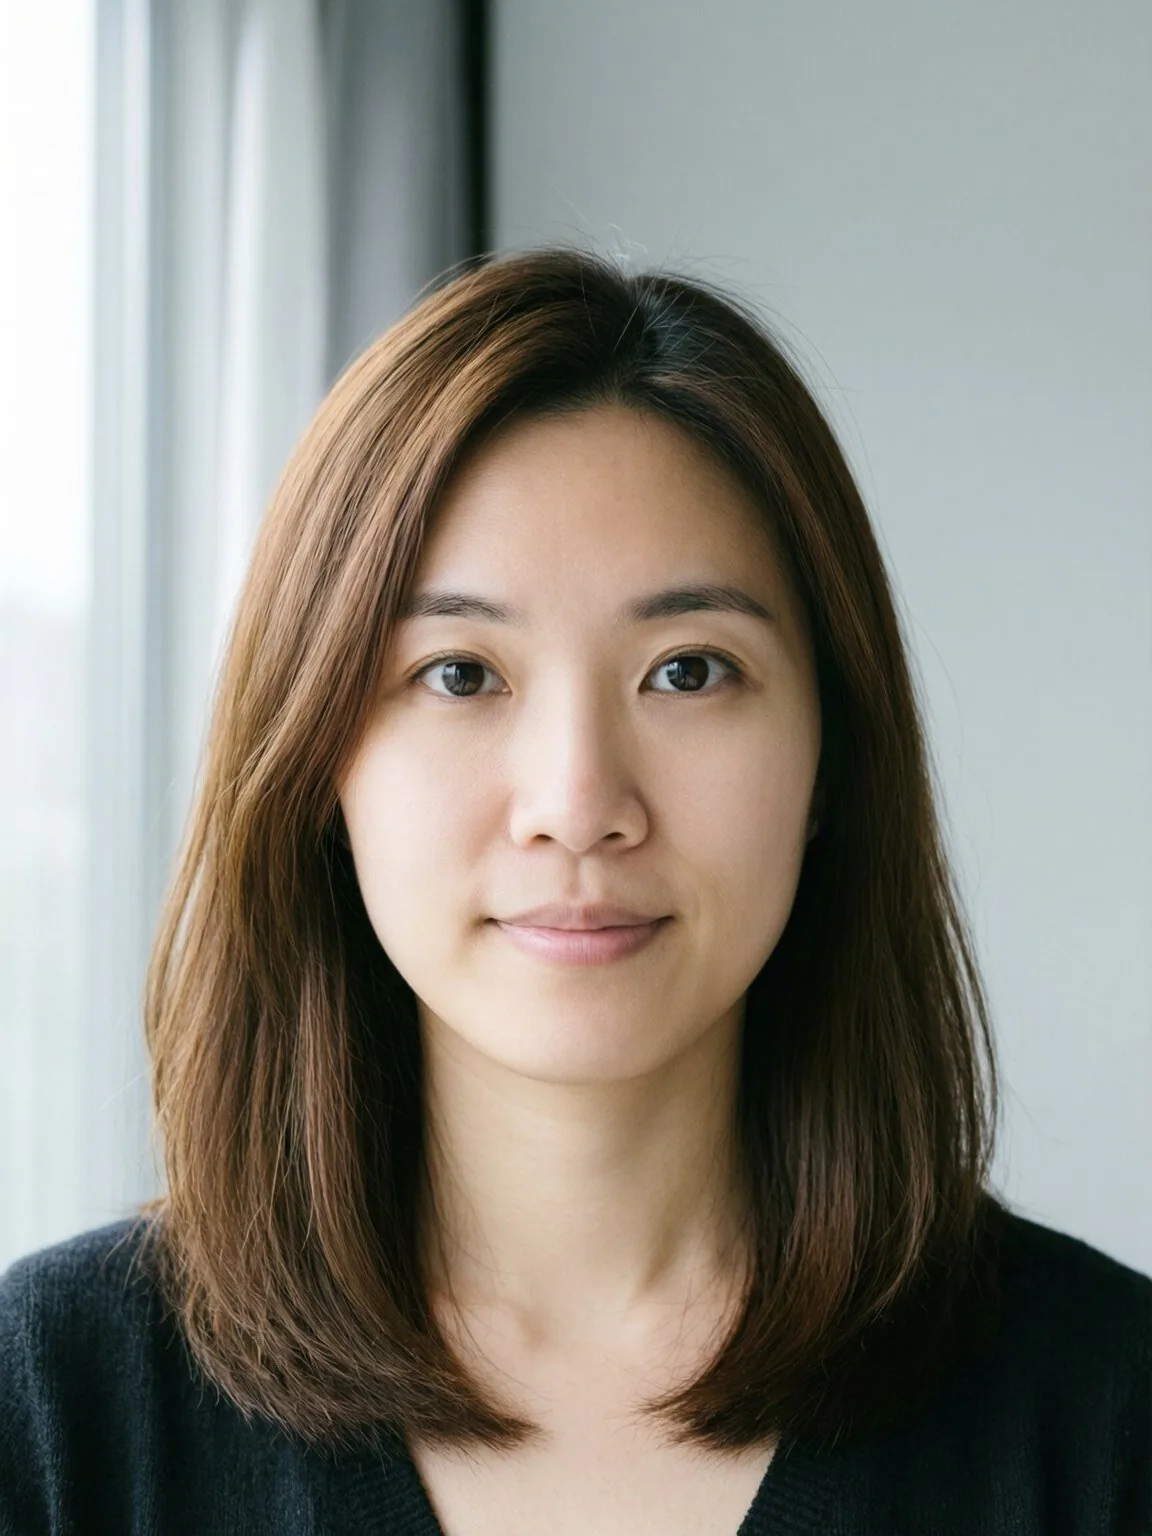
Portrait
Grain de peau, pull noir, fenêtre : une vraie photo de téléphone.
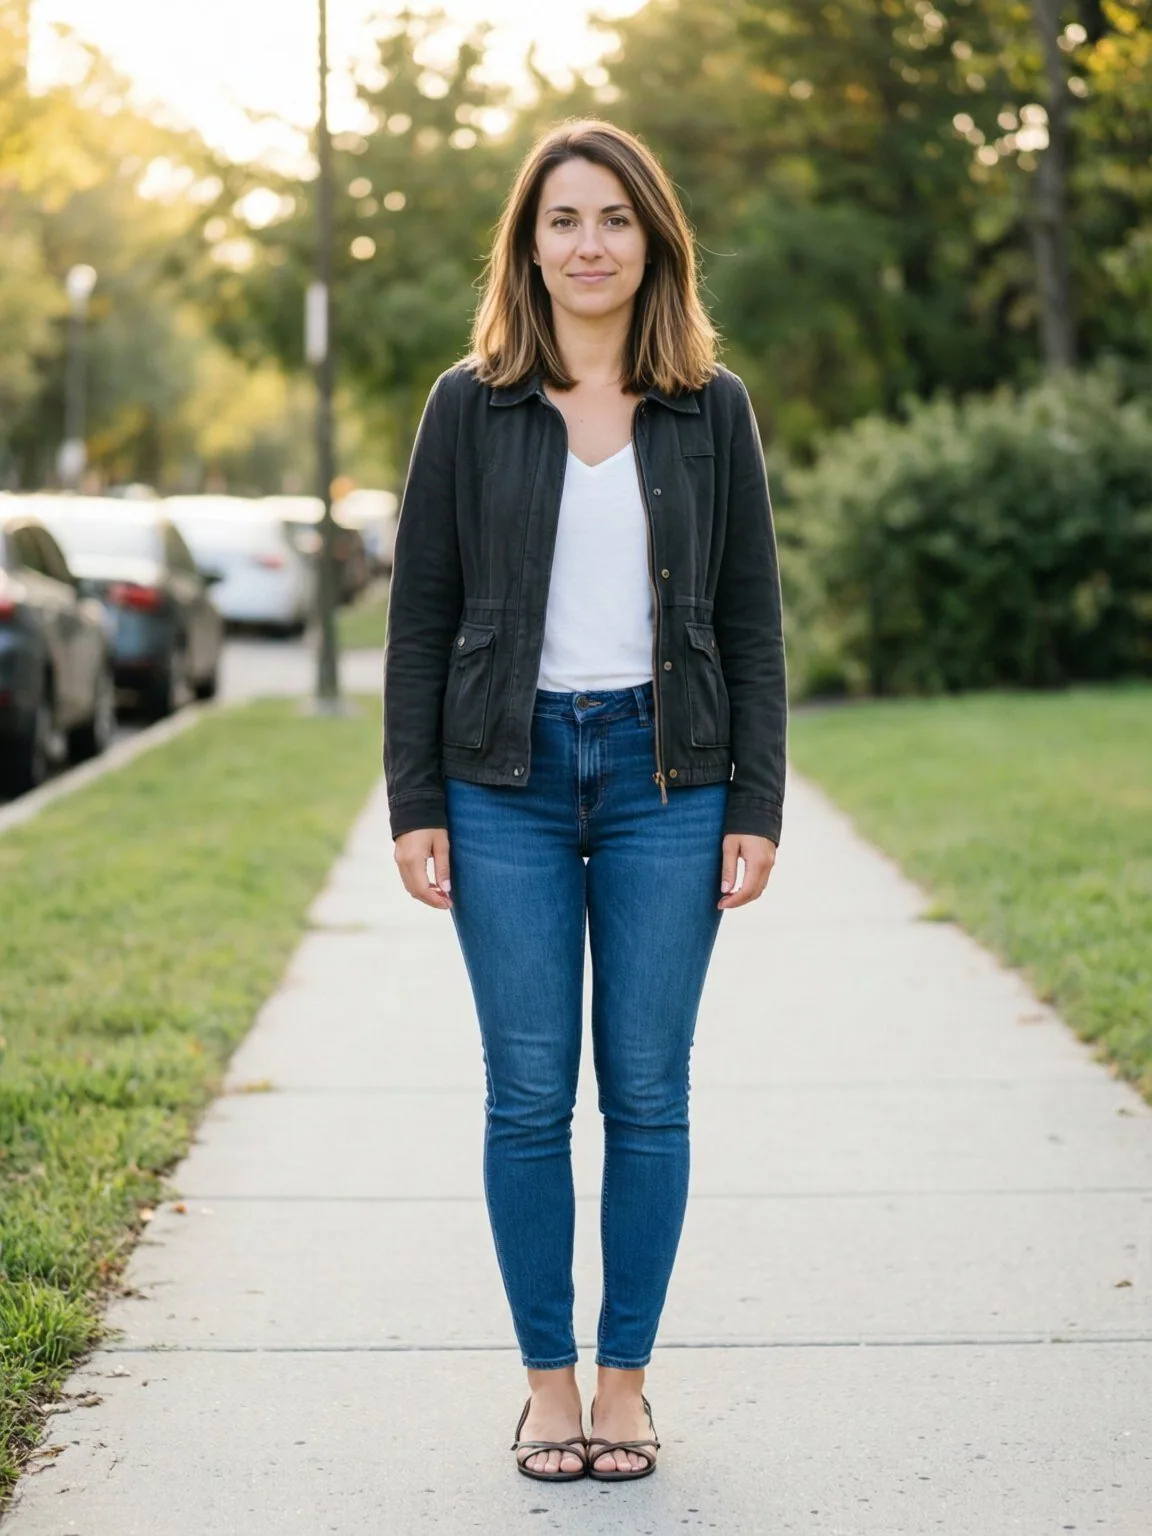
En pied
De la tête aux sandales, comme demandé.
Deux personnages
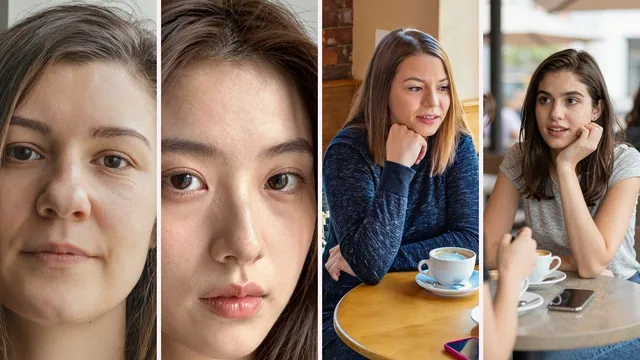
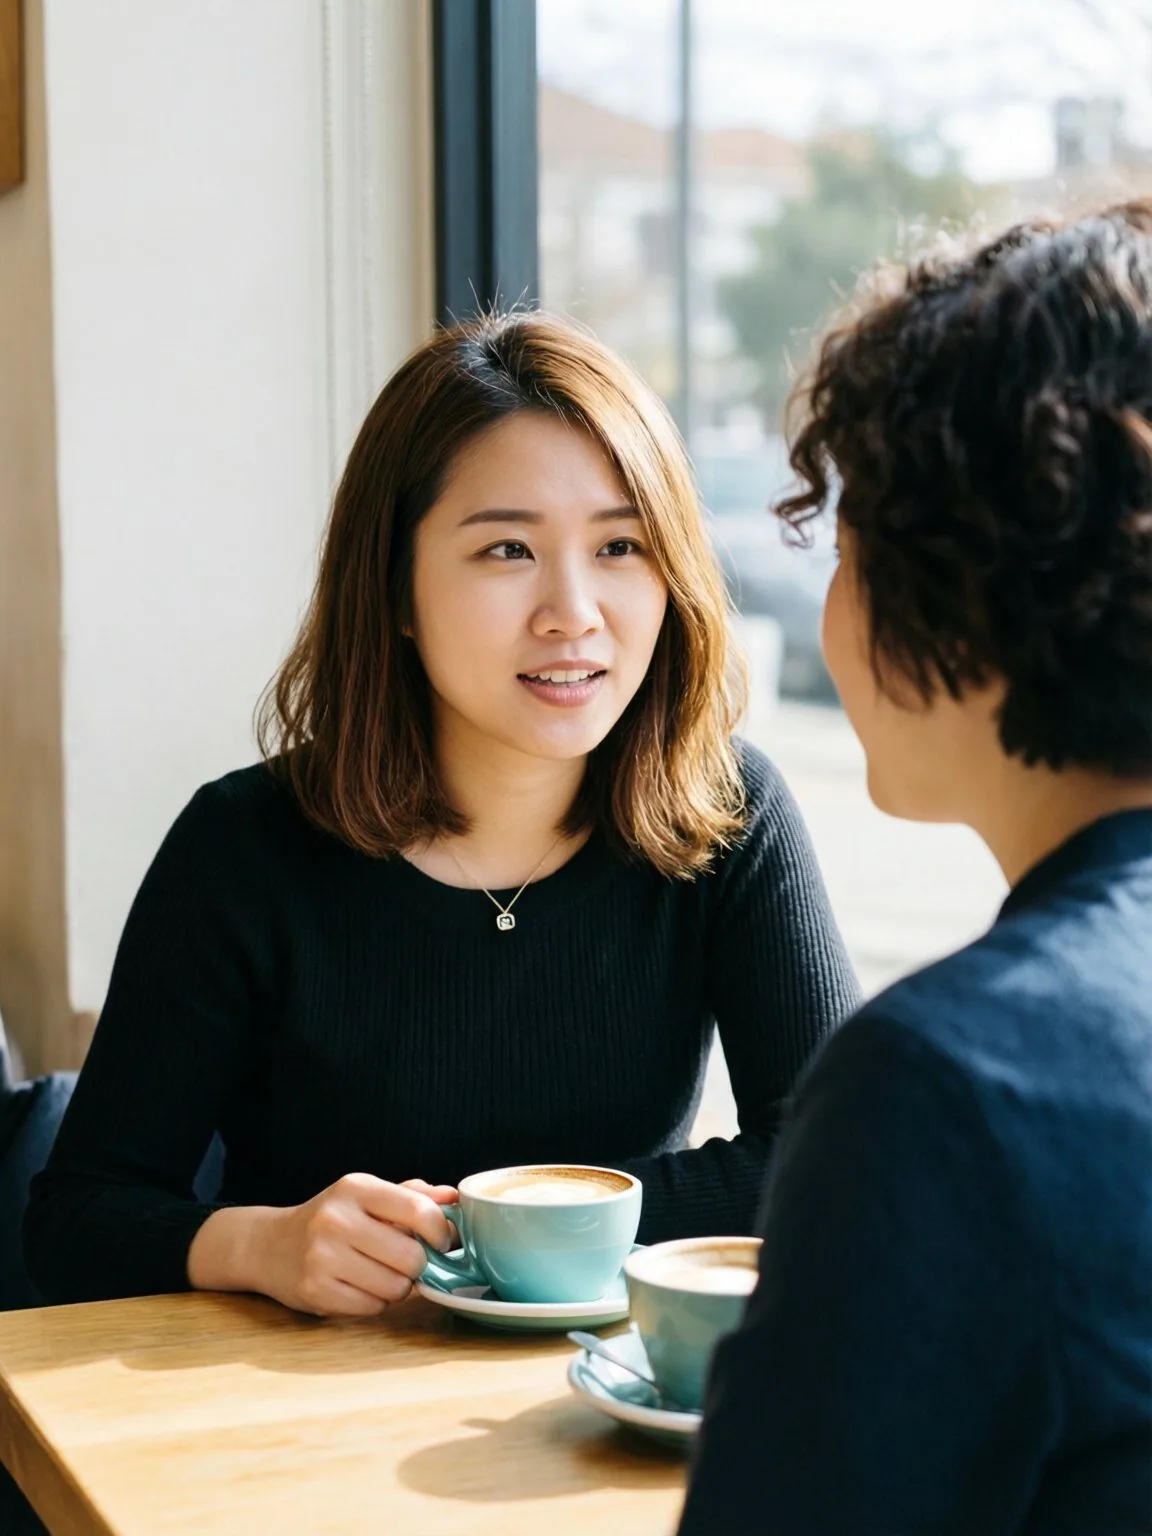
Deux personnes, deux tasses, l'amie aux cheveux courts et bouclés : tout y est.
Mains et objet
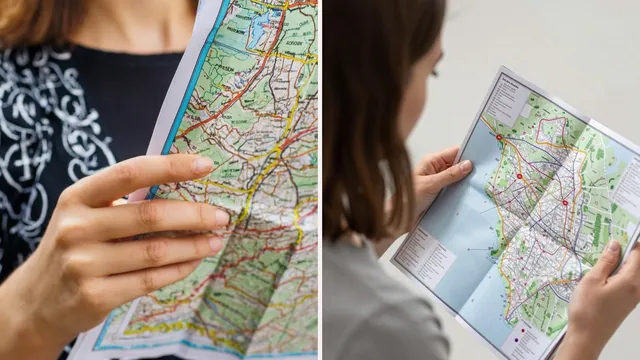
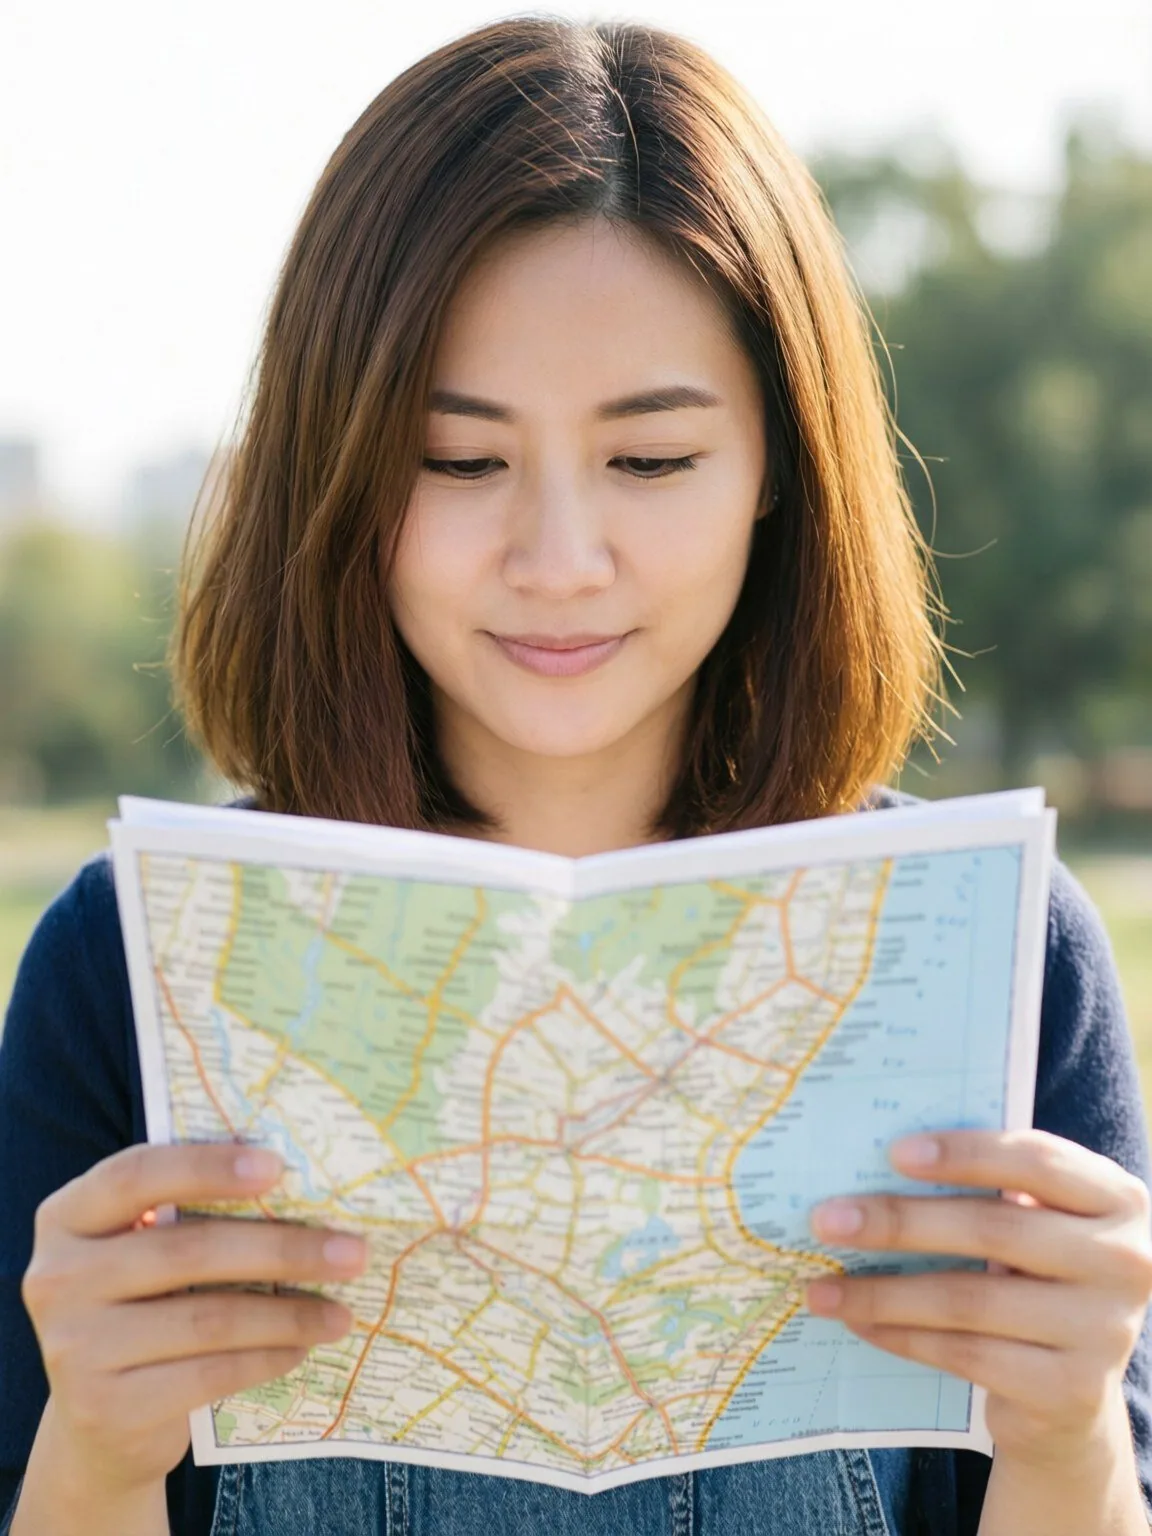
Les deux mains sur la carte, mais pas de gros plan : cadrée de la tête à la taille.
Nuit
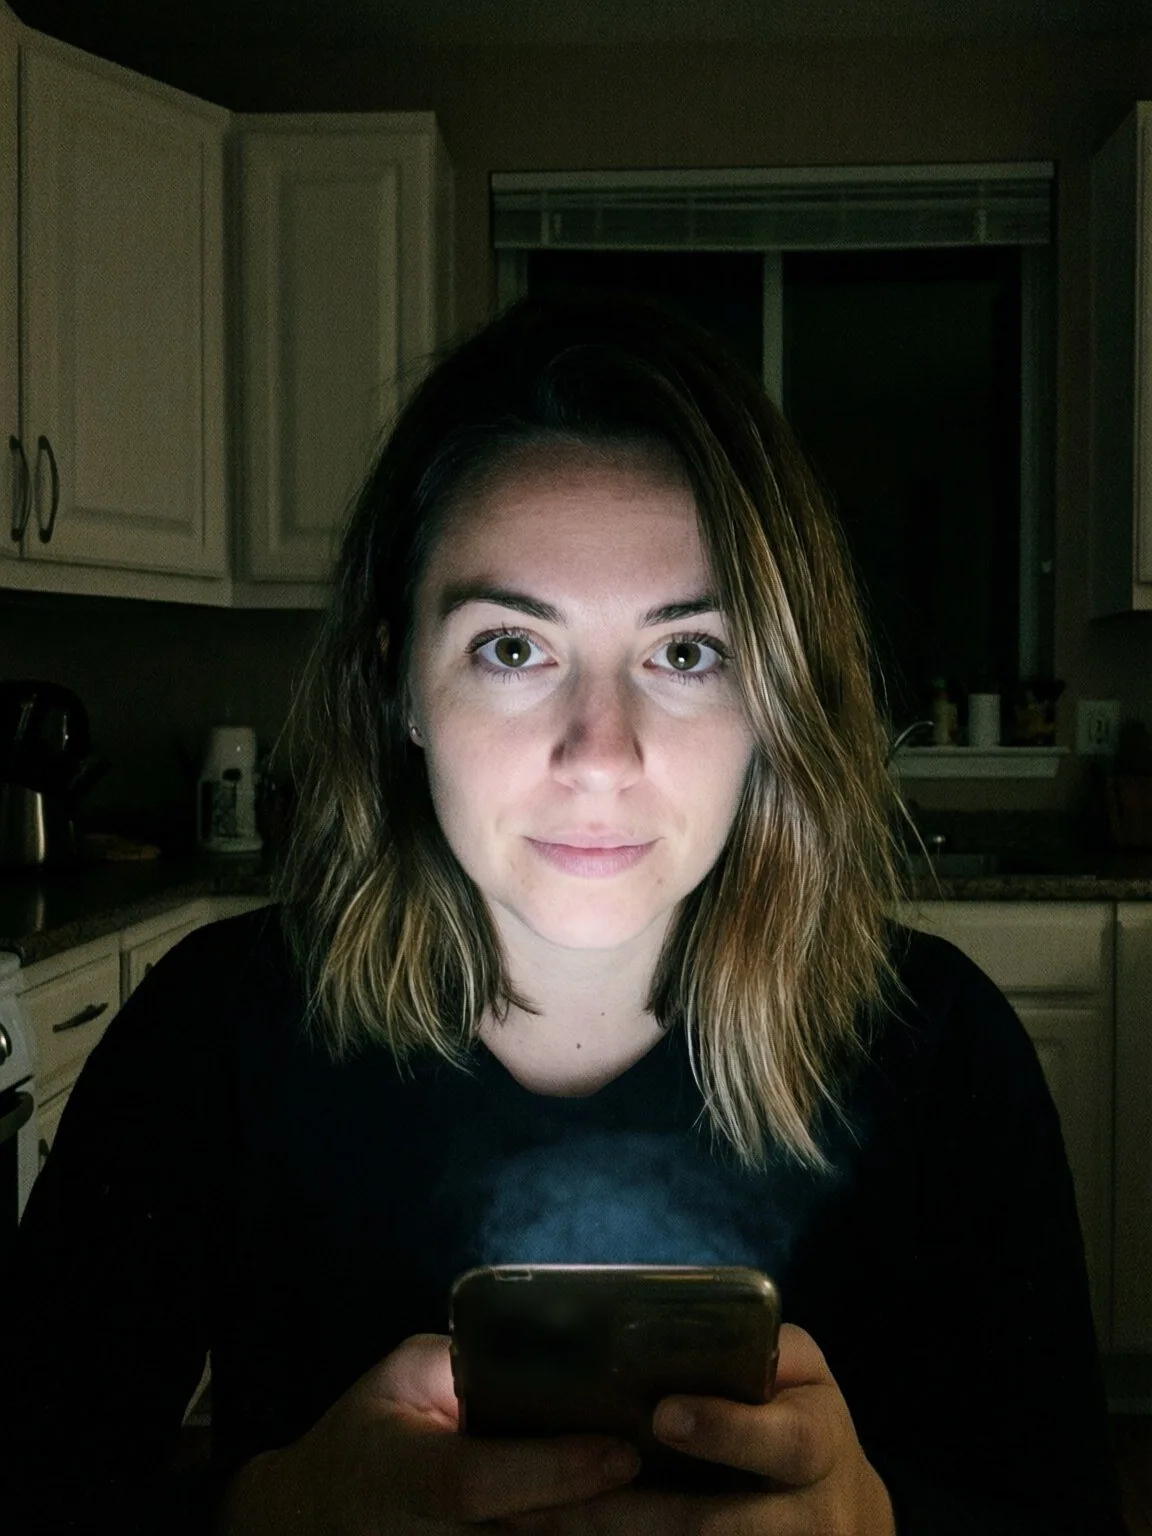
Raté : visage éclairé de face, regard vers l'objectif.
Texte dans l'image
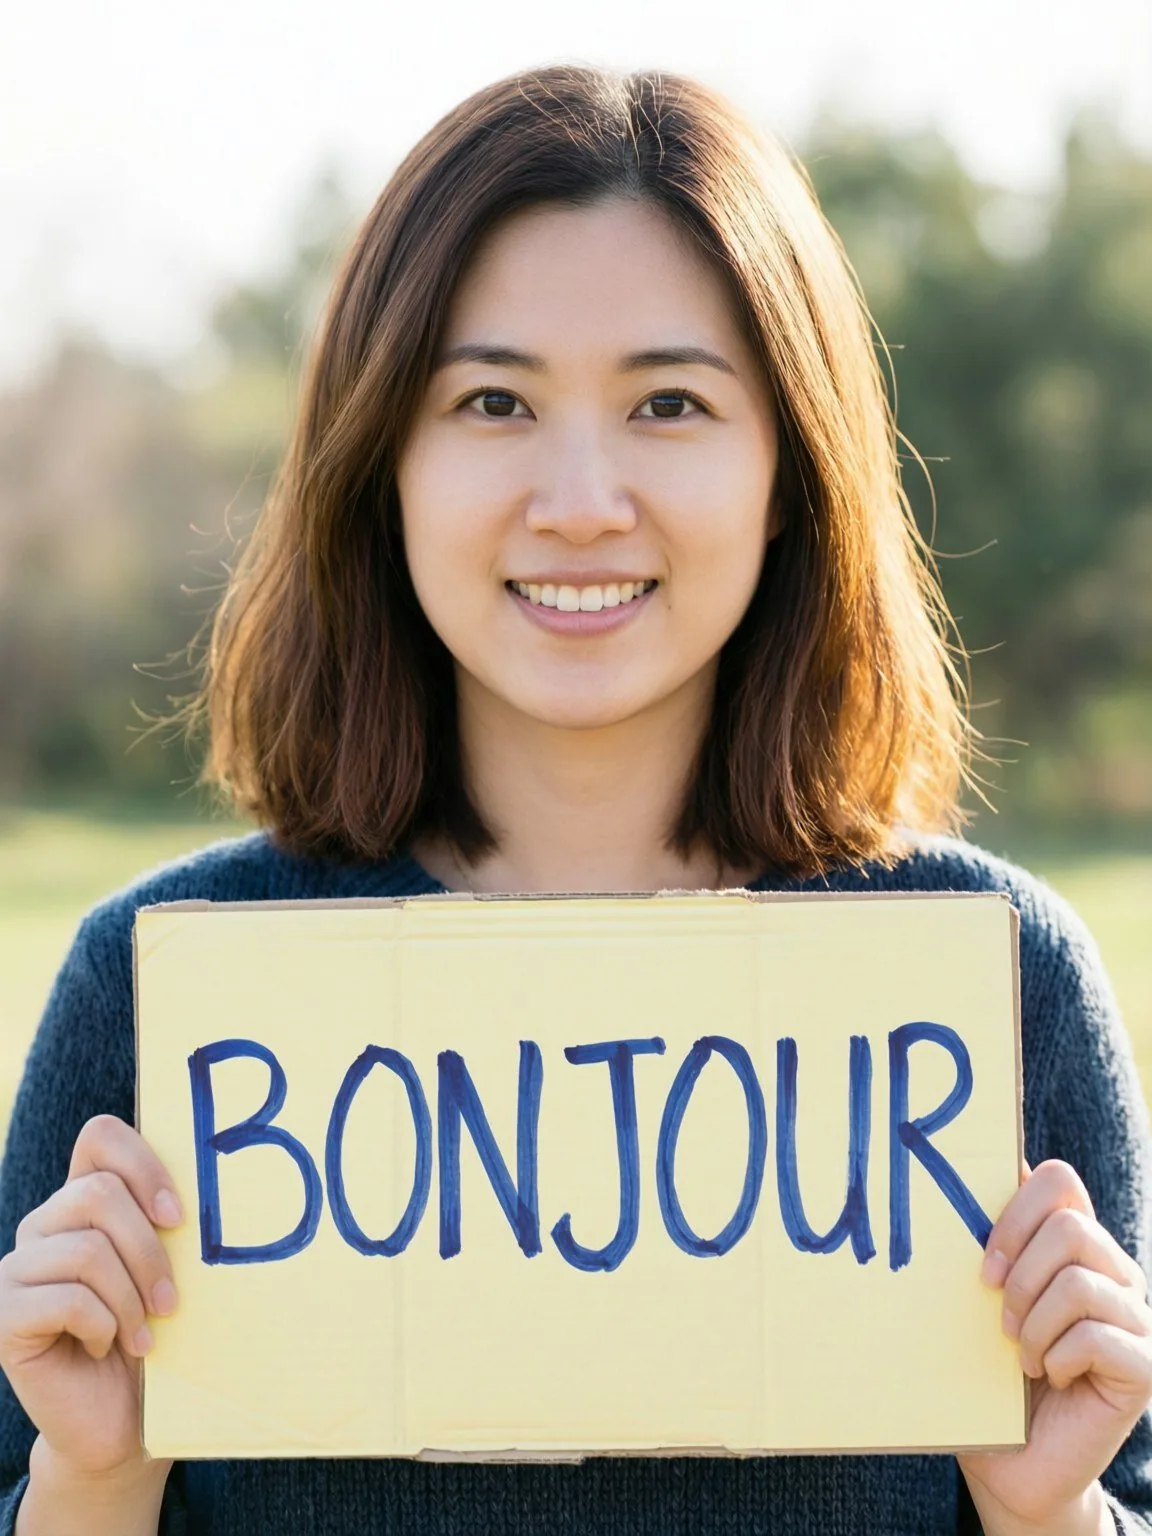
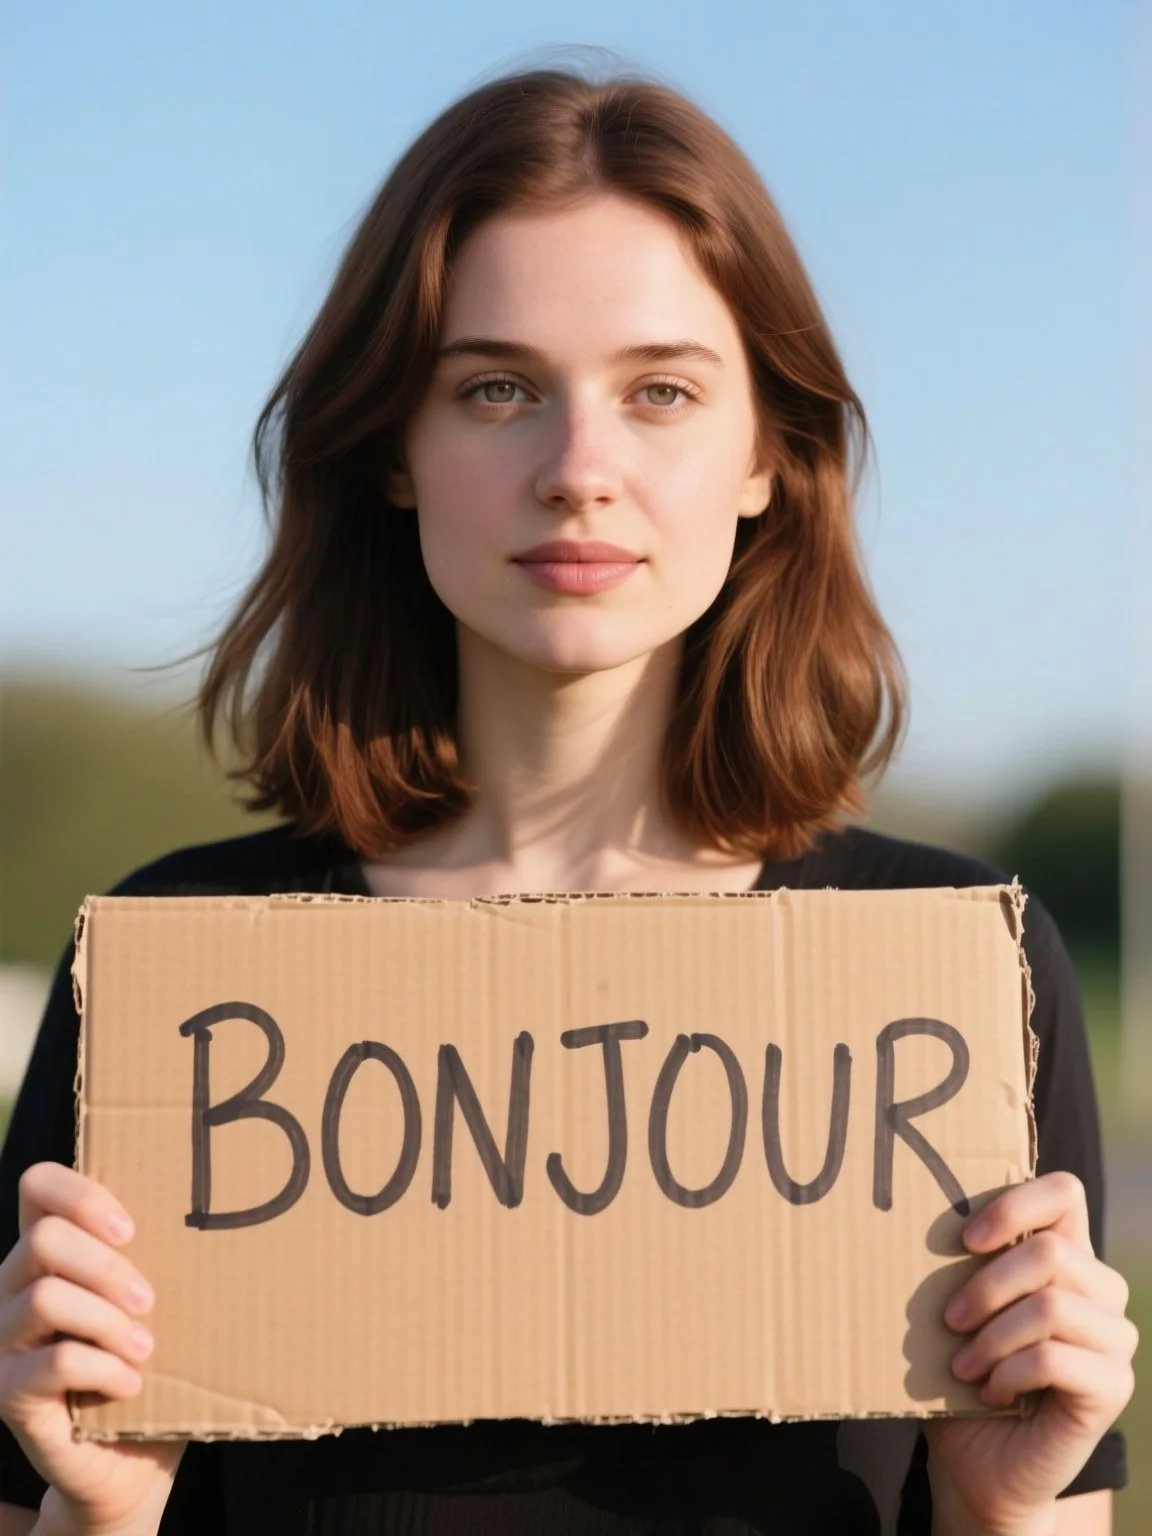
« BONJOUR » juste, rien d'autre sur le carton.
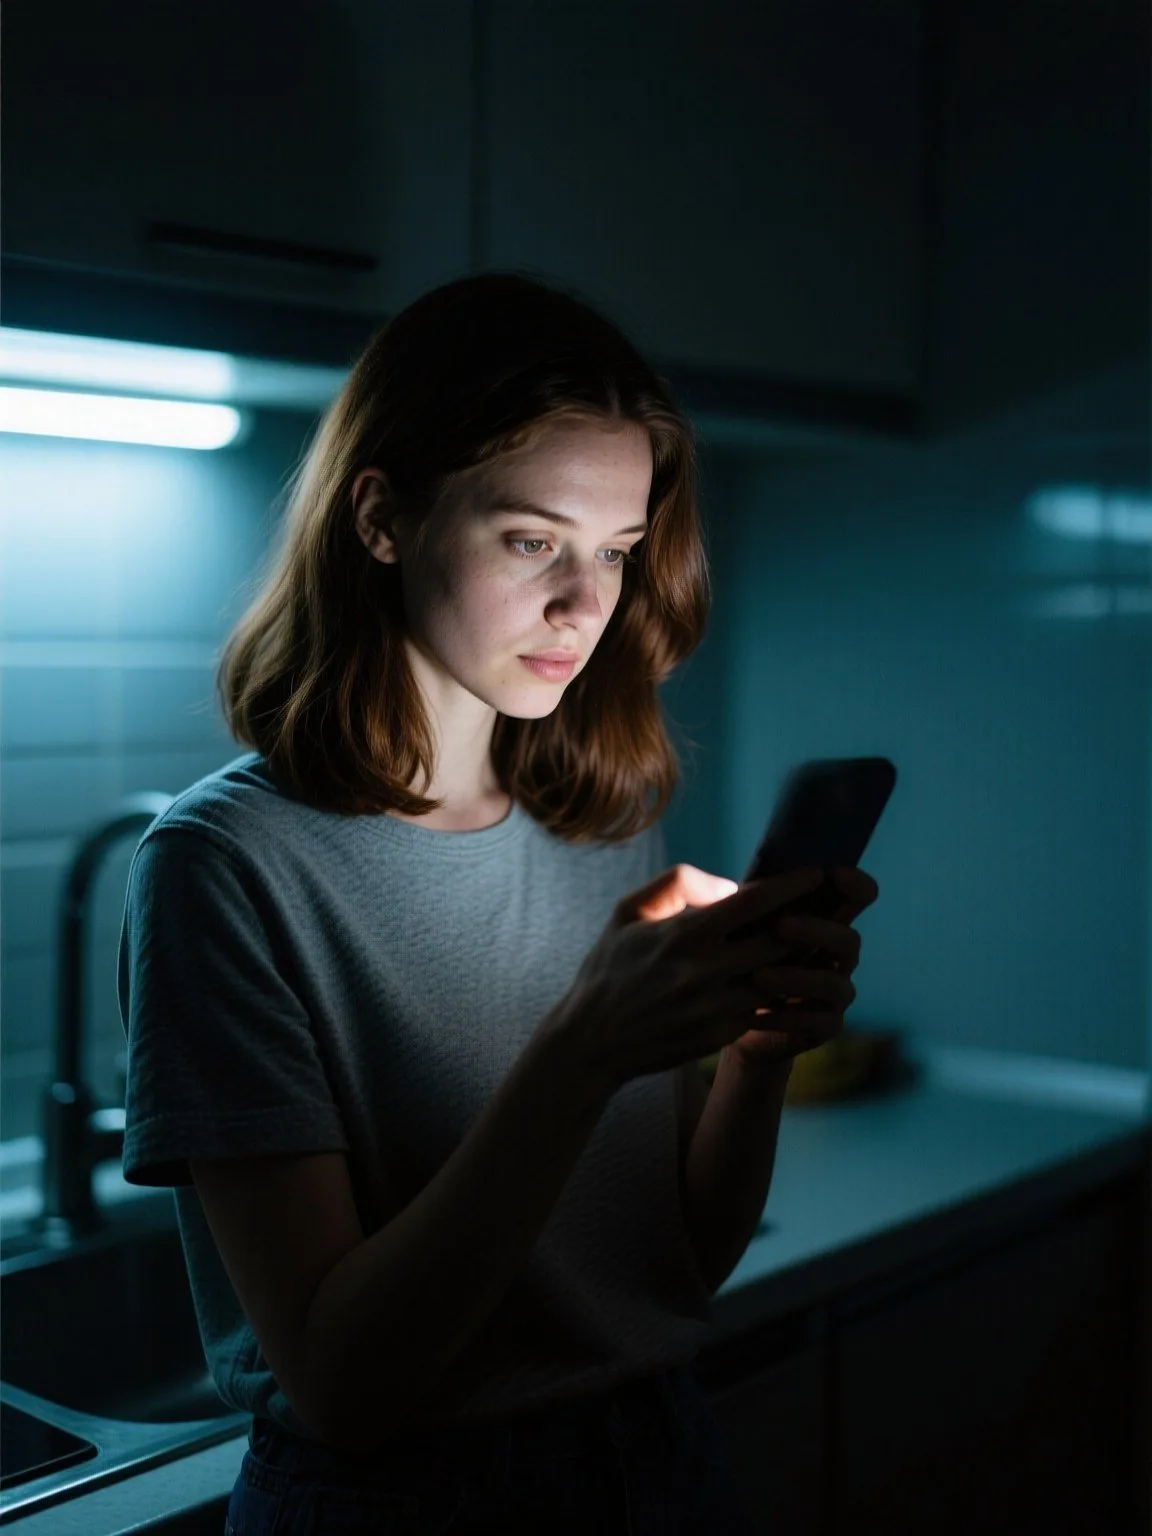
Qwen-Image (août 2025) fp8 · 50 étapes, CFG 4, négatif vide · 98,3 s et 0,030 $ par image
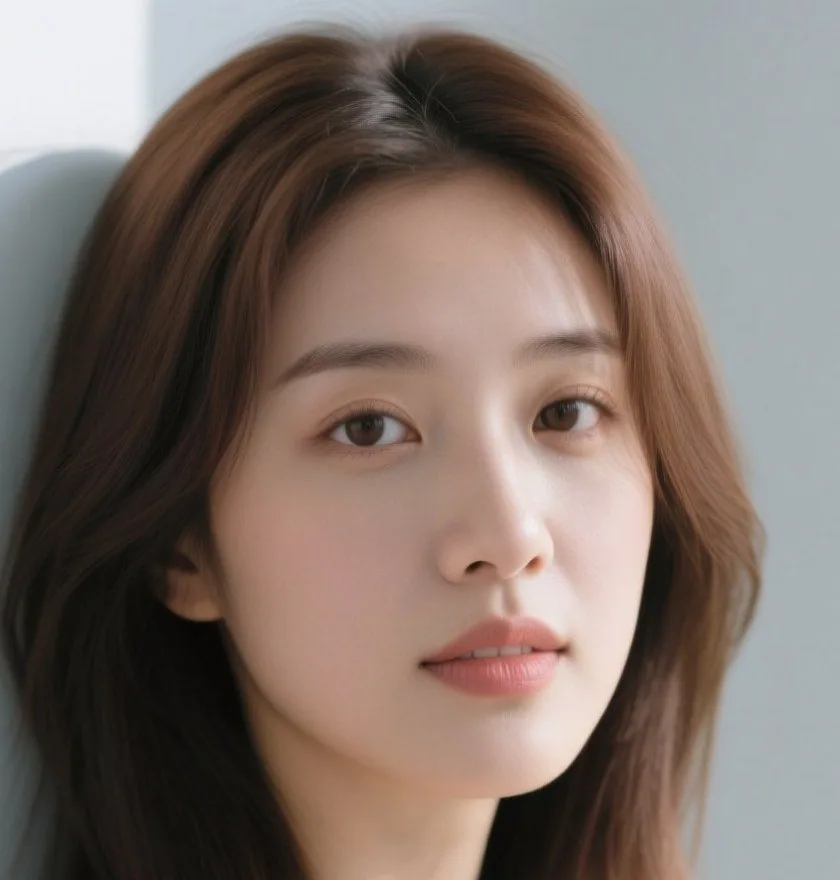
Portrait
Net, mais peau très lisse et lèvres maquillées, et un haut sans bretelles, épaules nues.
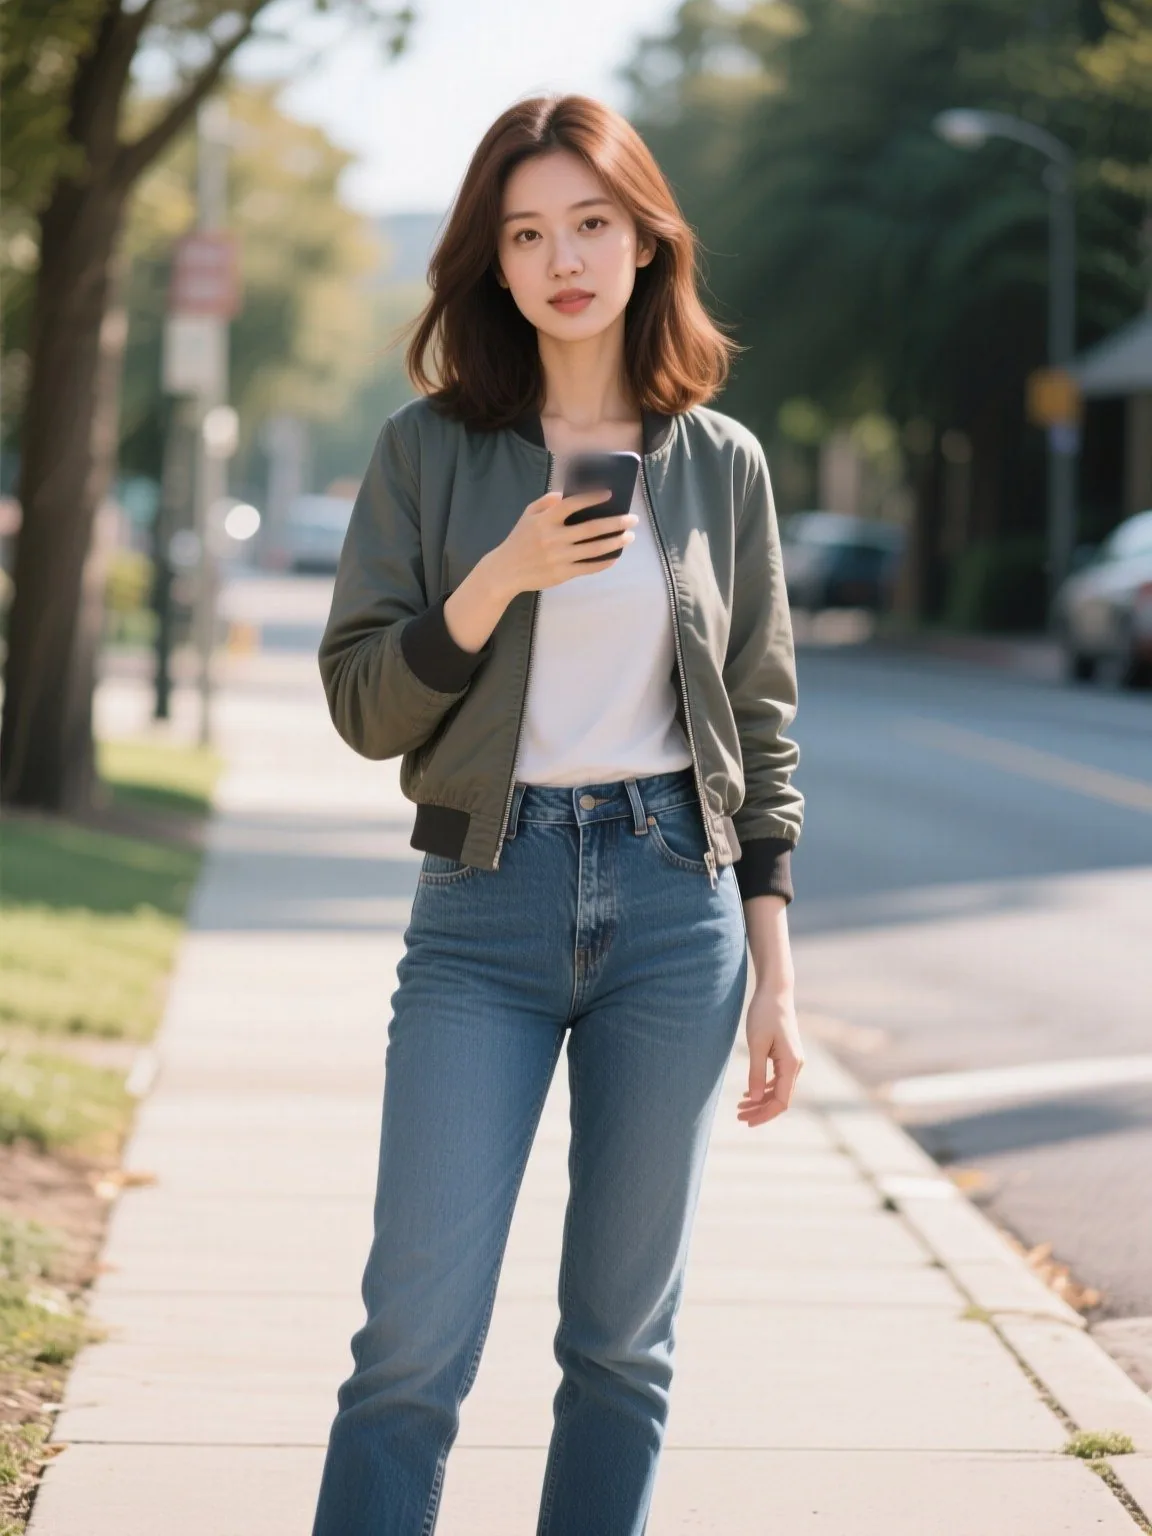
En pied
Raté : coupée aux tibias, pas de chaussures, et un téléphone que personne n'a demandé.
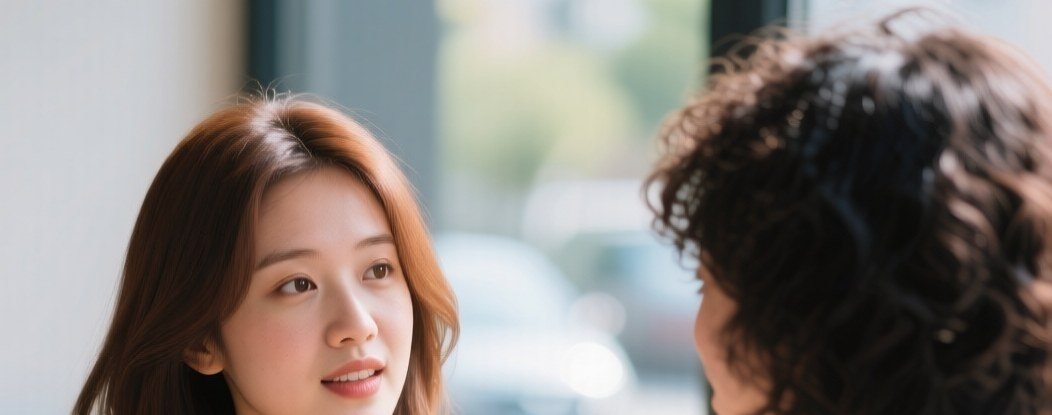
Deux personnages
Deux personnes, l'amie aux cheveux courts et bouclés ; les tasses sont sous notre cadre.
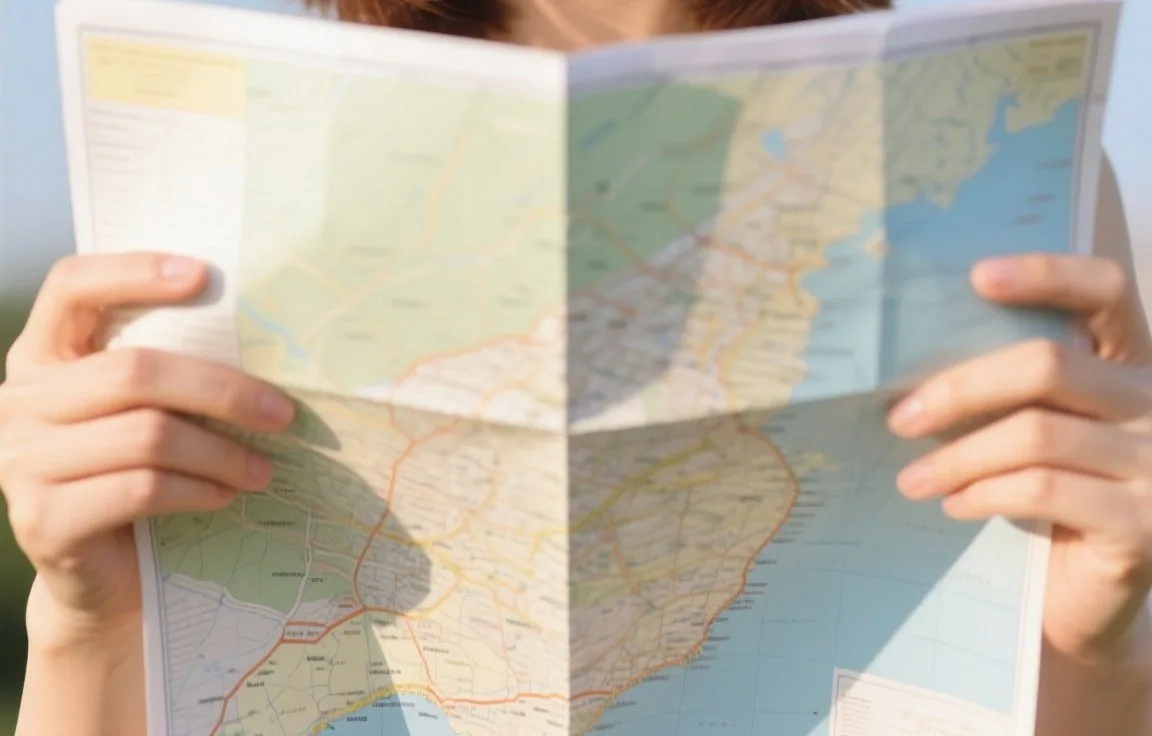
Mains et objet
Les deux mains sur la carte, mains correctes ; pas de gros plan, le visage est au-dessus.
Nuit
Presque : le visage est éclairé par l'écran, mais une réglette s'allume sous le placard.
Texte dans l'image
« BONJOUR » juste, rien d'autre sur le carton.
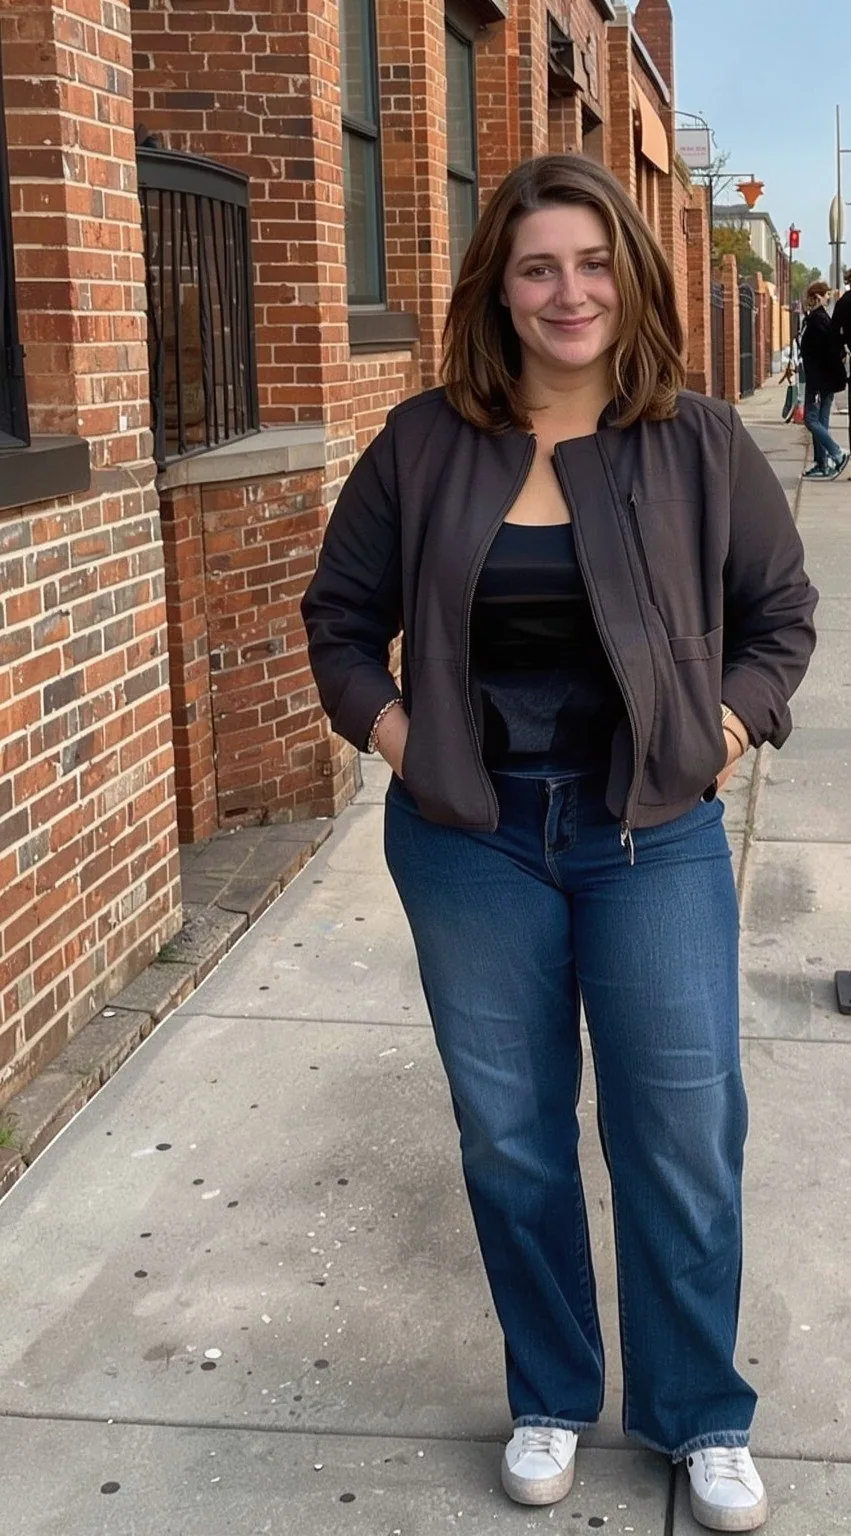
Qwen-Image-Edit 2511 fp8mixed · 40 étapes, CFG 4 · 106,1 s et 0,032 $ par retouche
Retouche
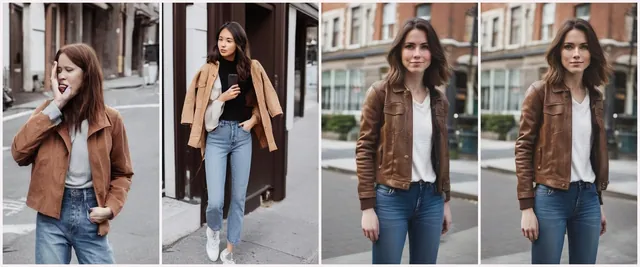
Les trois consignes faites, la scène gardée ; le « petit » carton barre le torse.
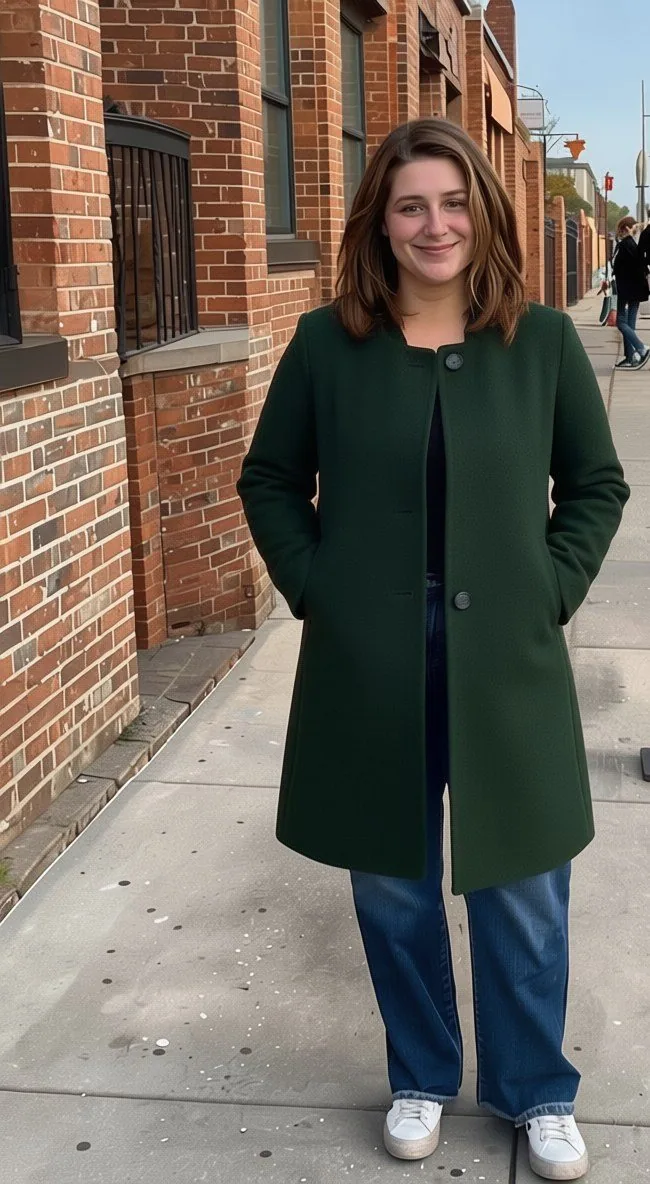
Repère : FLUX.1 Kontext dev autre famille · fp8 · 20 étapes, guidance 2,5 · 16,7 s et 0,005 $ par retouche
Retouche
Plus de six fois plus rapide, petit carton bien vu, mais le « début de soirée » devient la nuit noire.
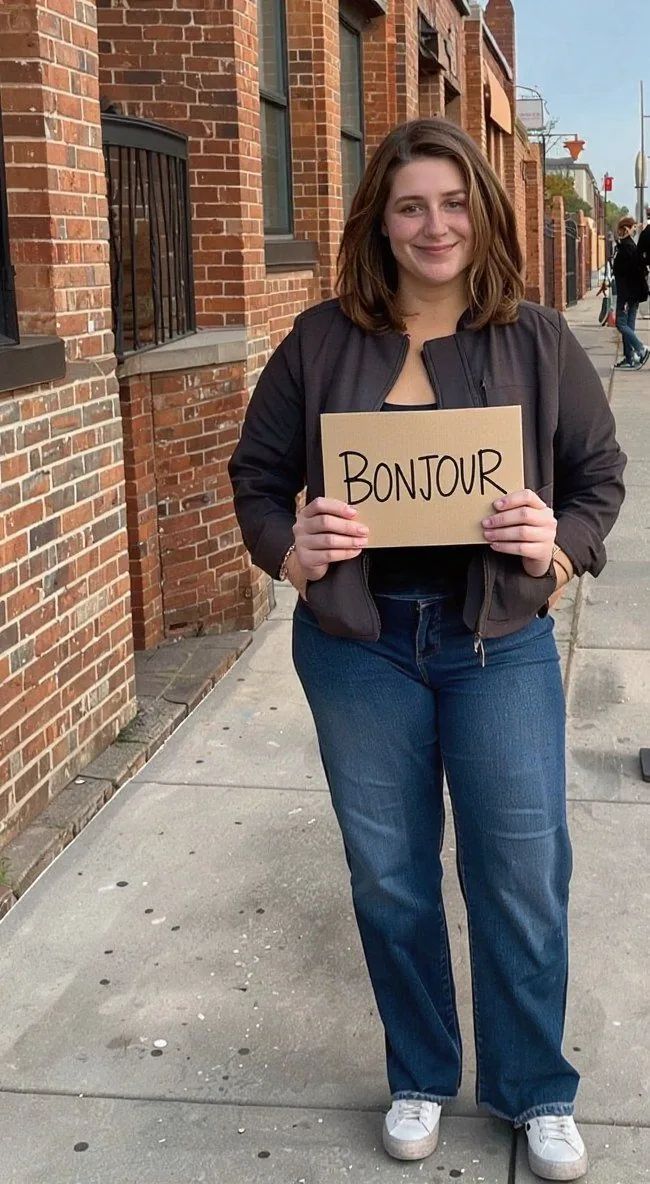
Aucune image n'est écartée. Trois photos de l'original sont recadrées, pour un haut sans bretelles, un débardeur et des bras nus derrière la carte, et les retouches sont toutes montrées sur une bande de gauche, sans la chaussée, les voitures et les immeubles colorés du fond. Trois téléphones ont l'objectif légèrement flouté, parce que leur bloc photo évoquait une marque. Chaque cas est dit sous l'image.
Ce qui change d'une version à l'autre, usage par usage
L'original contre la 2512
Le portrait. L'original pose un visage très lisse, lèvres maquillées, et un haut sans bretelles, épaules nues ; la 2512 met un pull noir et laisse voir le grain de la peau. La promesse de réalisme se voit, sur un tirage.
Le plan en pied. L'original coupe aux tibias et ajoute un téléphone ; la 2512 va de la tête aux sandales. Point 2512.
Deux personnes au café. Les deux font l'amie aux cheveux courts et bouclés et les deux tasses. Égalité.
Les deux mains sur une carte. Deux mains correctes chez les deux, mais aucun gros plan : celui de l'original, dans la galerie, c'est notre recadrage.
La nuit. Aucune ne réussit « visage éclairé uniquement par la lumière de l'écran d'un téléphone » : l'original allume une réglette sous le placard, la 2512 éclaire le visage de face et fait regarder l'objectif. L'original s'en approche plus, avec le visage baissé vers l'écran.
Le texte. « BONJOUR » juste chez les deux, rien d'autre sur le carton.
Bilan : la 2512 gagne là où l'éditeur l'annonce, les gens, et ne cède qu'un peu de terrain la nuit, où aucune des deux ne réussit, pour le même temps à une seconde près.
Edit 2511 contre le repère
Le manteau. Fait des deux côtés : vert foncé à col rond chez Qwen, vert vif à revers chez Kontext ; visage, pose et rue gardés.
Le début de soirée. Qwen fait ce qui est demandé : ciel bleu soutenu, lampadaires allumés, la femme inchangée. Kontext passe en pleine nuit, ajoute deux lanternes et vide la rue.
Le petit carton. « BONJOUR » juste des deux côtés, mais celui de Qwen barre le torse alors que la consigne disait « small » ; celui de Kontext est petit.
Le chrono. 106,1 s par retouche pour Qwen, 16,7 s pour Kontext (médianes des deux retouches qui suivent le chargement), avec deux fois moins d'étapes (20 contre 40) et un CFG à 1, sur un autre pod avec la même carte. Sur trois consignes et un tirage chacune, Qwen obéit mieux, Kontext répond plus vite.
Le temps et le prix
Une fois le modèle chargé, l'original rend une image en 98,3 s, la 2512 en 98,8 s : moins d'une seconde d'écart sur cinq images, donc rien à en conclure. Les deux coûtent 0,030 $ l'image, notre calcul au prix horaire de la carte. Les quinze images Qwen du banc reviennent à 0,47 $ au même calcul, hors installation et téléchargements ; le pod entier, téléchargements compris, a tourné 32 min 8 s, soit 0,58 $ au prix horaire.
La mémoire : ComfyUI prépare 19 483 Mo pour le modèle d'images en fp8 et 7 910 Mo pour l'encodeur. Ce n'est pas un pic, qu'on n'a pas mesuré. L'éditeur ne donne pas de mémoire minimale pour ses propres exemples. Dans sa rubrique « Community Support », son GitHub écrit qu'un outil de la communauté, DiffSynth-Studio, permet l'inférence de Qwen-Image « within 4GB VRAM » en déchargeant le modèle couche par couche, sans dire à quelle vitesse. Le modèle de workflow Comfy-Org de l'original, lui, note 86 % dans sa colonne « VRAM Usage » pour le fichier fp8 sur une « RTX4090D 24GB ». Ni l'un ni l'autre n'est testé chez nous.
Pour aller plus loin
- La fiche Qwen-Image : réglages, licence clause par clause, téléchargement, nos LoRA.
- Z-Image, quelle version choisir ?, l'autre grande famille ouverte du catalogue.
- Z-Image ou Qwen-Image ?, le duel des deux familles, à paraître le 06/11.
- Krea, quelle version choisir ?, à paraître le 07/11.
L'avis de Milky
Si tu ne retiens qu'une chose : pour faire des photos en local, sous une licence qui permet de vendre, c'est la 2512, et pour retoucher, Edit 2511. L'original, seulement si tu as déjà des LoRA dessus. Et la 2.1, aussi neuve soit-elle, je ne la conseille à personne qui veut travailler avec pour de l'argent : sa licence dit « À DES FINS NON COMMERCIALES UNIQUEMENT », en majuscules, pour être sûre qu'on l'entende. Le reste ? Je le range dans le tiroir.
Ce qu'on ne sait pas encore
- Si Qwen-Image 2.0 aura un jour des poids, et sous quelle licence.
- Ce que valent la 2.1 et la 2.1 Turbo sur notre banc, et ce que changent les LoRA Lightning à la lenteur de la première génération.
- Ce que donnent Edit 2509 et Layered sur nos photos, et la retouche à plusieurs images.
- La mémoire vraiment prise par chaque variante, et l'effet des fichiers allégés sur l'image.
Les mots à retenir
- Calque RGBA : une image avec un canal de transparence ; Layered en produit plusieurs à partir d'une seule photo.
- Réécrivain de prompt (PE) : le rôle de PE-T2I et PE-I2I, qui changent une demande courte, dans n'importe quelle langue, en prompt détaillé en anglais pour la 2.1, avec un format d'image conseillé.
- Fichier allégé (fp8, fp8mixed, int8, nvfp4) : les mêmes poids réécrits avec moins de chiffres par nombre ; chez Qwen, c'est Comfy-Org qui les publie, pas l'éditeur, et la 2512 n'en a qu'un, en fp8.
Tous nos mots expliqués : le glossaire →
Passages sources
Afficher les 28 sources
| Réf. | Citation (langue originale) | URL |
|---|---|---|
| S1↑1↑2↑3↑4↑5↑6+1 | API, compte « Qwen », 26/10/2026 : 469 modèles ; recherche « Qwen-Image » : "Qwen/Qwen-Image-2.1", "Qwen/Qwen-Image-2.1-Turbo", "Qwen/Qwen-Image-Edit-2511", "Qwen/Qwen-Image", "Qwen/Qwen-Image-Edit-2509", "Qwen/Qwen-Image-Edit", "Qwen/Qwen-Image-Layered", "Qwen/Qwen-Image-2.1-PE-T2I", "Qwen/Qwen-Image-2512", "Qwen/Qwen-Image-Bench", "Qwen/Qwen-Image-2.1-PE-I2I" (11) ; aucun dépôt Qwen-Image-2.0 ; aucun fichier allégé (fp8, int8, nvfp4) dans ces dépôts | https://huggingface.co/api/models?author=Qwen&search=Qwen-Image |
| S2↑1↑2↑3↑4↑5↑6+2 | "license: apache-2.0" ; "2025.08.04: We released Qwen-Image weights!" ; "complex text rendering" ; "Qwen-Image is licensed under Apache 2.0." ; "\"3:4\": (1140, 1472)" ; API : "parameters":{"BF16":20430401088}, "gated":false, fichier LICENSE présent | https://huggingface.co/Qwen/Qwen-Image |
| S3↑1↑2↑3↑4↑5↑6+3 | "Qwen-Image-2512, the December update of Qwen-Image’s text-to-image foundational model" ; "significantly reduces the “AI-generated” look and substantially enhances overall image realism, especially for human subjects" ; "The original Qwen-Image struggles to accurately render aged facial features (e.g., wrinkles)" ; "\"3:4\": (1104, 1472)" ; "license: apache-2.0" ; API : "parameters":{"BF16":20430401088} | https://huggingface.co/Qwen/Qwen-Image-2512 |
| S4↑1↑2↑3↑4↑5 | "We are excited to introduce Qwen-Image-Edit, the image editing version of Qwen-Image. Built upon our 20B Qwen-Image model" ; "enabling precise text editing" ; "adding, removing, or modifying elements" ; "object rotation, and style transfer" ; "while preserving the original font, size, and style" ; "license: apache-2.0" | https://huggingface.co/Qwen/Qwen-Image-Edit |
| S5↑1↑2↑3↑4↑5 | "Qwen-Image-Edit-2509, the monthly iteration of Qwen-Image-Edit" ; "Optimal performance is currently achieved with 1 to 3 input images." ; "Improved Person Editing Consistency" ; "Improved Product Editing Consistency" ; "Native Support for ControlNet: Including depth maps, edge maps, keypoint maps, and more." ; "license: apache-2.0" | https://huggingface.co/Qwen/Qwen-Image-Edit-2509 |
| S6↑1↑2↑3↑4↑5↑6+1 | "Qwen-Image-Edit-2511, an enhanced version over Qwen-Image-Edit-2509" ; "mitigate image drift, improved character consistency" ; "Qwen-Image-Edit-2511 integrates selected popular LoRAs" ; "\"num_inference_steps\": 40" ; "license: apache-2.0" | https://huggingface.co/Qwen/Qwen-Image-Edit-2511 |
| S7↑1↑2↑3↑4↑5↑6+1 | "a model capable of decomposing an image into multiple RGBA layers" ; "each layer can be independently manipulated without affecting other content" ; "base_model: - Qwen/Qwen-Image" ; "license: apache-2.0" ; "Qwen-Image-Layered is licensed under Apache 2.0." ; GitHub : "The released weights are specifically fine-tuned for the image-to-multi-RGBA decomposition task. As a result, while the model supports text-conditioned inference, its performance on text-to-multi-RGBA generation is limited." ; arXiv 2512.15603, "[Submitted on 17 Dec 2025]" | https://huggingface.co/Qwen/Qwen-Image-Layered |
| S8↑1↑2↑3↑4↑5↑6+2 | "a unified text-to-image generation and image editing model in the Qwen family. With just 7B parameters in its visual generation component" ; "Generate regular or transparent (RGBA) images from text" ; "Support up to 10 reference images, specify local edits via circles, painted annotations, or separate masks" ; "license_name: qwen-research" ; GitHub : "2026.09.20: We released Qwen-Image-2.1!" ; "2026.10.09: We released [Qwen-Image-2.1-Turbo]… for image generation and editing in just 8 denoising steps" ; "| num_inference_steps | 40 |" | https://huggingface.co/Qwen/Qwen-Image-2.1 |
| S9↑1↑2↑3↑4↑5↑6 | "Qwen-Image-2.1-Turbo is an accelerated checkpoint of [Qwen-Image-2.1]" ; "8 denoising steps" ; "Generation uses CFG=1 by default" ; "This model is licensed under the [Qwen Research License Agreement](./LICENSE)." | https://huggingface.co/Qwen/Qwen-Image-2.1-Turbo |
| S10↑1↑2↑3↑4↑5 | "Text-to-image prompt rewriting model for [Qwen-Image-2.1]… A fine-tuned Qwen3.5-VL 9B that turns a brief image request in any language into a detailed English prompt plus a recommended aspect ratio." ; "Image editing prompt rewriting model for [Qwen-Image-2.1]" ; "license_name: qwen-research" ; "This model is licensed under the [Qwen Research License Agreement](./LICENSE)." | https://huggingface.co/Qwen/Qwen-Image-2.1-PE-T2I |
| S11↑1↑2 | "A fine-tuned judge model for evaluating text-to-image (T2I) generation quality. Built on top of Qwen3.6-27B" ; "base_model: Qwen/Qwen3.6-27B" ; "license: apache-2.0" | https://huggingface.co/Qwen/Qwen-Image-Bench |
| S12↑1↑2↑3↑4↑5↑6+9 | GitHub de l'éditeur, « News » : "2026.02.10: We are launching Qwen-Image-2.0, a next-generation foundational image generation model." ; "Lighter Model Architecture – Smaller model size with faster inference speed." ; "2025.12.31: We released Qwen-Image-2512 weights!" ; "2025.12.31: [Qwen-Image-Lightning]…, developed by [Lightx2v]…" ; "2025.12.23: We released Qwen-Image-Edit-2511 weights!" ; "2025.12.19: We released Qwen-Image-Layered weights!" ; "2025.09.22: … Qwen-Image-Edit-2509, the monthly iteration of Qwen-Image-Edit" ; "2025.08.18: We’re excited to announce the open-sourcing of Qwen-Image-Edit!" ; "2025.08.04: We released Qwen-Image weights!" ; "Qwen-Image-Edit-2509 has better consistency than Qwen-Image-Edit; it is recommended to use Qwen-Image-Edit-2509 directly" ; "For enhanced prompt optimization and multi-language support, we recommend using our official Prompt Enhancement Tool powered by Qwen-Plus ." ; rubrique "Community Support" : "[DiffSynth-Studio]… provides comprehensive support for Qwen-Image, including low-GPU-memory layer-by-layer offload (inference within 4GB VRAM)" | https://github.com/QwenLM/Qwen-Image |
| S13↑1↑2↑3↑4↑5↑6+5 | "Repackaged model files for ComfyUI." ; "license: apache-2.0" ; dépôts d'origine Qwen/Qwen-Image, Qwen/Qwen-Image-2512, DiffSynth-Studio/Qwen-Image-Distill-Full ; qwen_image_bf16 40861031488 ; qwen_image_fp8_e4m3fn 20430635136 ; qwen_image_fp8mixed 20533672381 ; qwen_image_fp8_hq 22741809576 ; qwen_image_nvfp4 19769139136 ; qwen_image_2512_bf16 40861031488 ; qwen_image_2512_fp8_e4m3fn 20430679144 ; non_official/…/qwen_image_distill_full_… ; qwen_2.5_vl_7b 16584415576 ; …_fp8_scaled 9384670680 ; …_nvfp4 6114433446 ; qwen_image_vae 253806246 (a70580f0…) ; modèle de workflow "Qwen-Image 2512 Turbo" (image_qwen_image_2512_with_2steps_lora.json) | https://huggingface.co/Comfy-Org/Qwen-Image |
| S14↑1↑2↑3↑4↑5↑6 | "Repackaged model files for ComfyUI." ; "license: apache-2.0" ; base_model "FireRedTeam/FireRed-Image-Edit-1.0" ; LoRA de "dx8152" et "lrzjason" ; qwen_image_edit_bf16 40861031488 ; qwen_image_edit_fp8_e4m3fn 20430635136 ; qwen_image_edit_2509_fp8_e4m3fn 20430698424 ; …_2509_fp8mixed 20533579421 ; …_2509_int8_convrot 20499083752 ; qwen_image_edit_2511_bf16 40861031560 ; …_2511_fp8mixed 20533762817 ; …_2511_int8_convrot 20499083824 | https://huggingface.co/Comfy-Org/Qwen-Image-Edit |
| S15↑1↑2 | "Repackaged model files for ComfyUI." ; "Original model repository: https://huggingface.co/Qwen/Qwen-Image-Layered" ; qwen_image_layered_bf16 40861043888 ; qwen_image_layered_fp8mixed 20533591821 ; qwen_image_layered_vae 253816616 | https://huggingface.co/Comfy-Org/Qwen-Image-Layered |
| S16↑1↑2↑3↑4↑5 | "Repackaged model files for ComfyUI." ; "license_name: qwen-research" ; "For faster inference, use either the full Turbo model, or the Turbo LoRA extracted from the base model. Use 8 steps and cfg 1." ; qwen_image_2.1_bf16 14230280616 ; …_int8_convrot 7256783064 ; qwen_image_2.1_turbo_bf16 14230280616 ; …_turbo_int8_convrot 7256787829 ; qwen_image_2.1_turbo_lora_avg_rank_178_bf16 913314512 ; qwen3vl_8b_bf16 17534334616 ; …_int8_convrot 9350798360 ; …_w4a8 6312105364 ; qwen_image_2.1_vae_bf16 675509688 ; réécrivains int8 9471072252, w4a8 6724090764 | https://huggingface.co/Comfy-Org/Qwen-Image-2.1 |
| S17↑1↑2↑3 | "Apache License Version 2.0, January 2004" ; "a perpetual, worldwide, non-exclusive, no-charge, royalty-free, irrevocable copyright license to reproduce, prepare Derivative Works of, publicly display, publicly perform, sublicense, and distribute" ; "(a) You must give any other recipients of the Work or Derivative Works a copy of this License" ; "(b) You must cause any modified files to carry prominent notices stating that You changed the files" ; "Copyright 2024 Alibaba Cloud" | https://huggingface.co/Qwen/Qwen-Image/blob/main/LICENSE |
| S18↑1↑2↑3↑4↑5↑6+1 | "Qwen RESEARCH LICENSE AGREEMENT Release Date: September 20, 2026" ; 1.i "\"Non-Commercial\" shall mean for research or evaluation purposes only." ; 2.a "…FOR NON-COMMERCIAL PURPOSES ONLY." ; 2.b "You shall not use the Materials for any commercial purpose without obtaining a separate commercial license from us." ; licences de la 2.1 Turbo, de PE-T2I et de PE-I2I identiques (diff du 26/10/2026) | https://huggingface.co/Qwen/Qwen-Image-2.1/blob/main/LICENSE |
| S19↑1↑2 | Modèles de workflow Comfy-Org : « image_qwen_image » : "GPU:RTX4090D 24GB" ; "| Configuration | VRAM Usage | 1st Generation | 2nd Generation |" ; "Fp8_e4m3fn | 86% | ≈ 94s | ≈ 71s" ; ModelSamplingAuraFlow 3,1, euler, simple ; « image_qwen_Image_2512 » : 50 étapes, CFG 4 ; « image_qwen_image_edit_2511 » : 40 étapes, CFG 4, CFGNorm 1 | https://github.com/Comfy-Org/workflow_templates |
| S20↑1↑2 | "a 20B MMDiT image foundation model" | https://qwenlm.github.io/blog/qwen-image/ |
| R1↑1↑2↑3↑4↑5↑6+1 | Pod Runpod, NVIDIA L40S « 46068 MiB », 1,09 $/h, ComfyUI 0.42.0, 25/10/2026 ; fichiers Comfy-Org fp8, fp8mixed, encodeur fp8, VAE (même SHA-256 que celui de Comfy-Org/Qwen-Image) ; « QwenImage … 19483MB Staged », « QwenImageTEModel_ … 7910MB Staged » ; pic non mesuré ; pod « 32 min 8 s, soit 0.58 $ au prix horaire » ; repère Kontext sur un autre pod, même carte | — (test maison) |
| R2↑1↑2↑3↑4↑5↑6+2 | Qwen-Image et 2512 : 50 étapes, CFG 4, euler, simple, shift 3,1 ; négatif vide / négatif de l'éditeur ; Edit 2511 : 40 étapes, CFG 4, CFGNorm 1 ; Kontext dev : 20 étapes, CFG 1, guidance 2,5, fp8 ; 6 prompts du banc, graine 2210, 1152 × 1536, un tirage, sans LoRA ni réécriture de prompt ; 3 consignes de retouche sur une image FLUX.3 Klein du 23/10 | — (test maison) |
| R3↑1↑2↑3↑4↑5↑6+3 | Médianes hors première image : Qwen-Image 98,3 s (94,3 s de calcul), 0,0298 $ ; 2512 98,8 s (94,8 s), 0,0299 $ ; Edit 2511 106,1 s (101,6 s), 0,0322 $ (deux retouches) ; Kontext 16,7 s (16,7 et 16,6 s), 0,005 $ ; 15 images Qwen : 0,4674 $ (durée × prix horaire, hors installation et téléchargements) | — (test maison) |
| R4↑1↑2↑3↑4↑5↑6+8 | Relecture des 12 images du banc et des 7 images de retouche en pleine taille, 26/10/2026 (tenues, cadrages, nuit, cartes, « BONJOUR », manteau, soirée, carton) | — (test maison) |
| R5↑1↑2↑3 | Aucune image écartée ; recadrées : Qwen-Image b1 (haut sans bretelles), b3 (débardeur), b4 (bras nus) et les 7 retouches (bande de gauche, 650 px sur 880) ; objectifs floutés : Qwen-Image b2, b5, 2512 b5 | — (test maison) |
| R6↑1↑2↑3↑4↑5 | Tailles calculées : 57,70 Go (dépôts Diffusers de la 1re génération), 40,86 Go (modèle d'images BF16), 33,12 et 14,23 Go (2.1) ; 30,07 / 30,07 / 30,17 Go par variante testée, 71,03 Go les trois ; 26,14 Go (nvfp4 + encodeur nvfp4 + VAE) | — (calcul maison) |
| R7↑1↑2↑3↑4↑5↑6+1 | Pas testé : Edit, Edit 2509, Layered, 2.0, 2.1, 2.1 Turbo, PE-T2I, PE-I2I, Bench ; fichiers bf16, fp8mixed, fp8_hq, nvfp4, int8 ; réécriture de prompt ; LoRA Lightning ; plusieurs graines ; pic de mémoire ; texte long ou en idéogrammes | — (test maison) |
| R8↑ | Calculs maison (26/10/2026) : 1 000 × 0,0298 $ = 29,80 $ ; 1 000 × 98,3 s = 27 h 18 ; 1 000 × 0,0299 $ = 29,90 $ ; 1 000 × 98,8 s = 27 h 27 | — (calcul maison) |
Je ne crois pas une démo. Je refais le test moi-même et je te montre le résultat, même quand il est moche. Et ne me mets pas en colère, tu ne vas pas aimer la suite.