Z-Image ou Z-Image Turbo : lequel télécharger ? Le Turbo, sauf si tu veux entraîner
Lequel tu télécharges ? Z-Image et Z-Image Turbo ont le même nom, le même éditeur, le même poids sur le disque en bf16, et pourtant l'un rend son image plus de quatre fois plus vite que l'autre : 7,9 s contre 34,6 s. Alors je me pose la question comme toi : à quoi sert le plus lent ? J'ai sorti le chrono, la calculette et nos six photos du banc. Réponse courte : le Turbo. Réponse longue : ça dépend de ce que tu veux faire après.
Comparatif. Pages officielles relevées le 26/10/2026 ; nos tests du 25/10/2026 sur Runpod, les deux modèles sur la même NVIDIA L40S, à quelques minutes d'écart. Une réserve, dite plus bas : la base a tourné dans le réglage court de Comfy-Org, pas dans celui de l'éditeur.
 MilkyCelle qui teste · Image, vidéo et ComfyUI
Vérifié par une 2e IA
En bref
- Même carte, même pod : 7,9 s et 0,0024 $ par image pour le Turbo, 34,6 s et 0,0105 $ pour la base, modèle déjà chargé. Si tu génères 1 000 images, notre calcul : 2 h 12 et 2,40 $ contre 9 h 37 et 10,50 $.
- Le disque ne départage pas : 12,31 Go chacun en bf16 chez Comfy-Org, et ComfyUI prépare la même charge pour les deux ; le pic de mémoire, on ne l'a pas mesuré. Seul le Turbo existe en nvfp4, un fichier de 4,51 Go.
- Sur nos six photos : 2 points à 1 pour le Turbo, 3 égalités. Mais la base tournait en 25 étapes et sans prompt négatif, alors que l'éditeur conseille 28 à 50 étapes et un négatif : le match retour reste à faire.
Tu veux quoi, au juste ?
Prends le Turbo si :
- tu fais beaucoup d'images : 455 à l'heure chez nous, contre 104 pour la base ;
- tu veux du résultat sans réglage : 8 étapes, pas de guidage, pas de prompt négatif à écrire ;
- ta carte est modeste : l'éditeur annonce qu'il « fits comfortably within 16G VRAM consumer devices ». Pour la base, aucun chiffre propre : le blog de l'éditeur écrit « moins de 16 Go de VRAM » sans dire pour quelle version. Comfy-Org publie aussi un Turbo en nvfp4, plus léger, mais sa page ne dit pas sur quelle carte il tourne ;
- tu veux de la photo réaliste et du texte : c'est ce que l'éditeur lui attribue, et sur notre pancarte il écrit juste, comme la base d'ailleurs.
Prends la base si :
- tu veux entraîner un LoRA (un petit fichier d'appoint qui apprend un style ou un visage au modèle) : l'éditeur la présente comme « une bonne base pour l'entraînement LoRA » et coche « ❌ » pour le Turbo à la ligne « Fintunablity » ;
- tu veux piloter au prompt négatif : la base « Répond avec une haute fidélité au prompting négatif », le Turbo n'en a pas ;
- tu veux de la variété d'une graine à l'autre : l'éditeur la classe plus haut que le Turbo sur ce point, ce qu'on n'a pas pu vérifier.
Prends les deux si tu as la place : ils partagent l'encodeur de texte et le décodeur, donc le second ne coûte que 12,31 Go de plus, 33,00 Go en tout.
Le reste de la famille (les versions annoncées, la licence, le témoin d'une autre famille) est sur la page Z-Image, et les réglages complets sont dans la fiche.
Le match en chiffres
| Critère | Z-Image (base) | Z-Image Turbo |
|---|---|---|
| Ce que l'éditeur conseille | 28 à 50 étapes, CFG 3 à 5, prompt négatif « Strongly recommended » | 8 passages du modèle, guidage à 0 |
| Nos réglages (modèles Comfy-Org) | 25 étapes, CFG 4, négatif vide | 8 étapes, CFG 1, négatif mis à zéro |
| Temps par image, modèle chargé | 34,6 s, dont 30,9 s de calcul | 7,9 s, dont 6,0 s de calcul |
| Première image, chargement compris | 50,8 s | 24,6 s |
| Prix par image (L40S à 1,09 $/h) | 0,0105 $ | 0,0024 $ |
| Si tu génères 1 000 images (notre calcul) | 9 h 37, 10,50 $ | 2 h 12, 2,40 $ |
| Fichier Comfy-Org, bf16 | 12,31 Go | 12,31 Go |
| Le plus léger chez Comfy-Org | int8, 6,20 Go | nvfp4, 4,51 Go |
| Dépôt de l'éditeur, modèle d'images | 12,31 Go en BF16 | 24,62 Go en F32 |
| Mémoire préparée par ComfyUI (modèle d'images, pas un pic) | 11 738 Mo | 11 738 Mo |
| Mémoire annoncée par l'éditeur | aucun chiffre propre ; blog : « less than 16GB », version non précisée | « 16G VRAM » |
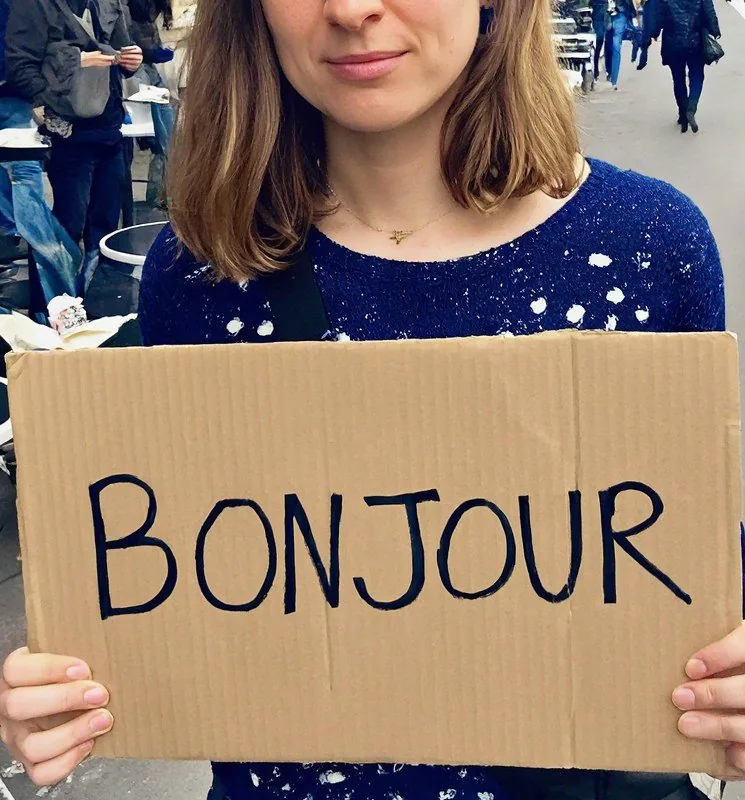
| Pancarte « BONJOUR » | juste | juste, plus un smartphone non demandé |
Prix : notre calcul, durée de chaque image × prix horaire de la carte, hors installation et téléchargement. Médianes sur cinq images, la première à part. Un tirage par prompt.
D'où vient l'écart de vitesse. Le guidage (CFG) mélange, à chaque étape, deux prédictions du modèle : une avec ton prompt, une sans (dans ComfyUI, c'est le prompt négatif, vide chez nous). C'est le principe de l'article de recherche qui l'a introduit, qui combine « les estimations résultantes des scores conditionnel et inconditionnel ». Le code de ComfyUI fait exactement ça : dès que le CFG n'est pas à 1, il calcule les deux prédictions ; à 1 pile, il saute la seconde. La base, à CFG 4, en calcule donc deux par étape ; le Turbo, à CFG 1, une seule. Sur le papier, 25 × 2 = 50 contre 8, soit 6,25 fois plus de travail ; on a mesuré 5,2 fois plus de temps de calcul, 30,9 s contre 6,0 s. Le journal ne compte pas les prédictions, donc le 6,25 reste un calcul et le 5,2 une mesure. Et la base dans le réglage de l'éditeur, jusqu'à 50 étapes, on ne l'a pas chronométrée.
Le piège du fichier de l'éditeur. Sur Hugging Face, chez Tongyi-MAI, le Turbo est rangé en 32 bits : 24,62 Go pour le seul modèle d'images, deux fois les 12,31 Go de la base, alors que les deux ont le même nombre de paramètres, 6 154 908 736. Si tu passes par ComfyUI, prends les fichiers Comfy-Org, « Fichiers de modèle réempaquetés pour ComfyUI » : 12,31 Go chacun, et ce sont eux que chargent ses modèles de workflow.
Photo par photo
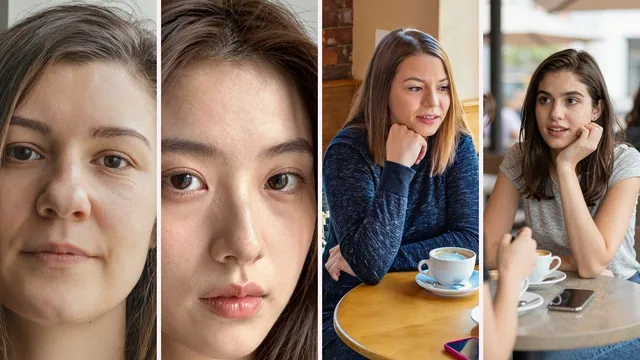
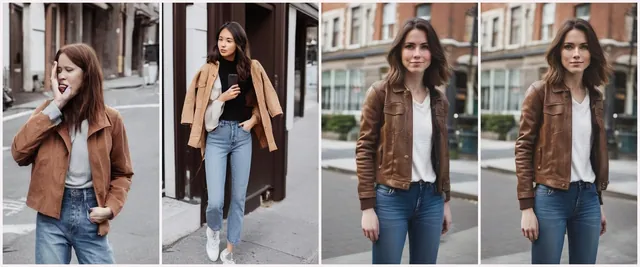
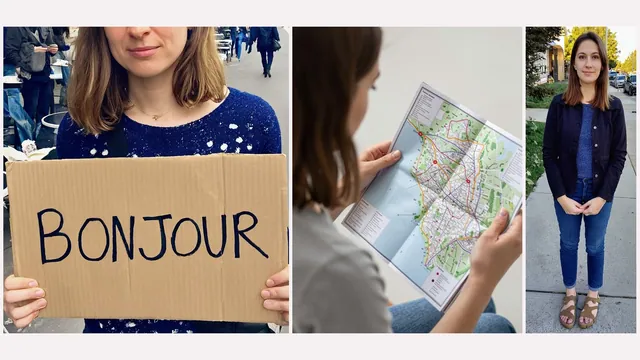
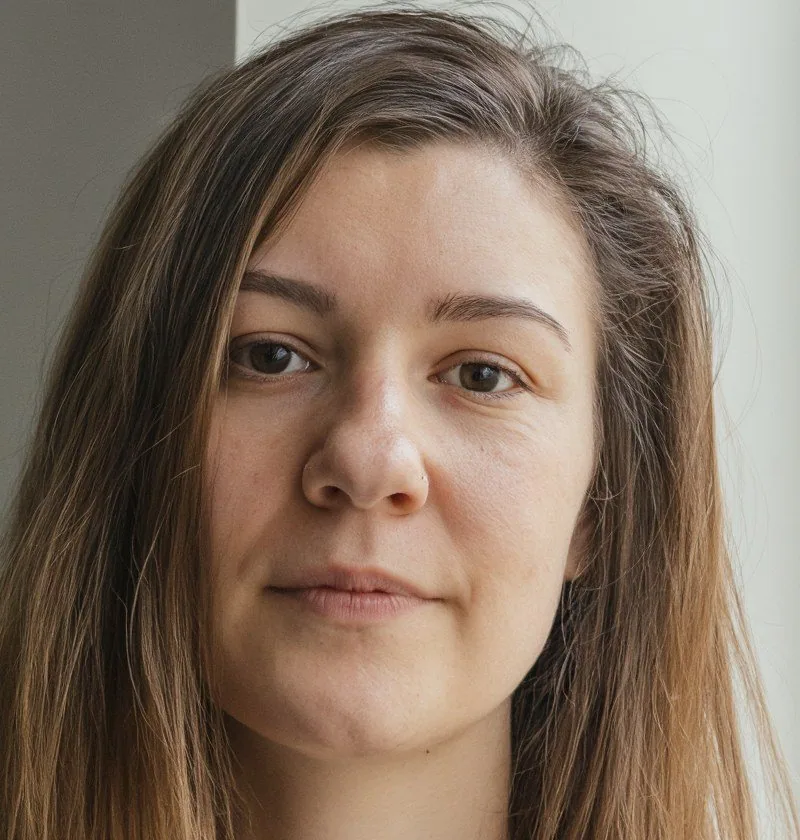
- Portrait : égalité dans l'oubli : aucun des deux n'habille la dame, que le prompt ne décrivait pas.
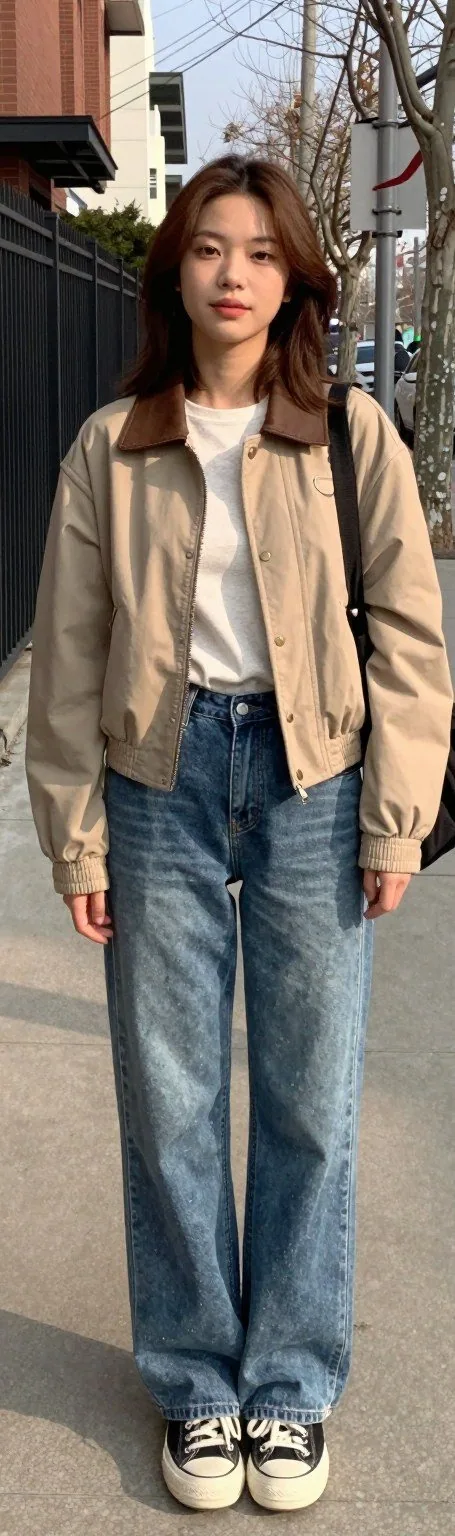
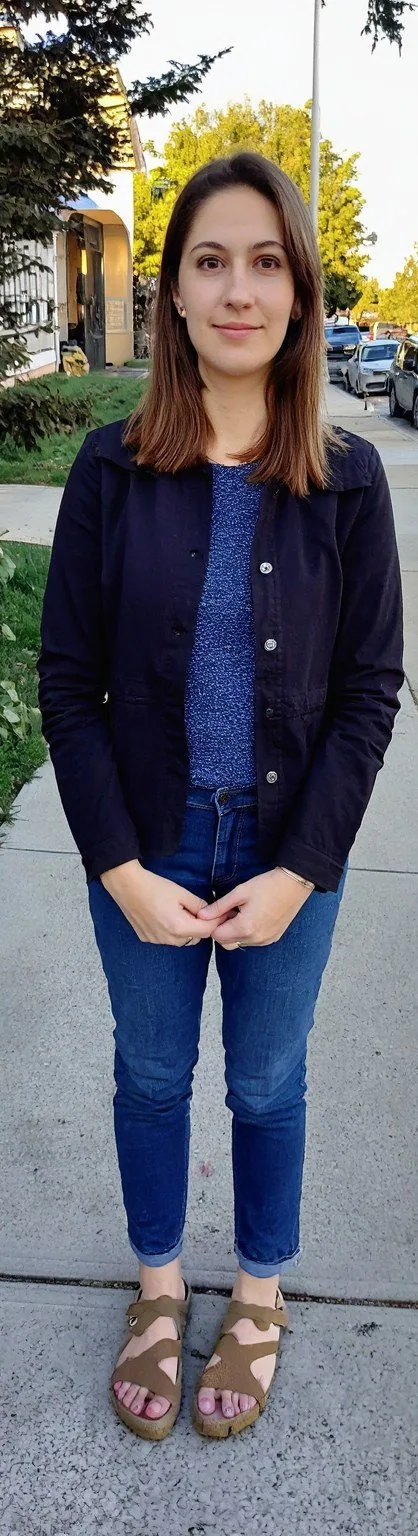
- En pied : égalité.
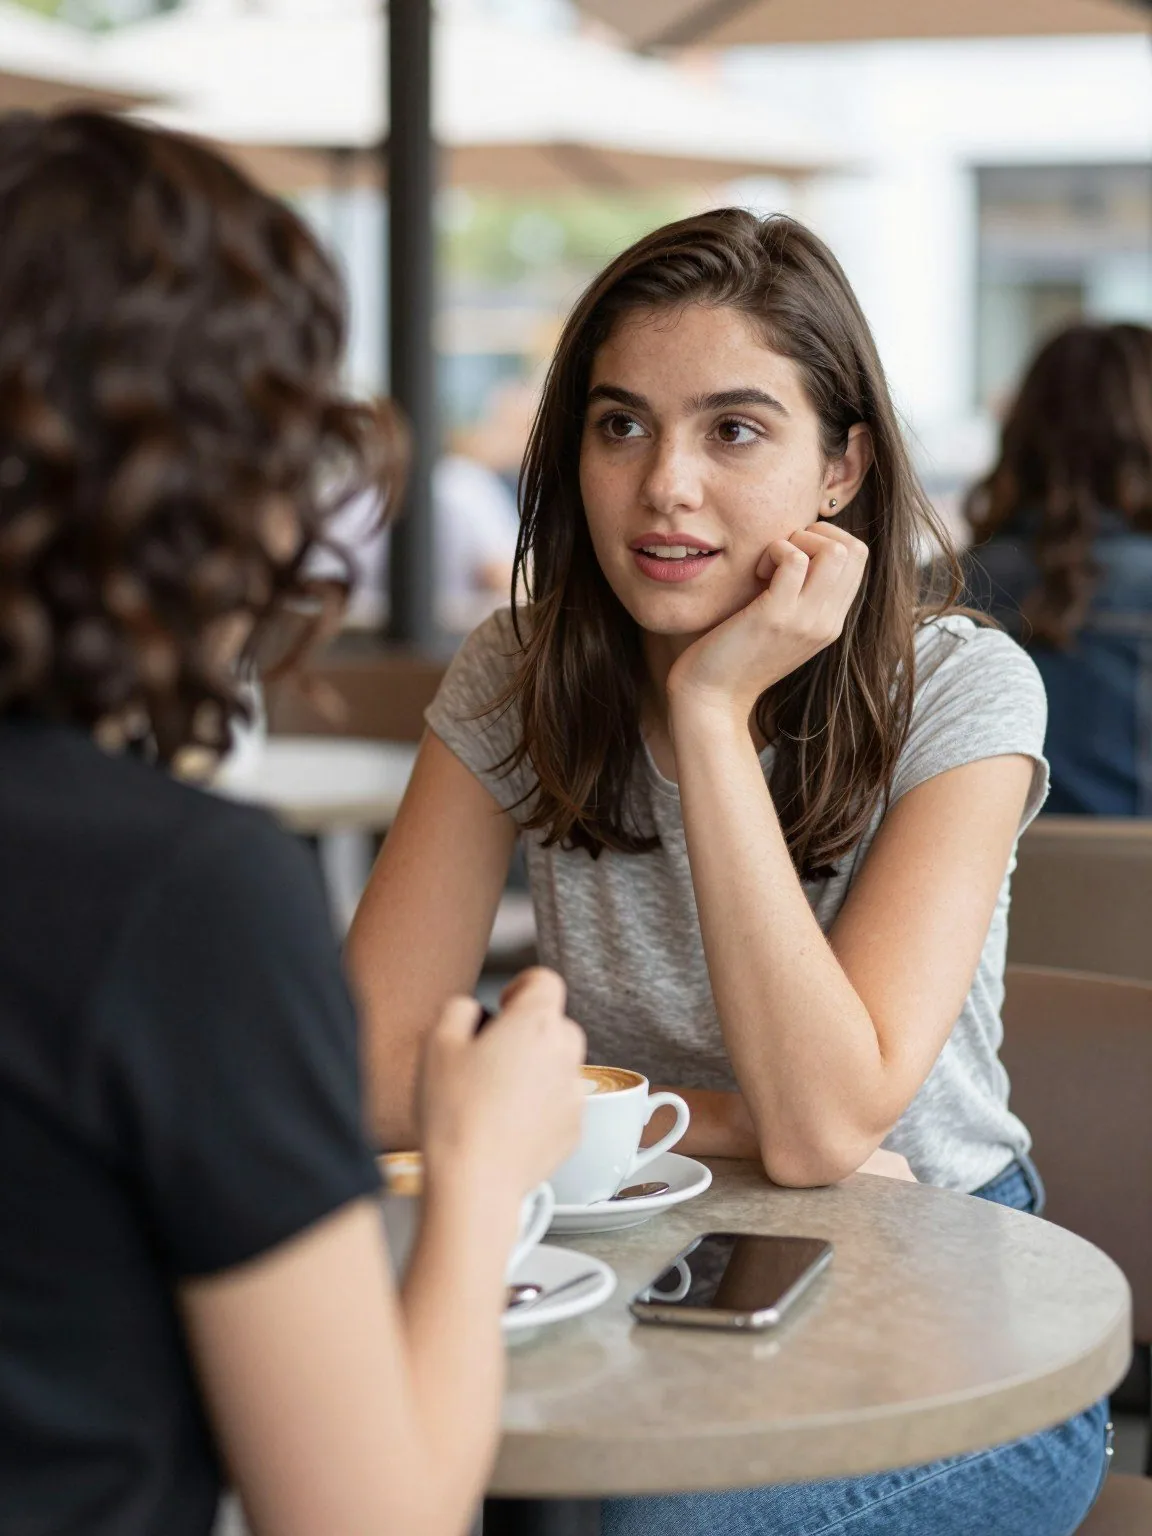
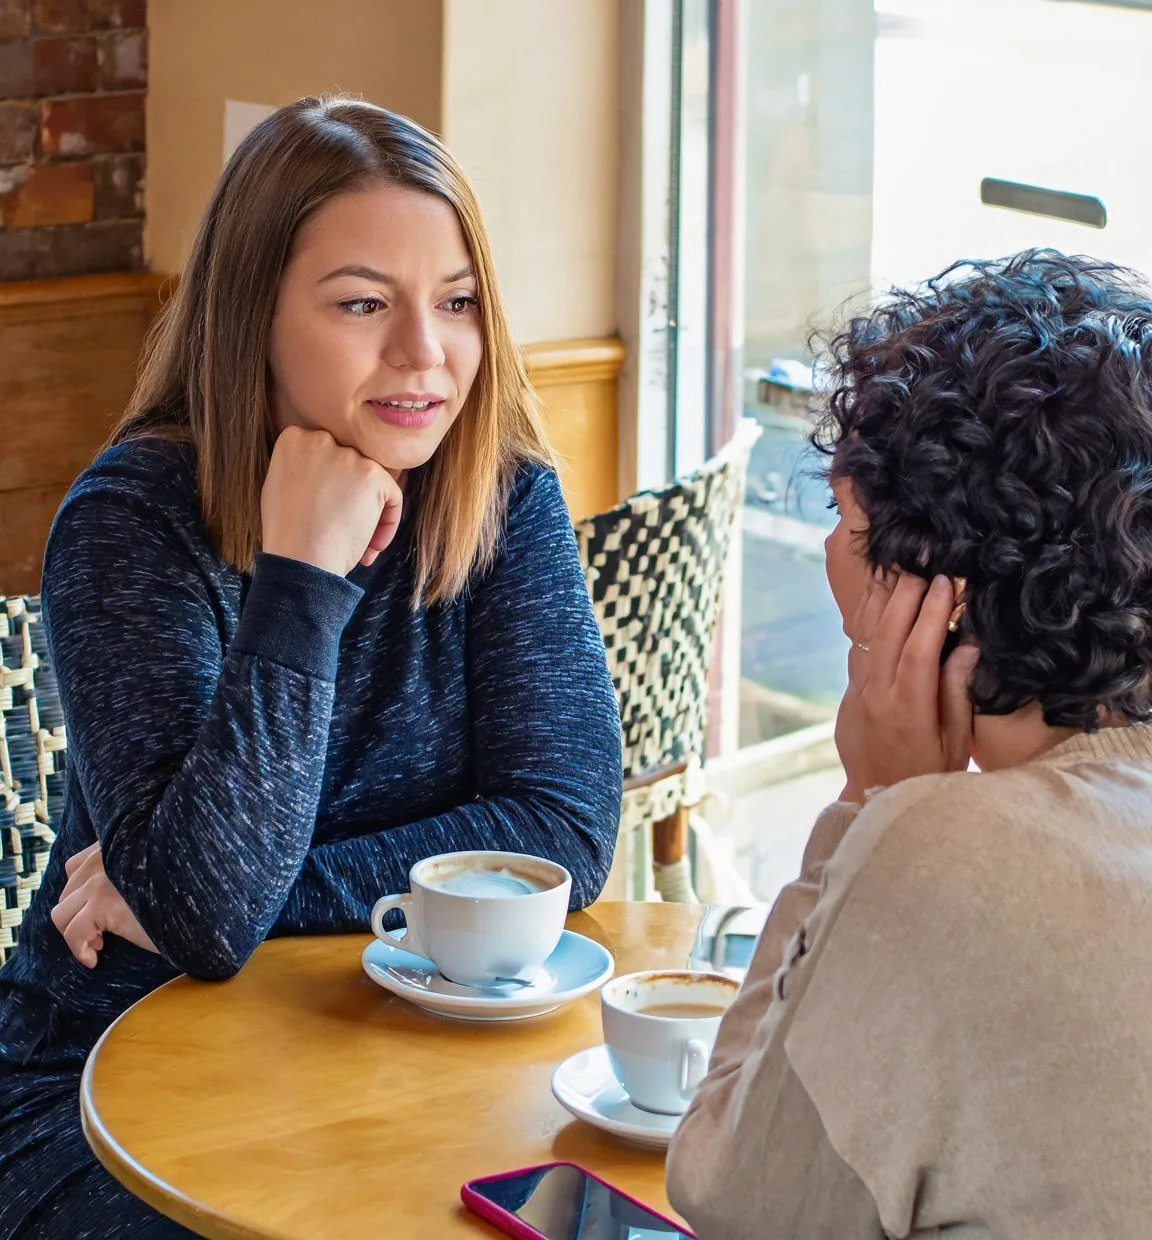
- Deux personnes au café : point à la base, la seule à respecter les cheveux courts de l'amie.
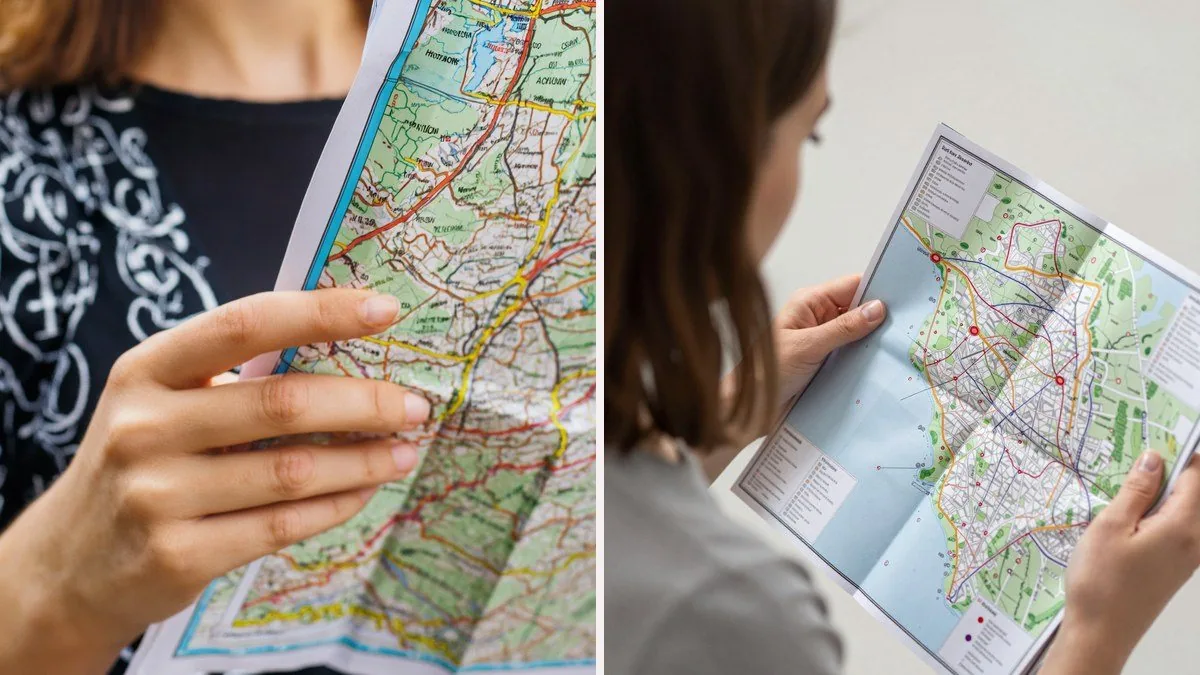
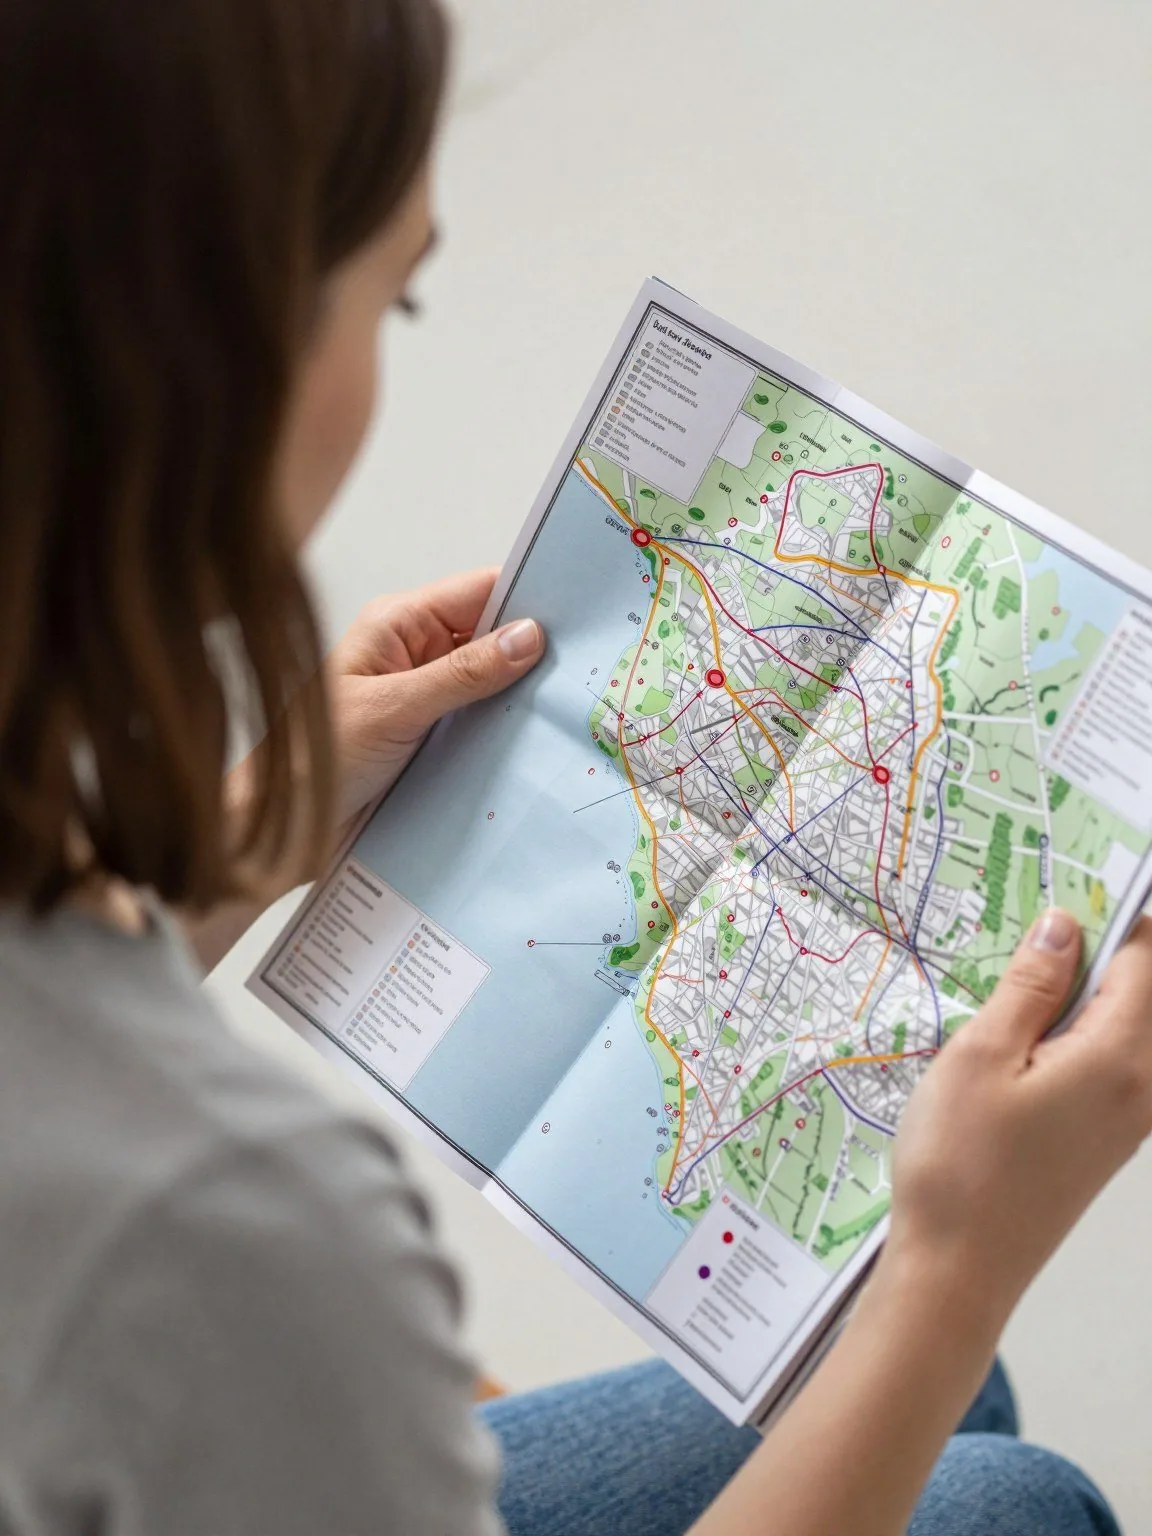
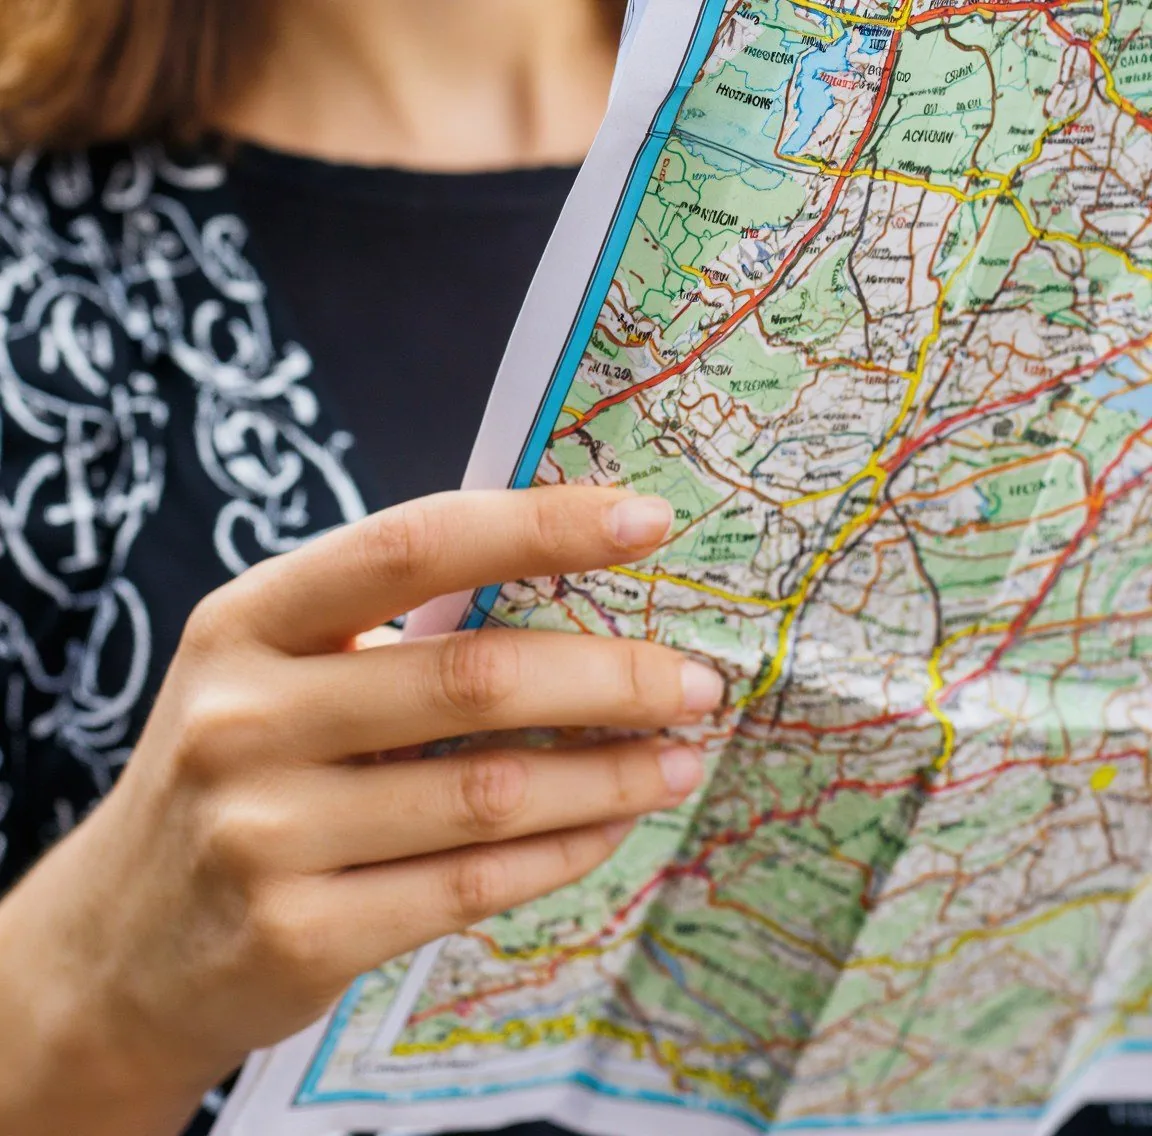
- Les deux mains sur une carte : point au Turbo.
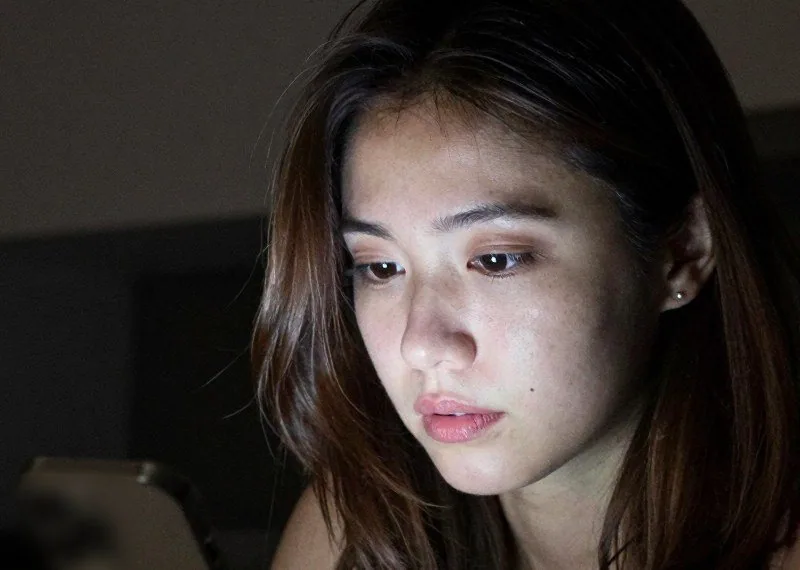
- La nuit, visage éclairé par le téléphone : point au Turbo, le seul à le faire ; l'image de la base est écartée pour la tenue.
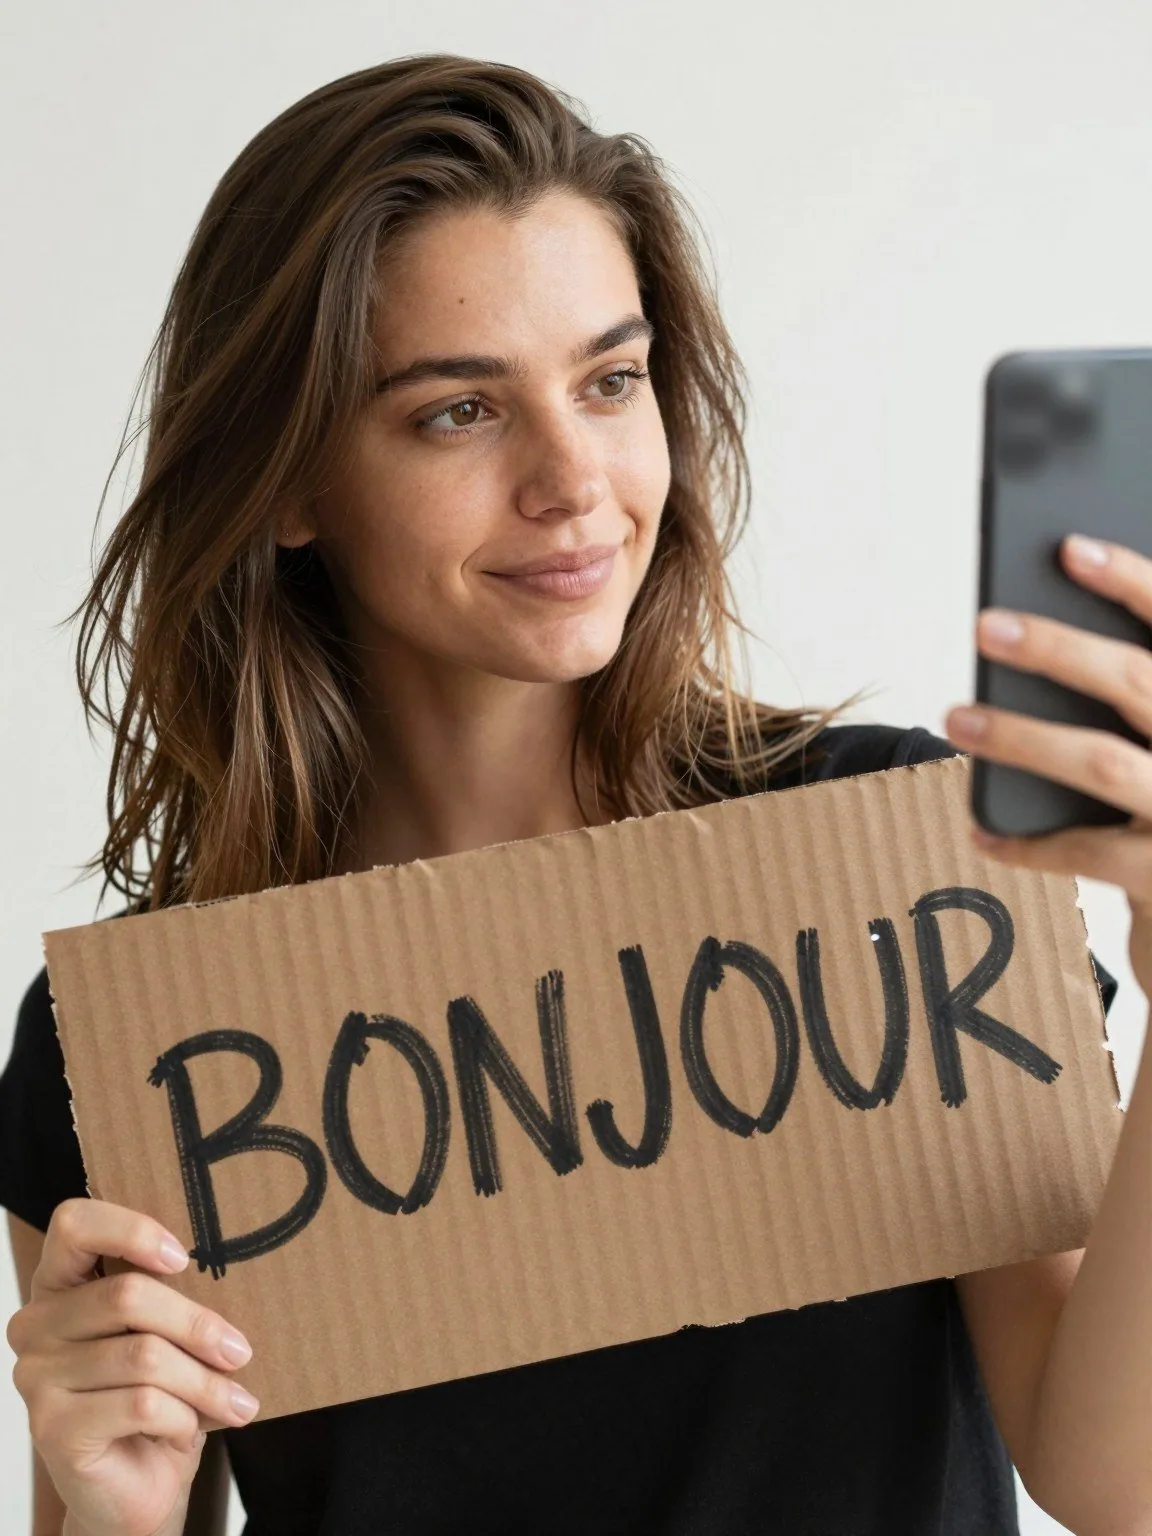
- Le texte : égalité.
Score sur nos six photos : 2 à 1 pour le Turbo, 3 égalités, avec une base en réglage court. Un tirage par photo : une case peut tenir de la chance. Le détail de chaque image est dans la galerie.
La galerie
Z-Image contre Z-Image Turbo, photo par photo
Même pod Runpod (lien parrainé), même NVIDIA L40S (1,09 $/h), même jour (25/10/2026), ComfyUI 0.42.0, graine 2210, 1152 × 1536, un tirage par prompt, aucun LoRA. Turbo : 8 étapes, CFG 1. Base : 25 étapes, CFG 4, sans prompt négatif (réglage Comfy-Org, plus court que celui de l'éditeur). Temps par image, de l'envoi à l'image rendue ; prix = notre calcul. Recadrages, flous et image écartée : dit sous chaque image.
Z-Image Turbo 8 étapes · CFG 1 · médiane 7,9 s · 0,0024 $
Portrait
Égalité dans l'oubli : pas de vêtement visible. Peau plus lisse que la base.
En pied
Égalité : en pied tous les deux.
Deux personnages
Point à la base : ici, l'amie a des boucles mi-longues au lieu de courtes.
Mains et objet
Point au Turbo : les deux mains tiennent la carte.
Nuit
Point au Turbo : le visage est éclairé par l'écran.
Texte dans l'image
Égalité : « BONJOUR » juste. Bonus non demandé : un smartphone.
Z-Image (base) 25 étapes · CFG 4 · médiane 34,6 s · 0,0105 $
Portrait
Pas de vêtement visible non plus ; peau de photo de téléphone.
En pied
En pied, sandales comprises.
Deux personnages
Point à la base : amie aux cheveux courts et bouclés, deux tasses.
Mains et objet
Raté : une seule main.
Nuit
Image écartée à notre relecture (tenue). Elle regardait l'objectif, le téléphone tout en bas du cadre.
Texte dans l'image
« BONJOUR » juste, rien d'autre.
Une image n'est pas montrée : la base de nuit, pour la tenue. Huit sont recadrées (épaules nues, débardeur, robe courte, façades, voitures, et le haut d'une carte où un mot inventé pouvait se lire comme un nom de lieu réel), et deux téléphones ont l'objectif légèrement flouté. C'est dit sous chaque image.
Les réglages : là où on se trompe
- Ne donne pas de guidage au Turbo. L'éditeur écrit « Le Guidance devrait être à 0 pour les modèles Turbo ». Dans ComfyUI, le modèle de workflow Comfy-Org règle le CFG à 1 et passe le négatif dans un nœud « ConditioningZeroOut ». C'est la même consigne, écrite deux fois différemment : dans la formule de ComfyUI, un CFG de 1 ne garde que la prédiction avec le prompt ; dans celle du code Diffusers de Z-Image, c'est un guidage de 0 qui fait ça. Un prompt négatif au Turbo, c'est du texte perdu.
- Dans le code de l'éditeur, 9 étapes, c'est 8 passages. L'exemple Diffusers du Turbo écrit « num_inference_steps=9, # Cela aboutit en réalité à 8 passes forward du DiT ».
- La base veut plus que ce qu'on lui a donné. Le modèle Comfy-Org part sur 25 étapes et un négatif vide. L'éditeur conseille 28 à 50 étapes, un CFG de 3 à 5, et un prompt négatif « Vivement recommandé pour un meilleur contrôle » ; pour la photo, il conseille aussi la normalisation CFG («
Truepour le réalisme »). Nos images de la base sont donc un réglage court : si tu la choisis, monte les étapes et écris un négatif, puis compare toi-même.
Ce que l'éditeur promet à la base, et ce qu'on a vu
Les arguments de la base sont tous tournés vers l'après : « Conçu pour le développement », bonne base pour les LoRA, les ControlNet et le « semantic conditioning », et une variété plus grande d'une graine à l'autre. Le Turbo, lui, est classé « Very High » en qualité visuelle, la base « High ». Ce sont leurs tableaux, pas nos mesures.
Ce qu'on peut dire : sur nos six photos, la base ne bat pas le Turbo en réglage court, sauf au café. Et nos propres LoRA de visages ont été entraînés sur le Turbo, avec l'entraîneur de fal, pas sur la base : l'histoire est dans la fiche. Un LoRA sur la base, on ne l'a pas encore fait.
La licence ne départage pas : Apache 2.0 pour les deux, déclarée dans leurs fiches, avec le texte complet sur le GitHub de l'éditeur.
Ce qu'on n'a pas testé
La base en 28 à 50 étapes avec un prompt négatif ; les fichiers int8 et nvfp4 ; plusieurs graines ; le pic de mémoire et une carte de 16 Go ; un LoRA entraîné sur la base ; le texte chinois.
L'avis de Milky
Je télécharge le Turbo. Plus de quatre fois plus rapide, plus de quatre fois moins cher (7,9 s et 0,0024 $ l'image contre 34,6 s et 0,0105 $ ; 2,40 $ contre 10,50 $ si tu génères 1 000 images), le même poids sur le disque en bf16, et sur notre banc il fait mieux là où ça se voit, les mains et la nuit, face à une base en réglage court. La base, je la garde en deuxième fichier, pour 12,31 Go de plus : c'est elle qu'on m'envoie quand je voudrai entraîner, ou tenir un prompt négatif. Et je lui dois un match retour en 50 étapes, avec son négatif, parce que la battre en réglage court, ce n'est pas glorieux. Réponse à ta question : le plus lent sert à ceux qui veulent apprendre quelque chose au modèle, pas à ceux qui pressent.
Ce qu'on ne sait pas encore
- Combien de temps prend la base dans le réglage de l'éditeur, et si elle rattrape le Turbo sur les mains.
- La mémoire vraiment prise par chacun, et si 16 Go suffisent pour la base.
- Ce que les fichiers allégés changent à l'image.
- Si la variété annoncée pour la base se voit sur plusieurs graines.
Les mots à retenir
- Passage du modèle (NFE) : « Nombre d'évaluations de la fonction », le nombre de fois où le modèle calcule pendant une image ; 8 pour le Turbo selon l'éditeur.
- Guidage (CFG) : deux prédictions par étape, avec et sans le prompt, que le réglage écarte l'une de l'autre ; la base l'utilise, pas le Turbo.
- Prompt négatif : la liste de ce que tu refuses sur l'image ; seule la base en tient compte.
- Médiane : la valeur du milieu quand on range les temps du plus court au plus long ; ici, sur cinq images.
- bf16, F32, int8, nvfp4 : la façon de ranger les nombres du modèle ; moins de chiffres, fichier plus léger.
- LoRA : un petit fichier ajouté à un modèle pour lui apprendre un visage ou un style.
Tous nos mots expliqués : le glossaire →
Passages sources
Afficher les 21 sources
| Réf. | Citation (langue originale) | URL |
|---|---|---|
| S1↑1↑2↑3↑4↑5↑6+4 | "license: apache-2.0" ; "Z-Image-Turbo – A distilled version of Z-Image that matches or exceeds leading competitors with only 8 NFEs (Number of Function Evaluations). It offers ⚡️sub-second inference latency⚡️ on enterprise-grade H800 GPUs and fits comfortably within 16G VRAM consumer devices. It excels in photorealistic image generation, bilingual text rendering (English & Chinese), and robust instruction adherence." ; "num_inference_steps=9, # This actually results in 8 DiT forwards" ; "guidance_scale=0.0, # Guidance should be 0 for the Turbo models" | https://huggingface.co/Tongyi-MAI/Z-Image-Turbo |
| S2↑1↑2↑3 | API, 26/10/2026 : "parameters":{"F32":6154908736} ; transformer : 9973693184 + 9973714824 + 4672282880 octets | https://huggingface.co/api/models/Tongyi-MAI/Z-Image-Turbo |
| S3↑1↑2↑3↑4↑5↑6+8 | "license: apache-2.0" ; "Z-Image is a full-capacity, undistilled transformer" ; "Built for Development: The ideal starting point for the community. Its non-distilled nature makes it a good base for LoRA training, structural conditioning (ControlNet) and semantic conditioning." ; "Robust Negative Control: Responds with high fidelity to negative prompting" ; "Steps | 28~50 | 8" ; "Fintunablity | ✅ | ❌" ; "Negative Prompting | ✅ | ❌" ; "Diversity | High | Low" ; "Visual Quality | High | Very High" ; "Guidance scale: 3.0 – 5.0" ; "Inference steps: 28 – 50" | https://huggingface.co/Tongyi-MAI/Z-Image |
| S4↑1↑2 | API, 26/10/2026 : "parameters":{"BF16":6154908736} ; transformer : 9973727144 + 2336146728 octets | https://huggingface.co/api/models/Tongyi-MAI/Z-Image |
| S5↑1↑2↑3↑4 | "Negative prompts: Strongly recommended for better control" ; "CFG normalization: False for general stylism, True for realism" ; tableau : "Z-Image | … | High | Medium | Easy" ; "Z-Image-Turbo | … | Very High | Low | N/A" | https://github.com/Tongyi-MAI/Z-Image |
| S6↑1↑2↑3↑4↑5↑6+2 | "Repackaged model files for ComfyUI." ; "Original model repository: https://huggingface.co/Tongyi-MAI/Z-Image-Turbo" ; z_image_turbo_bf16 12309866400 octets ; z_image_turbo_int8_convrot 6201001296 ; z_image_turbo_nvfp4 4509509600 | https://huggingface.co/Comfy-Org/z_image_turbo |
| S7↑1↑2↑3↑4↑5 | "Repackaged model files for ComfyUI." ; "Original model repository: https://huggingface.co/Tongyi-MAI/Z-Image" ; z_image_bf16 12309866400 octets ; z_image_int8_convrot 6201001296 (pas de nvfp4) | https://huggingface.co/Comfy-Org/z_image |
| S8↑1↑2↑3↑4↑5↑6 | Modèles de workflow Comfy-Org, 26/10/2026 : Turbo, KSampler [… 8, 1, "res_multistep", "simple" …] et nœud "ConditioningZeroOut" ; base, KSampler [… 25, 4, "res_multistep", "simple" …], négatif "" | https://github.com/Comfy-Org/workflow_templates |
| S9↑ | "Apache License Version 2.0, January 2004" | https://github.com/Tongyi-MAI/Z-Image/blob/main/LICENSE |
| S10↑ | Jonathan Ho, Tim Salimans, « Classifier-Free Diffusion Guidance », 26/07/2022 : "we jointly train a conditional and an unconditional diffusion model, and we combine the resulting conditional and unconditional score estimates" | https://arxiv.org/abs/2207.12598 |
| S11↑1↑2↑3↑4 | Code de ComfyUI, comfy/samplers.py, relevé le 26/10/2026 : "if math.isclose(cond_scale, 1.0) and model_options.get("disable_cfg1_optimization", False) == False: uncond_ = None" ; "conds = [cond, uncond_]" ; "cfg_result = uncond_pred + (cond_pred - uncond_pred) * cond_scale" | https://github.com/comfyanonymous/ComfyUI/blob/master/comfy/samplers.py |
| S12↑ | Code Diffusers de Z-Image, pipeline_z_image.py, relevé le 26/10/2026 : "return self._guidance_scale > 0" ; "latent_model_input = latents_typed.repeat(2, 1, 1, 1)" ; "pred = pos + current_guidance_scale * (pos - neg)" | https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/z_image/pipeline_z_image.py |
| S13↑1↑2 | Blog de l'éditeur : "It can run smoothly on consumer-grade graphics cards with less than 16GB of VRAM" | https://tongyi-mai.github.io/Z-Image-blog/ |
| R1↑1↑2↑3↑4 | Même pod Runpod, NVIDIA L40S à 1,09 $/h, ComfyUI 0.42.0, 25/10/2026 : Turbo puis base, à la suite ; journal : « Lumina2 … 11738MB Staged » pour les deux ; pic non mesuré | — (test maison) |
| R2↑1↑2↑3↑4↑5↑6+2 | Turbo 8 étapes, CFG 1, négatif à zéro ; base 25 étapes, CFG 4, négatif vide ; 6 prompts du banc, graine 2210, 1152 × 1536, un tirage, sans LoRA | — (test maison) |
| R3↑1↑2↑3↑4↑5↑6+6 | Médianes hors première image : Turbo 7,9 s (6,0 s de calcul), 0,0024 $ ; base 34,6 s (30,9 s), 0,0105 $ ; premières images 24,6 s et 50,8 s ; base b4 33,9 s, 0,0103 $ ; rapports 4,4 et 5,2 | — (test maison) |
| R4↑1↑2↑3↑4↑5↑6+7 | Relecture des 12 images : portraits sans vêtement visible ; en pied tous deux ; café : amie aux cheveux courts chez la base, mi-longs chez le Turbo ; base b4 une seule main ; Turbo b5 visage éclairé par l'écran ; « BONJOUR » juste chez les deux, smartphone en plus chez le Turbo | — (test maison) |
| R5↑1↑2↑3↑4 | 1 image écartée (base b5), 8 recadrées, 2 téléphones floutés | — (test maison) |
| R6↑1↑2↑3↑4↑5↑6+4 | 1 000 images : 2 h 12, 2,40 $ (Turbo) ; 9 h 37, 10,50 $ (base), d'après les médianes arrondies ; 455 et 104 images complètes à l'heure ; 50 contre 8 prédictions sur le papier (6,25), contre 5,2 mesuré sur le temps de calcul ; 20,69 Go pour un modèle, 33,00 Go pour les deux ; modèle d'images de l'éditeur 24,62 Go (Turbo, F32) et 12,31 Go (base, BF16) | — (calcul maison) |
| R7↑ | Nos LoRA Z-Image : entraînés sur le Turbo, chez fal (« Train LoRAs on Z-Image Turbo »), aucun sur la base | https://siliciumrose.fr/articles/z-image.html |
| R8↑1↑2↑3↑4 | Pas testé : base en 28 à 50 étapes avec négatif et normalisation CFG ; int8, nvfp4 ; plusieurs graines ; pic de mémoire ; carte de 16 Go ; LoRA sur la base ; texte chinois | — (test maison) |
Je ne crois pas une démo. Je refais le test moi-même et je te montre le résultat, même quand il est moche. Et ne me mets pas en colère, tu ne vas pas aimer la suite.