NVIDIA recompresse DeepSeek, le monteur de Tencent ne filme rien
NVIDIA a passé DeepSeek en 4 bits. Ses experts y étaient déjà : 75 Gio de gagnés, des scores quasi inchangés. Le « monteur vidéo » de Tencent, lui, ne fabrique aucune image : il pilote des outils.
Analyse. Dépôt NVIDIA du 30/10/2026 ; fiche Tencent retouchée le 30/10, papier du 28/10. Relus à froid le 01/11/2026 vers 17:50 UTC. Rien lancé, rien dépensé.
 MilkyCelle qui teste · Image, vidéo et ComfyUI
Vérifié par une 2e IA
En bref
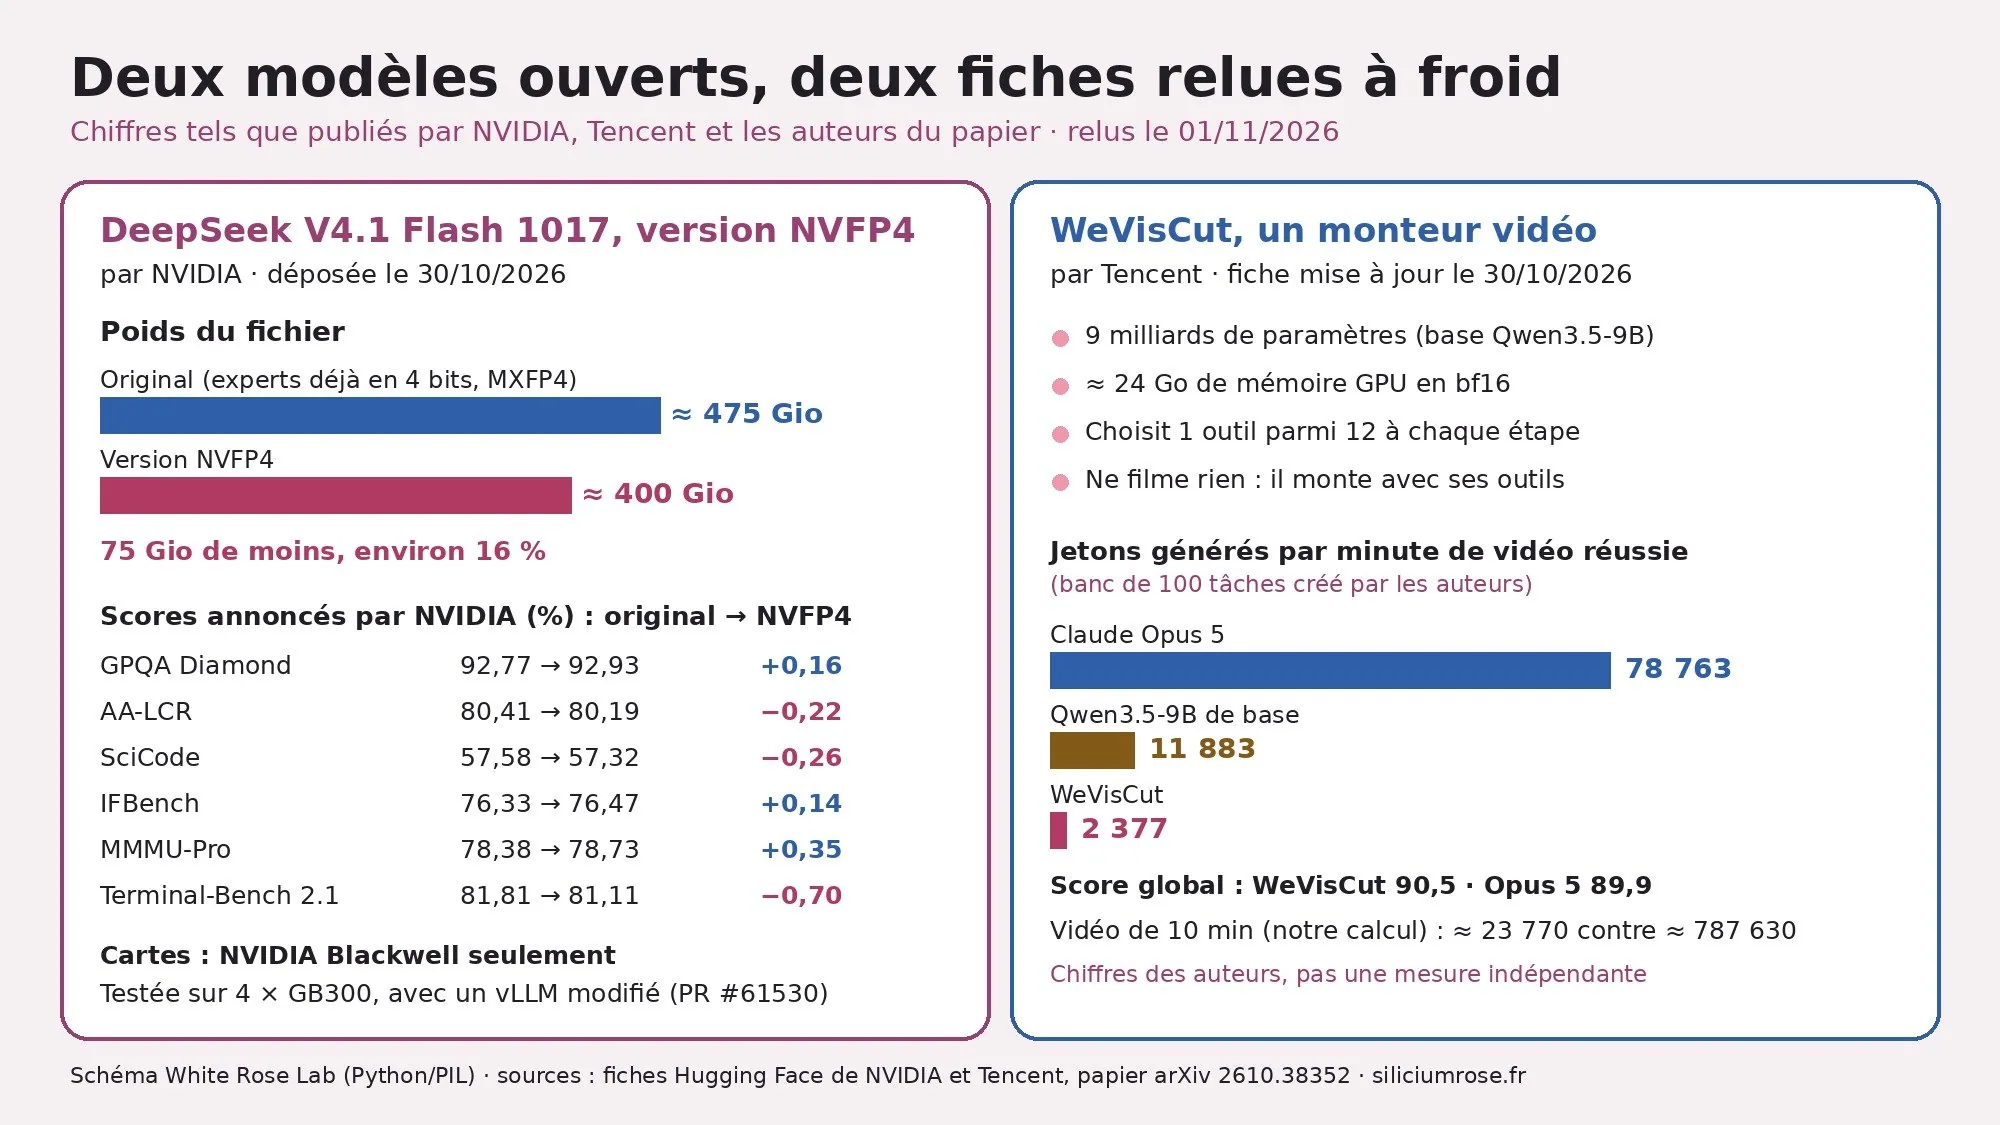
- NVIDIA republie DeepSeek V4.1 Flash 1017 en NVFP4 : environ 400 Gio contre 475, pour cartes Blackwell seulement.
- Sur ses six tests, l'écart avec l'original ne dépasse pas 0,70 point.
- WeVisCut transforme un article ou un script en vidéo montée de plusieurs minutes, en appelant des outils ; ce n'est pas un modèle texte-vers-vidéo.
NVIDIA : du 4 bits au 4 bits
L'original est « en précision mixte », experts déjà en MXFP4, un format 4 bits. NVIDIA change donc de format :
- Les experts (384, sur 40 couches) passent de MXFP4 à NVFP4, poids et activations.
- Les tables « Engram » passent de FP8 à MXFP4. Cette conversion-là perd de l'information, dit NVIDIA.
- Le reste (attention, vision, experts partagés…) garde sa précision d'origine.
Conversion des experts « sans perte », mais pas forcément des réponses identiques, précise NVIDIA. Honnête. Rare.
Le gain : 75 Gio de moins, à peu près 16 %. Pas de quoi le faire tenir sur ta carte de jeu.
Pour le faire tourner :
- des cartes NVIDIA Blackwell, seule famille listée ;
- un vLLM avec une modification précise (la « pull request » n° 61530), car les images vLLM standard ne savent pas lire ces tables. Au 01/11 vers 17:56 UTC, elle n'était pas encore fusionnée dans vLLM ;
- NVIDIA l'a testé sur quatre GB300 ; SGLang n'a pas été validé.
Plus gros recul : Terminal-Bench 2.1, 81,81 % contre 81,11 %. Licence MIT, usage commercial autorisé. Au 01/11 vers 17:50 UTC : 1 473 téléchargements et 114 likes.
Tencent : un monteur qui ne filme rien
WeVisCut transforme un article ou un script en vidéo montée. À chaque étape, il lit l'état du montage et choisit un outil parmi 12 :
- découper l'article, planifier les plans, générer la voix off ;
- chercher des séquences (par défaut, sur le web ouvert) et la musique ;
- remplir des gabarits animés ;
- juger, corriger, assembler.
Sans ses outils, aucune vidéo ; et la qualité dépend des services branchés (recherche, voix, rendu). Le 9B, c'est le chef de plateau. Pas la caméra.
Côté machine : un GPU NVIDIA d'environ 24 Go en bf16. Le fichier principal pèse environ 18,8 Go.
Pas une sortie du 30/10 : dépôt et poids datent des 09-10/09/2026, seule la fiche a bougé depuis (dernière retouche le 30/10). Le papier date du 28/10. Date du passage en public : pas dite.
Les chiffres du papier, sur un banc de 100 tâches créé par les mêmes auteurs :
- score global 90,5 pour WeVisCut, 89,9 pour Claude Opus 5 ;
- 2 377 jetons générés par minute de vidéo réussie, contre 78 763 pour Opus 5.
À ce rythme, pour 10 minutes de vidéo : environ 23 770 jetons contre 787 630 (notre calcul). Leur banc, leurs règles, leur victoire.
Quand les sources se contredisent
- La licence de WeVisCut : la fiche Hugging Face affiche « other » ; le code est sous Apache 2.0, et les poids « soumis à leurs propres conditions », sans les nommer.
Ce que disent les mesures indépendantes
Artificial Analysis n'a rien sur le NVFP4 ni sur WeVisCut (01/11, 17:52 UTC), mais a mesuré l'original (effort max) :
- AA-LCR : 82,7 %, contre 80,41 % chez NVIDIA ;
- SciCode : 55,9 %, contre 57,58 % ;
- MMMU-Pro : 80,6 %, contre 78,38 %.
Écarts de 1,7 à 2,3 points, dans les deux sens. Protocoles différents : ça ne dit rien du NVFP4, seulement que les chiffres de NVIDIA pour l'original restent dans les mêmes eaux.
Ce qu'on ne sait pas encore
- La vitesse : NVIDIA ne donne aucun chiffre de débit ni de latence pour le NVFP4.
- La qualité des vidéos de WeVisCut : je n'en ai regardé aucune. Ne me mets pas en colère avec « c'est bluffant » sans lien.
Les mots à retenir
- Quantification : stocker les nombres d'un modèle sur moins de bits, pour qu'il prenne moins de place.
- NVFP4 : format de nombres sur 4 bits de NVIDIA ; ici appliqué aux poids et aux activations des experts, par groupes de 16 valeurs.
- MXFP4 : un autre format 4 bits, celui des experts de l'original.
- Agent à outils : un modèle qui décide quel programme appeler, et dans quel ordre, au lieu de faire le travail lui-même.
Tous nos mots expliqués : le glossaire →
Passages sources
Pages relevées le 01/11/2026 entre 17:50 et 17:53 UTC (S7 à 17:56 UTC).
Afficher les 10 sources
| Réf. | Citation (langue originale) | URL |
|---|---|---|
| S1↑1↑2↑3↑4↑5↑6+7 | "The NVIDIA DeepSeek-V4.1-Flash-1017 NVFP4 model is the quantized version of DeepSeek AI's DeepSeek-V4.1-Flash-1017 model" ; "This model is ready for commercial or non-commercial use." ; "Release Date: Hugging Face 10/30/2026" ; "This checkpoint stores the Engram lookup tables as MXFP4, which stock vLLM images cannot load. Use a vLLM build that includes the pull request above." ; "SGLang has not been validated with this checkpoint." ; "Supported Hardware Microarchitecture Compatibility: NVIDIA Blackwell" ; "This model converts the ordinary routed MoE experts from source MXFP4 to NVFP4 weights and activations (W4A4), with group size 16. The converted projections are w1, w2, and w3 for 384 experts across 40 layers. The Engram lookup tables are converted from the source FP8 to MXFP4. Attention, shared experts, vision, MTP, and other excluded components retain their source precision" ; "All 16,986,931,200 expert weight blocks passed lossless conversion […]; the Engram conversion is lossy." ; "Lossless weight conversion does not imply identical inference outputs." ; "The checkpoint is approximately 400 GiB (source: approximately 475 GiB) in 48 safetensors shards." ; "the one used for the reported results on four GB300 GPUs" ; tableau : MXFP4 (source) 92.77 / 80.41 / 57.58 / 76.33 / 78.38 / 81.81 ; NVFP4 + MXFP4 Engram 92.93 / 80.19 / 57.32 / 76.47 / 78.73 / 81.11 ; "Baseline: DeepSeek-V4.1-Flash-1017, a mixed-precision checkpoint with MXFP4 routed experts." ; "License/Terms of Use: MIT" | https://huggingface.co/nvidia/DeepSeek-V4.1-Flash-1017-NVFP4 |
| S2↑ | "createdAt": "2026-10-30T17:37:02.000Z" ; "downloads": 1473 ; "likes": 114 ; "license": "mit" ; commit "Upload DeepSeek-V4.1-Flash-1017-NVFP4" 2026-10-30T18:09:46Z | https://huggingface.co/api/models/nvidia/DeepSeek-V4.1-Flash-1017-NVFP4 |
| S3↑1↑2↑3↑4↑5↑6+2 | "WeVisCut is a 9B tool-using agent that turns knowledge articles or narration scripts into multi-minute edited videos. At each step, it reads the current editing state and selects one of 12 tools for planning, narration, asset retrieval, composition, inspection, or repair. It is not a standalone text-to-video model" ; "an NVIDIA GPU with about 24 GB of memory for bf16 inference" ; "The policy is based on Qwen3.5-9B" ; "Video quality depends on the configured retrieval, TTS, and rendering services and available templates." ; "The model weights require the WeVisCut tool environment to produce a video." ; "license: other" ; "The WeVisCut code is released under the Apache License 2.0. Model weights and third-party components are subject to their respective license terms." | https://huggingface.co/tencent/WeVisCut |
| S4↑1↑2 | "createdAt": "2026-09-09T03:19:00.000Z" ; commits "Upload model files" 2026-09-09T04:43:44Z, "Update WevisionCut 9B merged checkpoint (DAPO step 200)" 2026-09-10T09:29:50Z, "Update README.md" 2026-10-30T01:56:12Z ; "model.safetensors" size 18819722392 ; "downloads": 191 ; "likes": 18 | https://huggingface.co/api/models/tencent/WeVisCut |
| S5↑1↑2↑3 | "Twelve editing tools form the whole action space" ; "Tool_SegmentArticle | Synthesize narration" ; "Tool_RetrieveVisual |
| S6↑1↑2↑3 | "[Submitted on 28 Oct 2026]" ; "we introduce a 100-task benchmark and five metrics" ; "WeVisCut achieves an Overall Score of 90.5, compared with 89.9 for Claude Opus 5." ; "it uses 2,377 generated tokens per successful output minute, compared with 78,763 for Claude Opus 5, or approximately one thirty-third as many." ; "Relative to its base policy, WeVisCut also reduces token usage from 11,883" | https://arxiv.org/abs/2610.38352 |
| S7↑ | "title": "[Model][DSV4.1] Support MXFP4-packed Engram embedding tables" ; "state": "open" ; "merged": false (lu le 01/11/2026 vers 17:56 UTC) | https://github.com/vllm-project/vllm/pull/61530 |
| R1↑1↑2↑3↑4↑5↑6 | Nos calculs : 475 − 400 = 75 Gio, 75/475 = 15,8 % ; écarts de score −0,70 à +0,35 ; 2 377 × 10 = 23 770 et 78 763 × 10 = 787 630 jetons ; 18 819 722 392 octets ≈ 18,8 Go ; écarts AA − NVIDIA : +2,3 / −1,7 / +2,2 ; 10 min au rythme moyen du papier | — (calcul maison) |
| R2↑1↑2 | Artificial Analysis, page DeepSeek V4.1 Flash lue le 01/11/2026 vers 17:52 UTC, objet « DeepSeek V4.1 Flash 1017 (Max) » : "lcr":0.826666666666667 ; "scicode":0.559027777777778 ; "mmmuPro":0.806… ; "gpqa":null ; "ifbench":null ; aucune occurrence de « NVFP4 » ni de « WeVisCut » | https://artificialanalysis.ai/models/deepseek-v4-1-flash |
| R3 | Schéma : script Python/PIL, aucune IA générative, aucune image reprise | — |
Je ne crois pas une démo. Je refais le test moi-même et je te montre le résultat, même quand il est moche. Et ne me mets pas en colère, tu ne vas pas aimer la suite.